


Se avecinan enormes cargas de trabajo de IA: ¿qué cambios está experimentando la infraestructura de los centros de datos?
Autor Moore
Fecha 09/18/2026

A medida que las cargas de trabajo de IA se expanden entre servidores y racks, el rendimiento final de todo el sistema depende cada vez más del funcionamiento coordinado de elementos como la capacidad de cómputo, las redes, el almacenamiento, el suministro eléctrico y la refrigeración. Aunque los parámetros máximos sobre el papel son importantes, ya no representan plenamente el rendimiento efectivo, la escalabilidad ni los costes operativos generales de un clúster.
Esto obliga a todos a ampliar su perspectiva al nivel del rack y del clúster completo al planificar y evaluar la infraestructura de IA. Este cambio de mentalidad está redefiniendo el diseño, la ampliación y la implementación de las arquitecturas subyacentes de los centros de datos, haciendo que la planificación integral, la verificación a nivel de sistema y la preparación para la implementación sean más importantes que nunca. Este artículo examinará estos cambios y los desafíos prácticos que plantean para la infraestructura de IA a gran escala.
Transformación de la infraestructura de centros de datos impulsada por IA
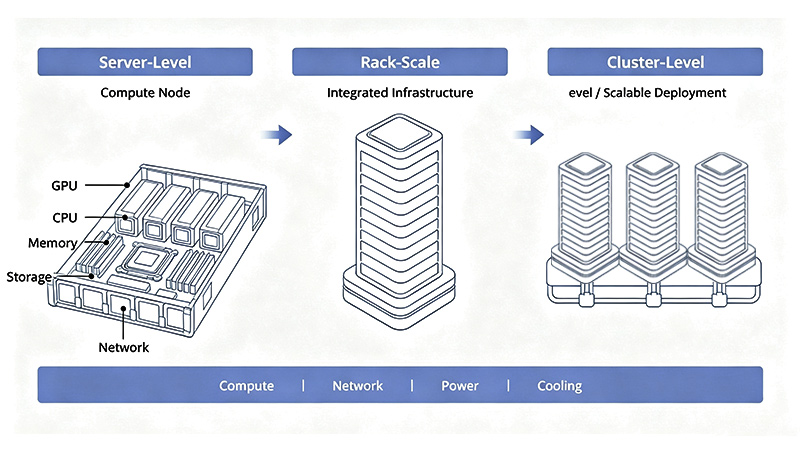
Para el entrenamiento distribuido o la inferencia a gran escala, los aceleradores deben intercambiar datos constantemente. Esto hace que la interconexión de redes, el acceso al almacenamiento, el suministro eléctrico y las capacidades de refrigeración sean extremadamente críticos para la estabilidad de todo el sistema. Por lo tanto, la planificación actual de la infraestructura hace tiempo que dejó atrás las implementaciones de un solo servidor y se ha extendido a racks de alta densidad e incluso a clústeres de varios racks. Aunque los servidores siguen siendo los nodos informáticos más básicos, los racks y los clústeres se están convirtiendo en unidades de diseño arquitectónico cada vez más fundamentales.
El GB300 NVL72 de NVIDIA es un ejemplo destacado de este enfoque de "nivel de rack". En su arquitectura de referencia empresarial, un rack GB300 NVL72 con refrigeración líquida se trata como una unidad de expansión independiente estándar que integra 18 bandejas de cómputo y 72 GPU. Para crear un conjunto de computación más grande, se pueden conectar varias unidades de nivel de rack de este tipo y ampliarlas horizontalmente mediante redes de cómputo, redes convergentes y redes de gestión dedicadas.
Esta arquitectura no puede utilizarse de manera eficiente simplemente reuniendo un conjunto de servidores de alto rendimiento. Para lograr una comunicación rápida entre nodos y facilitar el crecimiento futuro, el cableado de red, las interconexiones, la distribución de energía y las soluciones de refrigeración líquida deben integrarse en el diseño general de la infraestructura desde el principio.
Los racks de servidores de alta densidad no solo imponen enormes exigencias a la fuente de alimentación y a las capacidades de refrigeración líquida del centro de datos, sino que el tráfico masivo de este a oeste entre las GPU y los servidores también plantea un desafío mayor para el ancho de banda, la topología y la escalabilidad de la red.
Por lo tanto, al planificar clústeres de computación en la actualidad, las preguntas fundamentales ya no son sencillas:
Rendimiento de la potencia de computación de IA: las actualizaciones de hardware por sí solas no son suficientes
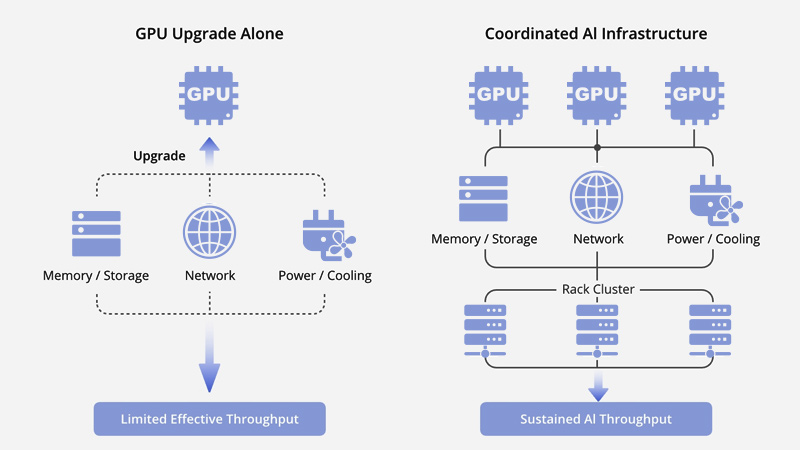
Añadir hardware de mayor rendimiento puede mejorar los sistemas de IA, pero el grado en que se materializa este valor depende de si la infraestructura subyacente puede convertir realmente las capacidades teóricas de estos dispositivos en resultados concretos durante las operaciones empresariales.
Eficiencia de la ruta de datos
El rendimiento de almacenamiento, el ancho de banda de memoria, junto con el preprocesamiento de datos y los canales de entrada, determinan colectivamente si el acelerador puede recibir datos a tiempo. Si la transmisión de datos es incluso ligeramente lenta, la atractiva potencia informática teórica de la GPU se desperdiciará. Además, el rendimiento del almacenamiento afecta directamente al guardado de puntos de control del modelo, la recuperación ante fallos, la recuperación de características y el procesamiento de datos intermedios. Por lo tanto, el estándar para medir esta capacidad no consiste en centrarse en los parámetros de un solo disco duro o módulo de memoria, sino en evaluar si toda la ruta de datos puede soportar la carga de trabajo empresarial real.
Beneficios reales de la comunicación de red
El ancho de banda anunciado por los fabricantes para tarjetas de red y los switches normalmente solo representan la capacidad física disponible y no equivalen a la velocidad real alcanzada al ejecutar aplicaciones. Desde la topología de red, la sobrecapacidad y la congestión de la red hasta los enlaces ópticos, el cableado, la configuración del software e incluso el rendimiento del propio terminal, todo afecta a la tasa de utilización real de la red por parte del clúster informático. A menudo, aunque se utilicen interfaces más rápidas para aumentar el límite de comunicación, la mejora del rendimiento en el lado de la aplicación puede no ser proporcional.
El efecto de escala de la expansión del clúster
Añadir GPU puede aumentar efectivamente la potencia informática total, pero el rendimiento empresarial no necesariamente aumentará de forma proporcional. La sobrecarga adicional de la sincronización de nodos, la programación de tareas, la colaboración entre varias máquinas y la comunicación irá absorbiendo gradualmente los beneficios del hardware recién añadido.
Por lo tanto, al diseñar la infraestructura, los parámetros máximos son sin duda un indicador imprescindible, pero deben considerarse de forma integral junto con la tasa de utilización real del acelerador, el rendimiento efectivo, la eficiencia de expansión y el tiempo final de finalización de las tareas.
A medida que la infraestructura de IA escala: varios obstáculos por delante
Ampliar la infraestructura de IA no es solo un desafío técnico, sino que también requiere un cálculo empresarial cuidadoso. Las empresas deben considerar no solo cuánta capacidad adicional pueden añadir, sino también cuánto tiempo tardará esta potencia de cálculo en desplegarse realmente y cuán eficiente será su conversión.
Los límites de la infraestructura física
Una vez que se alcanza el nivel de rack y clúster, la expansión de la red no consiste simplemente en aumentar la velocidad de la red. La densidad de puertos, la ubicación de los switches, el cableado, la distancia de transmisión de los módulos ópticos, los modelos de tráfico y los índices de sobredimensionamiento deben replantearse. Una red que funciona bien en implementaciones a pequeña escala puede requerir una revisión completa de la arquitectura a medida que el clúster crece.
La fuente de alimentación y la refrigeración también plantean limitaciones severas. Una alimentación insuficiente o una refrigeración inadecuada no solo limitarán la densidad de racks y reducirán el número de tarjetas aceleradoras instaladas, sino que también ralentizarán el proceso de expansión. Un margen de refrigeración insuficiente también puede hacer que las máquinas experimenten reducción de frecuencia o limitaciones operativas bajo cargas elevadas.
Por lo tanto, las implementaciones entre racks suelen tener consecuencias de gran alcance, que requieren ajustes en la topología de red, la arquitectura de almacenamiento, la fuente y distribución de alimentación, la refrigeración e incluso los procesos posteriores de acceso y gestión de servicios. Cómo aumentar la capacidad sin causar costes de integración desequilibrados o degradación del rendimiento es un desafío importante.
Inversión de capital y cronograma de implementación
La escala de la inversión va mucho más allá de las GPU y los servidores. Redes, almacenamiento, racks, interconexiones de comunicación óptica , diversos cables, además de la infraestructura de suministro eléctrico y refrigeración, las renovaciones del centro de datos y las herramientas de mantenimiento—: cada partida representa un gasto importante.
Además, desde la adquisición hasta el despliegue real de la potencia de cómputo, hay varias etapas: preparación del centro de datos, cableado de racks, configuración de software, pruebas de interoperabilidad, verificación empresarial y entrega final. Cualquier cuello de botella en cualquiera de estas etapas retrasará la entrega y disponibilidad de todo el clúster.
Ansiedad por la utilización del equipo y la actualización tecnológica
El valor de un clúster de IA no puede medirse únicamente por su potencia de cálculo. La utilización de los equipos, el consumo de energía, el mantenimiento diario, los costes de gestión y las máquinas infrautilizadas contribuyen al aumento de los costes operativos generales.
El rápido ritmo de iteración del hardware, con cambios acelerados en aceleradores, redes, consumo energético de un solo punto y tecnología de refrigeración líquida, está acortando constantemente el ciclo de vida de la planificación de la infraestructura. Las empresas deben encontrar un equilibrio entre sus necesidades actuales de capacidad de cómputo y los posibles riesgos de escalabilidad futura y dificultades de modificación.
Interoperabilidad entre varios proveedores
La infraestructura de IA suele consistir en un conjunto de equipos de múltiples proveedores. Tarjetas de red, switches, módulos ópticos, cables, servidores y una amplia variedad de firmware y software requieren una rigurosa verificación de compatibilidad antes de implementarse en producción.
Para minimizar los riesgos de integración y resolución de problemas, las especificaciones deben definirse con antelación, deben probarse las combinaciones certificadas y deben aclararse las responsabilidades de soporte de cada parte.
En última instancia, se trata de un juego empresarial integral: encontrar el equilibrio óptimo entre la inversión de capital, la disponibilidad de potencia de cómputo, la utilización de equipos, los costos operativos diarios y la flexibilidad a largo plazo de la arquitectura.
Infraestructura de IA a gran escala: planificación y validación
Los requisitos de infraestructura de la IA moderna están aumentando. Mucho más que seleccionar componentes individuales impulsa la selección de hardware; debe considerarse de forma integral en el contexto de la arquitectura completa del sistema y la carga de trabajo.
Planificación global
Potencia de cómputo, red, almacenamiento, además de suministro eléctrico y refrigeración—estos componentes esenciales deben planificarse de forma integral según las necesidades de su negocio, la escala de implementación, la densidad de los racks y sus planes de expansión futura.
Específicamente, la topología de red, la adecuación de las distancias de transmisión de los módulos ópticos, las rutas de cableado, la distribución de energía, los métodos de refrigeración, el acceso al almacenamiento, la distribución física del centro de datos y los planes de expansión futuros—todo debe definirse claramente con antelación. Esto ahorra muchos problemas y evita retrabajos extremadamente costosos debido a la incompatibilidad de dispositivos durante la implementación real.
Validación a nivel de sistema
Examinar únicamente las especificaciones de hardware sobre el papel es insuficiente para determinar la usabilidad de una infraestructura de IA. Para tener plena confianza, es necesaria una verificación integral a nivel de sistema, que incluye principalmente:
Compatibilidad entre diversos componentes de hardware;
Interoperabilidad fluida entre los módulos de comunicación de red y óptica;
Rendimiento sostenible del almacenamiento y de toda la ruta de datos;
Comunicación normal durante operaciones comerciales del mundo real;
Funcionamiento estable con carga completa durante períodos prolongados;
Suministro de energía estable y rendimiento de refrigeración;
Degradación de la eficiencia durante la expansión entre nodos y entre racks.
Solo al completar todo este proceso puede tener la certeza de que su infraestructura es absolutamente fiable bajo cargas del mundo real, en lugar de limitarse a obtener puntuaciones impresionantes en las pruebas de componentes individuales.
Preparación para la implementación
La preparación para la implementación no consiste solo en comprar todo el hardware. Se requiere contar con plantillas de configuración estandarizadas, listas de materiales (BOM) validadas, informes de pruebas de compatibilidad, documentación adecuada, procedimientos de instalación y responsabilidades claras de resolución de problemas—; toda esta preparación no física es necesaria para poner su clúster en línea e implementarlo lo más rápido posible.
De cara al futuro, la construcción de infraestructura de IA ya no dependerá únicamente de quién tenga las máquinas más potentes, sino de la eficacia con que se planifiquen, conecten y prueben estos dispositivos para que puedan funcionar juntos como un conjunto plenamente operativo.
Conclusión
Los centros de datos modernos de IA dejaron atrás hace mucho la era de la «optimización de dispositivos individuales» y pasaron por completo a operaciones colaborativas a nivel de sistema. Aunque los impresionantes parámetros de rendimiento máximo siguen teniendo valor, el aprovechamiento real de la capacidad de computación de IA depende cada vez más de la coordinación de la computación, la red, el almacenamiento, el suministro y la distribución de energía, la refrigeración y todo el proceso de implementación. Para las empresas, la verdadera necesidad es una arquitectura subyacente que convierta las capacidades teóricas del hardware en una capacidad empresarial real altamente flexible, confiable y rentable.
Para las necesidades de red e interconexión, QSFPTEK ofrece una solución completa que incluye switches de alta velocidad, tarjetas de interfaz de red (NIC), módulos ópticos, y cableado estructurado. Como componentes cruciales de la arquitectura a nivel de sistema, estos componentes mejoran eficazmente la compatibilidad de la red, el ancho de banda total, la escalabilidad y la preparación para el despliegue, y gestionan sin esfuerzo cargas de trabajo de IA extremadamente exigentes. Le invitamos a explorar más a fondo las soluciones de IA de QSFPTEK y a construir una base de interconexión muy flexible y rigurosamente probada para sus clústeres de computación.


compartir
