


¿Qué es una fábrica de IA? Y por qué la óptica 800G/1.6T es su columna vertebral
Autor Moore
Fecha 03/20/2026

El cambio de centros de datos a fábricas de IA
Algo ha cambiado silenciosamente en la forma en que se está construyendo la infraestructura. No hace mucho, un centro de datos se centraba principalmente en el almacenamiento, la virtualización y la gestión de solicitudes de usuarios. Ahora se siente diferente. Las cargas de trabajo son más pesadas, más continuas y, en muchos casos, ni siquiera están vinculadas a acciones directas de los usuarios. Los sistemas de IA se ejecutan en segundo plano, generando, razonando, iterando, a veces recorriendo tareas que nunca realmente “terminan” en el sentido tradicional.
El concepto de la “fábrica de IA” ya no es solo una palabra de moda; cada vez se está convirtiendo más en una realidad. Los datos se introducen en grandes modelos para su procesamiento y la generación continua de resultados. Este sistema se asemeja más a un sistema industrial que a una arquitectura de TI. Tal como pretendía NVIDIA cuando lanzó la plataforma Rubin, el objetivo es completar esta revolución arquitectónica. Los desafíos a los que nos enfrentamos hoy van más allá de las capacidades del hardware. A nivel de infraestructura, debemos considerar cómo construir un sistema capaz de admitir la producción de IA a gran escala, al tiempo que se reducen los costos de inferencia y se mejora la previsibilidad de la implementación.
Una vez que la infraestructura empieza a comportarse como una fábrica, la presión se extiende por toda la pila. La computación es solo una parte de ello. El almacenamiento, la memoria, la programación, la orquestación y, especialmente, las redes empiezan a importar de distintas maneras. No solo necesita rendimiento—necesita consistencia bajo carga y la capacidad de escalar sin que todo se vuelva frágil.
Dentro de la plataforma Rubin: un tipo diferente de diseño de sistemas
Al observar Rubin más de cerca, no sigue realmente el antiguo patrón de actualización incremental. Se parece más a un reinicio. En lugar de mejorar componentes aislados, la plataforma reúne varias capas y las optimiza como un todo. La CPU Vera, la GPU Rubin, NVLink 6, ConnectX-9 SuperNIC, BlueField-4 DPU y Spectrum-6 Ethernet forman parte de ese diseño.
Este tipo de coordinación cambia la forma en que se comportan los sistemas. Por ejemplo, las cargas de trabajo de entrenamiento MoE ahora requieren significativamente menos GPU en comparación con generaciones anteriores, pero eso no reduce la actividad general. Simplemente la redistribuye. La inferencia se vuelve más frecuente, los modelos se vuelven más complejos y las cargas de trabajo se extienden a lo largo de secuencias más largas. El sistema termina moviendo más datos, no menos.
El sistema a escala de rack NVL72 es un buen ejemplo. Integrar decenas de GPU en una unidad estrechamente integrada parece eficiente—y lo es—, pero también crea patrones de comunicación densos dentro del rack. Los datos ya no solo fluyen hacia arriba y hacia abajo. Se mueven constantemente de forma lateral entre GPU, pools de memoria y aceleradores. Esa presión interna acaba extendiéndose a la red más amplia.
Por qué las fábricas de IA someten a la red a estrés de una forma diferente
La red dentro de una AI Factory es lo bastante diferente como para que las suposiciones anteriores empiecen a fallar. No se trata solo de que haya una mayor demanda de ancho de banda. El patrón de tráfico cambia. El tráfico este-oeste es lo principal, y normalmente se mantiene alto en lugar de fluctuar. Las GPU intercambian datos constantemente, especialmente en escenarios de entrenamiento distribuido e inferencia de varios pasos. La latencia se vuelve más visible, no en teoría, sino en el rendimiento real.
Al mismo tiempo, las tecnologías subyacentes avanzan rápidamente. NVLink 6, por ejemplo, lleva el ancho de banda de GPU a GPU a un nivel en el que cada dispositivo puede manejar varios terabytes por segundo. Dentro de un solo rack, el ancho de banda agregado asciende a cientos de terabytes por segundo. Eso no es un pequeño avance—es una escala completamente diferente.
En el campo de Ethernet, NVIDIA Spectrum-X está transformando la forma en que se construyen las redes de IA. En lugar de tratar Ethernet como una infraestructura de uso general, se está ajustando específicamente para cargas de trabajo de IA. Las mejoras de eficiencia son evidentes, pero lo que destaca aún más es la estabilidad bajo carga sostenida. Los clústeres de IA no permanecen inactivos mucho tiempo, por lo que el tiempo de actividad y la consistencia empiezan a importar tanto como el rendimiento máximo.
También está BlueField-4 en la mezcla, que desplaza algunas funciones de manejo de datos y seguridad fuera de la CPU. No siempre recibe tanta atención, pero en implementaciones a gran escala ayuda a mantener las cosas manejables. Y con el avance hacia el almacenamiento nativo de IA, donde el contexto de inferencia puede reutilizarse entre sesiones, el sistema en conjunto empieza a parecerse menos a un montón de servidores y más a una canalización coordinada.
Todo esto conduce a una observación sencilla. La red es hoy en día más que solo un conector entre nodos informáticos. Se convierte en parte del propio proceso de computación. Y una vez que eso sucede, las limitaciones de los diseños más antiguos—especialmente aquellos basados en supuestos de 400G—se vuelven más evidentes.
400G vs 800G vs 1.6T: qué cambia realmente y por qué importa
Pasando de 400G a 800G, o incluso 1.6T, podría parecer una simple actualización de velocidad. En realidad, las diferencias van más allá de las cifras de ancho de banda.
400G todavía tiene su lugar. Está ampliamente implementado, es relativamente maduro y funciona bien en entornos con patrones de tráfico predecibles o donde el tráfico no está constantemente saturado. Para cargas de trabajo tradicionales en la nube, o incluso clústeres de IA más pequeños, todavía puede ofrecer un equilibrio razonable entre costo y rendimiento. El problema es que las AI Factories ya no se comportan así. El tráfico es más denso, más continuo y menos tolerante cuando aparecen cuellos de botella.
800G empieza a tener más sentido cuando las arquitecturas de conmutadores se orientan hacia SerDes de 200G. En lugar de combinar un montón de enlaces más lentos, se obtiene una conexión más clara entre la capacidad del conmutador y las interfaces ópticas. Esto puede simplificar las cosas en algunas situaciones, pero, más importante aún, aumenta la productividad general sin necesitar más espacio. En grandes clústeres de GPU, ese tipo de eficiencia se acumula rápidamente.
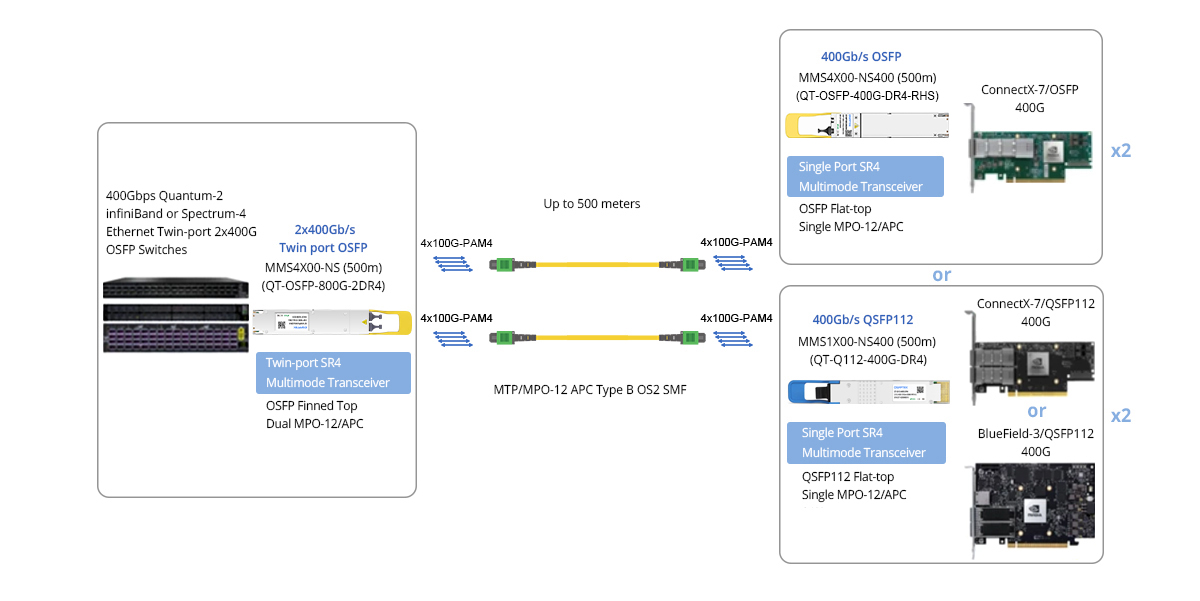
El 800G NVIDIA/Mellanox MMS4X00-NS es compatible con switches Quantum-2 y Spectrum-4 refrigerados por aire, sistemas refrigerados por líquido y DGX-H100, DPU ConnectX-7 y BlueField-3.
Luego está el 1.6T, que realmente no se siente como una actualización, sino más bien como si se estuvieran preparando para el siguiente paso. Permite una mayor densidad de puertos, lo que significa que se necesitan menos switches para lograr la misma escala. La eficiencia energética por bit también mejora, lo cual es importante a medida que el consumo de energía empieza a limitar la expansión. En implementaciones de IA muy grandes—piense en decenas o cientos de miles de GPU—la diferencia entre escalar con 800G y dar el salto a 1.6T no es solo técnica; también afecta los modelos de costos y la disposición física.
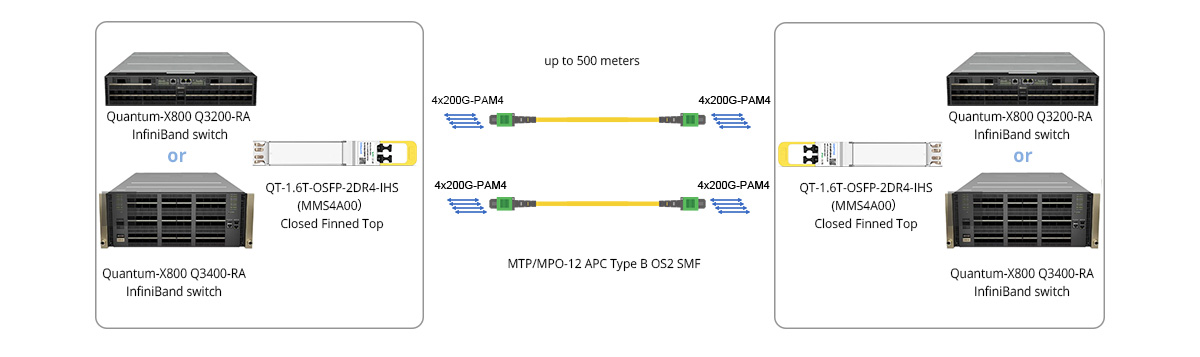
El NVIDIA/Mellanox MMS4A00 de 1.6T es compatible con switches Quantum-3 refrigerados por aire y refrigerados por líquido.
En la práctica, estas opciones no se reemplazan entre sí de la noche a la mañana. Por lo general, conviven. 400G aún podría utilizarse en el borde o en segmentos menos exigentes. 800G se está convirtiendo en la estructura principal para los clústeres de IA actuales. 1.6T empieza a aparecer en nuevas implementaciones o en partes de la red donde la densidad y la eficiencia son más importantes. La "mejor" opción depende menos de la hoja de especificaciones y más de cómo se espera que el sistema cambie con el tiempo.
Aquí también es donde los proveedores de soluciones pueden ayudar. QSFPTEK, por ejemplo, tiene 800G y módulos ópticos 1.6T, así como formas de configurarlos que funcionen bien para centros de datos de IA. El enfoque está en cómo estos niveles encajan en arquitecturas reales, no solo en los niveles de velocidad. En algunos casos, mezclar generaciones dentro de la misma red puede generar mejores resultados que imponer una actualización completa de una sola vez.
Mirando hacia el futuro: por qué 1.6T está más cerca de lo que parece
Aunque 800G se está volviendo más común, no parece que sea la versión final. Las cargas de trabajo de IA están creciendo, pero no siempre de la misma manera. Los modelos se están haciendo más grandes, pero también se están volviendo más interactivos. La inferencia ya no es un simple ciclo de solicitud-respuesta. Puede implicar múltiples pasos, herramientas externas y ventanas de contexto más largas. Todo eso aumenta la cantidad de datos que se mueven por el sistema.
También está la cuestión de la escala más allá de una sola ubicación. Algunas de las arquitecturas más recientes están diseñadas para conectar varios centros de datos en un único entorno lógico. Eso añade la distancia a la ecuación, junto con nuevos desafíos de latencia y sincronización.
La óptica 1.6T encaja en este panorama de forma bastante natural. No lo resuelve todo, pero elimina algunas de las limitaciones inmediatas relacionadas con el ancho de banda y la densidad. En lugar de trabajar constantemente alrededor de los límites, el diseño de red vuelve a ser un poco más flexible. Eso por sí solo puede simplificar las implementaciones a gran escala.
Conclusión
QSFPTEK se ha estado preparando para este tipo de escenario con su cartera 1.6T, así como con otras soluciones de infraestructura de IA. No se trata de ir siempre tan rápido como se pueda. Se trata más bien de tener la opción lista cuando la red llegue a un punto en el que las actualizaciones incrementales no sean suficientes.
Al final, la idea de una fábrica de IA vuelve a centrarlo todo en el flujo—cómo se mueven los datos, a qué velocidad se mueven y con qué fiabilidad llegan de un lugar a otro. Los módulos ópticos no suelen recibir mucha atención, pero se encuentran justo en esa ruta. Y, a medida que el resto del sistema sigue escalando, su papel se vuelve más difícil de ignorar.


compartir
