


Stanno arrivando carichi di lavoro IA massicci: cosa sta cambiando nell'infrastruttura dei data center?
Autore Moore
Data 09/18/2026

Con l'espansione dei carichi di lavoro IA tra server e rack, le prestazioni finali dell'intero sistema dipendono sempre più dal funzionamento coordinato di elementi quali potenza di calcolo, rete, storage, alimentazione e raffreddamento. Sebbene i parametri di picco sulla carta siano importanti, non rappresentano più pienamente il throughput effettivo, la scalabilità o i costi operativi complessivi di un cluster.
Questo costringe tutti a elevare la propria prospettiva al livello del rack e dell'intero cluster quando si pianifica e si valuta l'infrastruttura AI. Questo cambiamento di mentalità sta rimodellando la progettazione, l'espansione e l'implementazione delle architetture sottostanti dei data center, rendendo la pianificazione completa, la verifica a livello di sistema e la preparazione all'implementazione più cruciali che mai. Questo articolo esaminerà questi cambiamenti e le sfide pratiche che portano all'infrastruttura AI su larga scala.
Trasformazione dell'infrastruttura dei data center guidata dall'IA
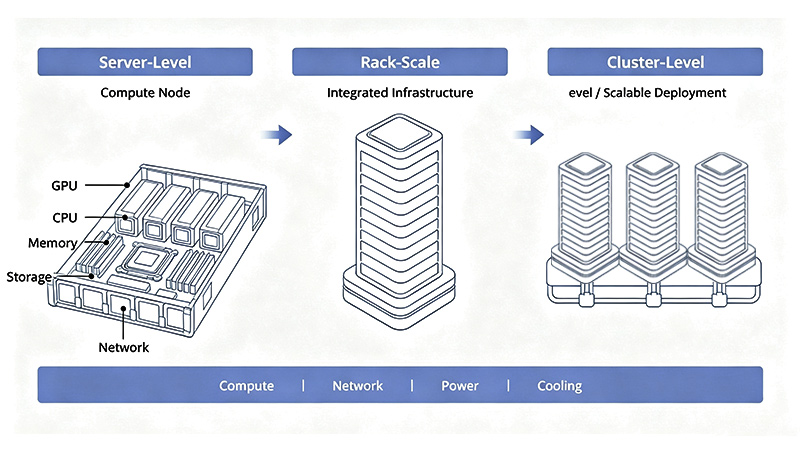
Per l'addestramento distribuito o l'inferenza su larga scala, gli acceleratori devono scambiare dati costantemente. Ciò rende l'interconnessione di rete, l'accesso allo storage, l'alimentazione e le capacità di raffreddamento estremamente critici per la stabilità dell'intero sistema. Pertanto, l'attuale pianificazione dell'infrastruttura si è ormai spinta ben oltre le implementazioni su singolo server, estendendosi a rack ad alta densità e persino a cluster multi-rack. Sebbene i server rimangano i nodi di calcolo più basilari, rack e cluster stanno diventando unità di progettazione architetturale sempre più centrali.
GB300 NVL72 di NVIDIA è un esempio significativo di questo approccio "a livello di rack". Nella loro architettura di riferimento aziendale, un rack GB300 NVL72 raffreddato a liquido viene trattato come un'unità di espansione indipendente standard, che integra 18 tray di calcolo e 72 GPU. Per creare un pool di calcolo più ampio, è possibile collegare e ampliare orizzontalmente più unità di questo tipo a livello di rack tramite reti di calcolo dedicate, reti convergenti e reti di gestione.
Questa architettura non può essere utilizzata in modo efficiente semplicemente mettendo insieme un gruppo di server ad alte prestazioni. Per una comunicazione rapida tra nodi e una facile crescita futura, il cablaggio di rete, le interconnessioni, l'alimentazione e le soluzioni di raffreddamento a liquido devono essere integrati fin dall'inizio nella progettazione complessiva dell'infrastruttura.
I rack server ad alta densità non solo impongono enormi requisiti all'alimentazione e alle capacità di raffreddamento a liquido del data center, ma il massiccio traffico est-ovest tra GPU e server pone anche una sfida maggiore alla larghezza di banda, alla topologia e alla scalabilità della rete.
Pertanto, quando oggi si pianificano cluster di calcolo, le domande fondamentali non sono più semplici:
Prestazioni della potenza di calcolo dell'IA: i soli aggiornamenti hardware non sono sufficienti
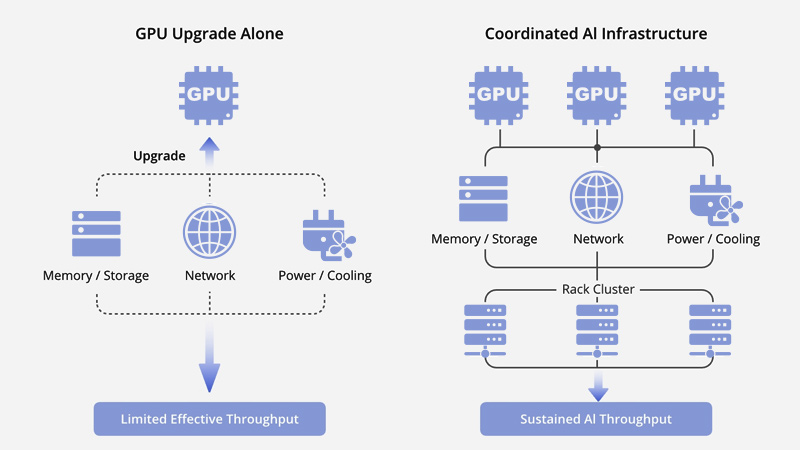
L'aggiunta di hardware dalle prestazioni superiori può effettivamente migliorare i sistemi di intelligenza artificiale, ma il grado in cui questo valore viene realizzato dipende dalla capacità dell'infrastruttura sottostante di tradurre realmente le capacità teoriche di questi dispositivi in risultati concreti durante le operazioni aziendali.
Efficienza del percorso dati
Il throughput dello storage, la larghezza di banda della memoria, insieme alla pre-elaborazione dei dati e ai canali di input, determinano collettivamente se l'acceleratore può ricevere i dati in tempo. Se la trasmissione dei dati è anche solo leggermente lenta, l'allettante potenza di calcolo teorica della GPU verrà sprecata. Inoltre, le prestazioni dello storage influiscono direttamente sul checkpointing del modello, sul ripristino in caso di guasto, sul recupero delle feature e sull'elaborazione dei dati intermedi. Pertanto, lo standard per misurare questa capacità non consiste nel concentrarsi sui parametri di un singolo disco rigido o modulo di memoria, ma nel valutare se l'intero percorso dei dati può supportare il carico di lavoro aziendale effettivo.
Vantaggi effettivi della comunicazione di rete
La larghezza di banda dichiarata dai produttori per schede di rete e gli switch di solito rappresentano solo la capacità fisica disponibile e non equivalgono alla velocità effettiva raggiunta durante l'esecuzione delle applicazioni. Dalla topologia di rete, dalla sovracapacità e dalla congestione della rete ai collegamenti ottici, al cablaggio, alla configurazione software e persino alle prestazioni del terminale stesso, tutto influisce sul tasso di utilizzo effettivo della rete da parte del cluster di calcolo. Spesso, anche se vengono utilizzate interfacce più veloci per aumentare il limite di comunicazione, il miglioramento delle prestazioni lato applicazione potrebbe non essere proporzionale.
L'effetto della scalabilità dell'espansione del cluster
L'aggiunta di GPU può effettivamente aumentare la potenza di calcolo totale, ma le prestazioni aziendali non aumenteranno necessariamente in modo proporzionale. L'overhead aggiuntivo della sincronizzazione dei nodi, della pianificazione delle attività, della collaborazione tra più macchine e della comunicazione consumerà gradualmente i vantaggi del nuovo hardware aggiunto.
Pertanto, nella progettazione dell'infrastruttura, i parametri di picco sono certamente un indicatore da considerare, ma devono essere valutati in modo completo insieme al tasso di utilizzo effettivo dell'acceleratore, al throughput effettivo, all'efficienza di espansione e al tempo finale di completamento dell'attività.
Con la scalabilità dell'infrastruttura AI: diversi ostacoli all'orizzonte
L'espansione dell'infrastruttura di IA non è solo una sfida tecnica, ma richiede anche un'attenta valutazione aziendale. Le aziende devono considerare non solo quanta capacità aggiuntiva possono aggiungere, ma anche quanto tempo sarà necessario affinché questa potenza di calcolo venga effettivamente implementata e quanto sarà efficiente la sua conversione.
I limiti dell'infrastruttura fisica
Una volta raggiunto il livello di rack e cluster, l'espansione della rete non consiste semplicemente nell'aumentare la velocità della rete. Densità delle porte, posizionamento degli switch, cablaggio, distanza di trasmissione dei moduli ottici, modelli di traffico e rapporti di sovradimensionamento devono essere tutti ripianificati. Una rete che funziona bene in implementazioni su piccola scala può richiedere una revisione completa dell'architettura man mano che il cluster cresce.
Anche l'alimentazione e il raffreddamento pongono limitazioni significative. Un'alimentazione insufficiente o un raffreddamento inadeguato non solo limiteranno la densità dei rack e ridurranno il numero di schede acceleratrici installate, ma rallenteranno anche il processo di espansione. Un margine di raffreddamento insufficiente può inoltre causare la riduzione della frequenza o limitazioni operative delle macchine sotto carichi elevati.
Pertanto, le implementazioni cross-rack hanno spesso conseguenze di vasta portata, richiedendo modifiche alla topologia di rete, all'architettura di storage, all'alimentazione e distribuzione elettrica, al raffreddamento e persino ai successivi processi di accesso ai servizi e gestione. Come aumentare la capacità senza causare costi di integrazione sbilanciati o degrado delle prestazioni è una grande sfida.
Investimento di capitale e tempistiche di implementazione
La portata dell'investimento va ben oltre GPU e server. Networking, storage, rack, interconnessioni di comunicazione ottiche , vari cavi, oltre all'infrastruttura di alimentazione e raffreddamento, alle ristrutturazioni del data center e agli strumenti di manutenzione—ogni voce rappresenta una spesa significativa.
Inoltre, dall'approvvigionamento fino all'effettiva implementazione della potenza di calcolo, sono previste diverse fasi: preparazione del data center, cablaggio dei rack, configurazione del software, test di interoperabilità, verifica aziendale e consegna finale. Qualsiasi collo di bottiglia in una di queste fasi ritarderà la consegna e la disponibilità dell'intero cluster.
Ansia relativa all'utilizzo delle apparecchiature e all'aggiornamento tecnologico
Il valore di un cluster di intelligenza artificiale non può essere misurato esclusivamente dalla sua potenza di calcolo. L'utilizzo delle apparecchiature, il consumo energetico, la manutenzione quotidiana, i costi di gestione e le macchine sottoutilizzate contribuiscono tutti all'aumento dei costi operativi complessivi.
Il rapido ritmo di iterazione dell'hardware, con cambiamenti frequenti negli acceleratori, nelle reti, nel consumo energetico per singolo punto e nella tecnologia di raffreddamento a liquido, sta accorciando costantemente il ciclo di vita della pianificazione dell'infrastruttura. Le aziende devono trovare un equilibrio tra le attuali esigenze di capacità di calcolo e i potenziali rischi legati alla scalabilità futura e alle difficoltà di modifica.
Interoperabilità tra più fornitori
L'infrastruttura AI è generalmente costituita da una raccolta di apparecchiature di più fornitori. Schede di rete, switch, moduli ottici, cavi, server e un'ampia varietà di firmware e software richiedono tutti una rigorosa verifica della compatibilità prima di essere implementati in produzione.
Per ridurre al minimo i rischi di integrazione e risoluzione dei problemi, le specifiche dovrebbero essere definite tempestivamente, le combinazioni certificate dovrebbero essere testate e le responsabilità di supporto di ciascuna parte dovrebbero essere chiarite.
In definitiva, si tratta di un gioco aziendale completo: trovare l'equilibrio ottimale tra investimento di capitale, disponibilità della potenza di calcolo, utilizzo delle apparecchiature, costi operativi giornalieri e flessibilità a lungo termine dell'architettura.
Infrastruttura AI su larga scala: pianificazione e convalida
I requisiti dell'infrastruttura per l'AI moderna stanno aumentando. Ben più che selezionare singoli componenti guida la scelta dell'hardware; questa deve essere considerata in modo olistico nel contesto dell'intera architettura del sistema e del carico di lavoro.
Pianificazione globale
Potenza di calcolo, rete, storage, oltre all'alimentazione e al raffreddamento—questi componenti fondamentali devono essere pianificati in modo olistico in base alle esigenze aziendali, alla scala di implementazione, alla densità dei rack e ai piani di espansione futuri.
In particolare, la topologia di rete, l'adeguatezza delle distanze di trasmissione dei moduli ottici, i percorsi dei cavi, la distribuzione dell'alimentazione, i metodi di raffreddamento, l'accesso allo storage, la disposizione fisica del data center e i piani di espansione futuri— devono essere tutti chiaramente definiti in anticipo. Ciò consente di evitare notevoli difficoltà e costose rilavorazioni dovute all'incompatibilità dei dispositivi durante l'implementazione effettiva.
Validazione a livello di sistema
Esaminare esclusivamente sulla carta le specifiche hardware non è sufficiente per determinare l'utilizzabilità di un'infrastruttura AI. Per avere piena fiducia, è necessaria una verifica completa a livello di sistema, che includa principalmente:
Compatibilità tra vari componenti hardware;
Interoperabilità fluida tra i moduli di rete e di comunicazione ottica;
Prestazioni sostenibili dello storage e dell'intero percorso dei dati;
Comunicazione normale durante le operazioni aziendali reali;
Funzionamento stabile a pieno carico per periodi prolungati;
Alimentazione stabile e prestazioni di raffreddamento;
Degrado dell'efficienza durante l'espansione tra nodi e tra rack.
Solo completando questo intero processo puoi essere certo che la tua infrastruttura sia assolutamente affidabile sotto carichi reali, invece di ottenere semplicemente punteggi impressionanti nei test dei singoli componenti.
Prontezza per la distribuzione
La predisposizione alla distribuzione non consiste semplicemente nell'acquistare tutto l'hardware. Per portare il cluster online e distribuirlo il più rapidamente possibile, sono necessarie configurazioni standardizzate, distinte base (BOM) validate, rapporti sui test di compatibilità, documentazione adeguata, procedure di installazione e responsabilità chiare per la risoluzione dei problemi—tutta questa predisposizione software.
Guardando al futuro, il processo di costruzione dell'infrastruttura per l'IA non dipenderà più esclusivamente da chi dispone delle macchine più potenti, ma piuttosto da quanto efficacemente questi dispositivi vengono pianificati, collegati e testati affinché possano funzionare insieme come un insieme pienamente operativo.
Conclusione
I moderni data center per l'IA hanno superato da tempo l'era dell'"ottimizzazione dei dispositivi singoli", passando interamente a operazioni collaborative a livello di sistema. Sebbene gli impressionanti parametri delle prestazioni di picco mantengano ancora il loro valore, l'effettivo utilizzo della potenza di calcolo per l'IA dipende sempre più dal coordinamento tra potenza di calcolo, rete, storage, alimentazione e distribuzione elettrica, raffreddamento e l'intero processo di implementazione. Per le aziende, la reale necessità è un'architettura sottostante che trasformi le capacità teoriche dell'hardware in una capacità aziendale effettiva altamente flessibile, affidabile ed economica.
Per le esigenze di rete e interconnessione, QSFPTEK fornisce una soluzione completa, inclusi switch ad alta velocità, schede di interfaccia di rete (NIC), moduli ottici, e cablaggio strutturato. In quanto componenti cruciali dell'architettura a livello di sistema, questi componenti migliorano efficacemente la compatibilità complessiva della rete, la larghezza di banda totale, la scalabilità e la prontezza all'implementazione, gestendo senza sforzo carichi di lavoro di IA estremamente impegnativi. Ti invitiamo a esplorare ulteriormente le soluzioni di IA di QSFPTEK e a costruire una base di interconnessione altamente flessibile e rigorosamente collaudata per i tuoi cluster di elaborazione.


Condividi
