


Che cos'è una fabbrica di IA? E perché le ottiche 800G/1.6T ne sono la spina dorsale
Autore Moore
Data 03/20/2026

Il passaggio dai data center alle fabbriche di IA
Qualcosa è cambiato silenziosamente nel modo in cui vengono costruite le infrastrutture. Non molto tempo fa, un data center riguardava principalmente lo storage, la virtualizzazione e la gestione delle richieste degli utenti. Ora sembra diverso. I carichi di lavoro sono più pesanti, più continui e in molti casi non sono nemmeno legati ad azioni dirette degli utenti. I sistemi di AI operano in background, generando, ragionando, iterando, a volte attraversando cicli di attività che non “finiscono” mai davvero nel senso tradizionale.
Il concetto di “fabbrica di IA” non è più soltanto una parola di moda; sta diventando sempre più una realtà. I dati vengono inseriti in modelli di grandi dimensioni per l'elaborazione e la generazione continua di output. Questo sistema assomiglia più a un sistema industriale che a un'architettura IT. Proprio come NVIDIA intendeva quando ha lanciato la piattaforma Rubin, l'obiettivo è completare questa rivoluzione architetturale. Le sfide che affrontiamo oggi vanno oltre le capacità dell'hardware. A livello di infrastruttura, dobbiamo considerare come costruire un sistema in grado di supportare la produzione di IA su larga scala, riducendo al contempo i costi di inferenza e migliorando la prevedibilità dell'implementazione.
Una volta che l'infrastruttura inizia a comportarsi come una fabbrica, la pressione si diffonde su tutto lo stack. Il calcolo è solo una parte. Storage, memoria, scheduling, orchestrazione e, soprattutto, networking iniziano tutti a contare in modi diversi. Non serve solo performance—serve coerenza sotto carico e la capacità di scalare senza che tutto diventi fragile.
Dentro la piattaforma Rubin: un diverso tipo di progettazione di sistema
Osservando Rubin più da vicino, non segue davvero il vecchio modello di aggiornamento incrementale. Sembra più un ripristino. Invece di migliorare componenti isolati, la piattaforma riunisce più livelli e li ottimizza nel loro insieme. La CPU Vera, la GPU Rubin, NVLink 6, ConnectX-9 SuperNIC, BlueField-4 DPU e Spectrum-6 Ethernet fanno tutti parte di questo progetto.
Questo tipo di coordinamento cambia il modo in cui i sistemi si comportano. Ad esempio, i carichi di lavoro di addestramento MoE ora richiedono un numero significativamente inferiore di GPU rispetto alle generazioni precedenti, ma ciò non riduce l'attività complessiva. La redistribuisce soltanto. L'inferenza diventa più frequente, i modelli diventano più complessi e i carichi di lavoro si estendono su sequenze più lunghe. Il sistema finisce per spostare più dati, non meno.
Il sistema NVL72 su scala rack ne è un buon esempio. Integrare decine di GPU in un'unità strettamente integrata sembra efficiente—e lo è—, ma crea anche schemi di comunicazione densi all'interno del rack. I dati non fluiscono più solo verso l'alto e verso il basso. Si spostano costantemente lateralmente tra GPU, pool di memoria e acceleratori. Questa pressione interna alla fine si riversa nella rete più ampia.
Perché le fabbriche di IA sollecitano la rete in modo diverso
La rete all'interno di un'AI Factory è sufficientemente diversa da far sì che le vecchie supposizioni inizino a non valere più. Non si tratta solo di una maggiore richiesta di larghezza di banda. Il modello di traffico cambia. Il traffico est-ovest è l'elemento principale e di solito rimane elevato anziché fluttuare. Le GPU scambiano costantemente dati, soprattutto negli scenari di addestramento distribuito e inferenza in più fasi. La latenza diventa più evidente, non in teoria ma nelle prestazioni effettive.
Allo stesso tempo, le tecnologie sottostanti avanzano rapidamente. NVLink 6, ad esempio, spinge la larghezza di banda da GPU a GPU a un livello in cui ogni dispositivo può gestire diversi terabyte al secondo. All'interno di un singolo rack, la larghezza di banda aggregata sale a centinaia di terabyte al secondo. Non è un piccolo passo avanti—è una scala completamente diversa.
Nel campo dell'Ethernet, NVIDIA Spectrum-X sta trasformando il modo in cui vengono costruite le reti AI. Invece di trattare Ethernet come un fabric generico, viene ottimizzato specificamente per i carichi di lavoro AI. I miglioramenti dell'efficienza sono evidenti, ma ciò che risalta maggiormente è la stabilità sotto carico sostenuto. I cluster AI non restano molto inattivi, quindi uptime e coerenza iniziano a contare tanto quanto le prestazioni di picco.
Nel mix c'è anche BlueField-4, che sposta alcune funzioni di gestione dei dati e di sicurezza dalla CPU. Non riceve sempre la stessa attenzione, ma nelle implementazioni su larga scala aiuta a mantenere le cose gestibili. E con il passaggio allo storage AI-native, in cui il contesto di inferenza può essere riutilizzato tra le sessioni, il sistema complessivo inizia ad assomigliare meno a un insieme di server e più a una pipeline coordinata.
Tutto ciò porta a una semplice osservazione. Oggi la rete è più di un semplice connettore tra nodi di computer. Diventa parte del processo di calcolo stesso. E una volta che ciò accade, i limiti dei design più datati—in particolare quelli basati su presupposti 400G—diventano più evidenti.
400G vs 800G vs 1.6T: cosa cambia davvero e perché è importante
Passando da 400G a 800G, o persino 1.6T, potrebbe sembrare un semplice aggiornamento di velocità. In realtà, le differenze vanno oltre i numeri della larghezza di banda.
400G ha ancora il suo ruolo. È ampiamente implementato, relativamente maturo e funziona bene in ambienti con modelli di traffico prevedibili o in cui il traffico non è costantemente saturo. Per i carichi di lavoro cloud tradizionali, o persino per cluster AI più piccoli, può ancora offrire un equilibrio ragionevole tra costo e prestazioni. Il problema è che le AI Factories non si comportano più così. Il traffico è più denso, più continuo e meno tollerante quando compaiono colli di bottiglia.
800G inizia ad avere più senso quando le architetture degli switch si spostano verso SerDes 200G. Invece di combinare molti collegamenti più lenti, si ottiene una connessione più chiara tra la capacità dello switch e le interfacce ottiche. Questo può semplificare le cose in alcune situazioni, ma soprattutto aumenta la produttività complessiva senza richiedere più spazio. Nei grandi cluster GPU, questo tipo di efficienza si accumula rapidamente.
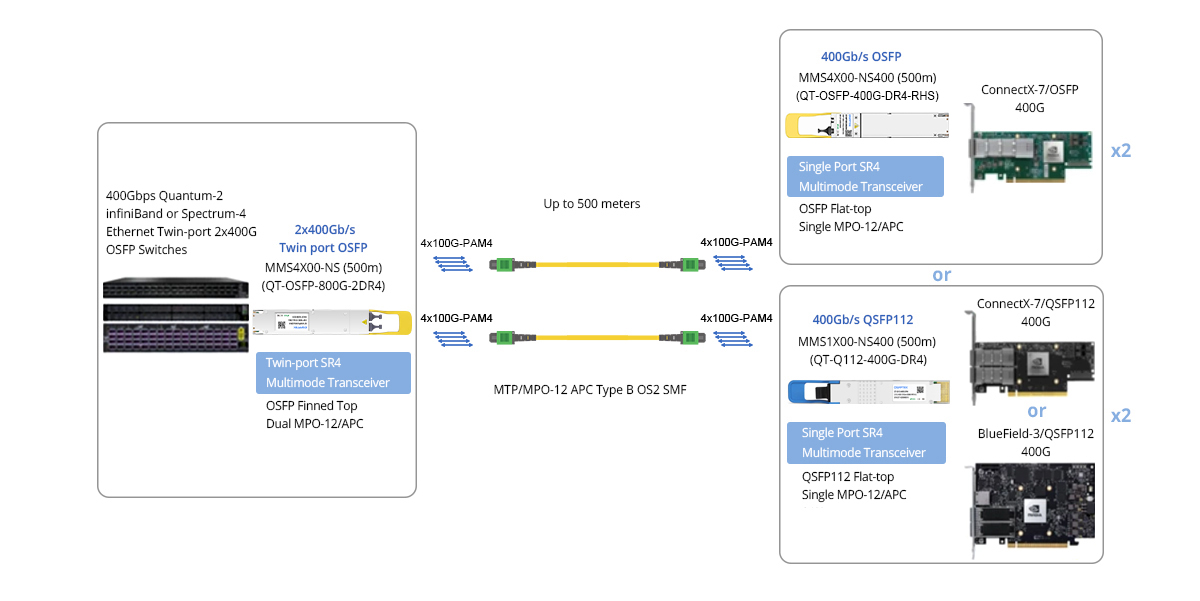
Il 800G NVIDIA/Mellanox MMS4X00-NS è compatibile con switch Quantum-2 e Spectrum-4 raffreddati ad aria, sistemi raffreddati a liquido e DGX-H100, DPU ConnectX-7 e BlueField-3.
Poi c'è l'1.6T, che non sembra davvero un aggiornamento, ma piuttosto che si stiano preparando per il passo successivo. Consente una maggiore densità di porte, il che significa che sono necessari meno switch per raggiungere la stessa scala. Anche l'efficienza energetica per bit migliora, il che è importante poiché il consumo energetico inizia a limitare l'espansione. In implementazioni AI molto grandi—pensa a decine o centinaia di migliaia di GPU—la differenza tra scalare con 800G e passare a 1.6T non è solo tecnica; influisce anche sui modelli di costo e sul layout fisico.
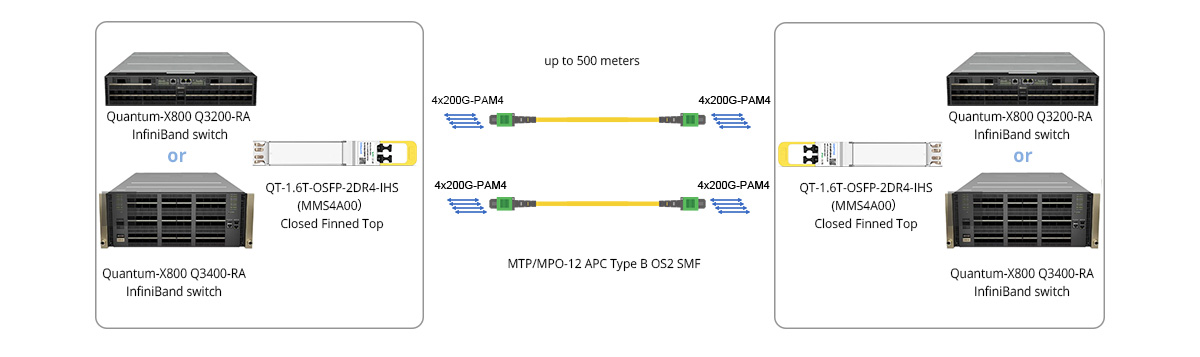
Il 1.6T NVIDIA/Mellanox MMS4A00 è compatibile con gli switch Quantum-3 raffreddati ad aria e a liquido.
In pratica, queste opzioni non si sostituiscono l'una all'altra dall'oggi al domani. Di solito coesistono. Il 400G potrebbe essere ancora utilizzato all'edge o in segmenti meno esigenti. L'800G sta diventando il fabric principale per gli attuali cluster AI. L'1.6T inizia a comparire nelle nuove implementazioni o in parti della rete in cui densità ed efficienza contano di più. La scelta "migliore" dipende meno dalla scheda tecnica e più da come si prevede che il sistema cambi nel tempo.
Questo è anche il punto in cui i fornitori di soluzioni possono aiutare. QSFPTEK, ad esempio, offre 800G e moduli ottici 1.6T, nonché modi per configurarli che funzionano bene per i data center AI. L'attenzione è rivolta a come questi livelli si inseriscono nelle architetture reali, non solo ai livelli di velocità. In alcuni casi, combinare generazioni diverse all'interno della stessa rete può portare a risultati migliori rispetto a imporre un aggiornamento completo tutto in una volta.
Guardando al futuro: perché 1.6T è più vicino di quanto sembri
Sebbene 800G stia diventando più comune, non sembra essere la versione finale. I carichi di lavoro AI stanno crescendo, ma non sempre nello stesso modo. I modelli stanno diventando più grandi, ma anche più interattivi. L'inferenza non è più un semplice ciclo richiesta-risposta. Può comportare più passaggi, strumenti esterni e finestre di contesto più lunghe. Tutto ciò aumenta la quantità di dati che si muove attraverso il sistema.
C'è anche la questione della scalabilità oltre una singola sede. Alcune delle architetture più recenti sono progettate per collegare più data center in un unico ambiente logico. Questo aggiunge la distanza all'equazione, insieme a nuove sfide di latenza e sincronizzazione.
Le ottiche 1.6T si inseriscono in questo quadro in modo abbastanza naturale. Non risolvono tutto, ma eliminano alcuni dei vincoli immediati relativi a larghezza di banda e densità. Invece di dover aggirare continuamente i limiti, la progettazione della rete torna a essere un po' più flessibile. Questo da solo può semplificare le implementazioni su larga scala.
Conclusione
QSFPTEK si sta preparando a questo tipo di scenario con il suo portfolio 1.6T, nonché con altre soluzioni per infrastrutture AI. Non si tratta di andare sempre il più velocemente possibile. Si tratta piuttosto di avere l'opzione pronta quando la rete raggiunge un punto in cui gli aggiornamenti incrementali non sono sufficienti.
Alla fine, l'idea di una AI Factory riporta tutto al flusso—come si muovono i dati, quanto velocemente si muovono e con quanta affidabilità arrivano da un luogo all'altro. I moduli ottici di solito non ricevono molta attenzione, ma si trovano proprio in quel percorso. E, mentre il resto del sistema continua a scalare, il loro ruolo diventa più difficile da ignorare.


Condividi
