


大規模な AI ワークロードが到来: データセンターインフラはどのように変化しているのか?
著者 Moore
日付 09/18/2026

AI ワークロードがサーバーやラック全体に拡大するにつれ、システム全体の最終的な性能は、計算能力、ネットワーキング、ストレージ、電源、冷却などの要素の協調動作にますます依存するようになっています。紙面上のピークパラメータは重要ですが、クラスターの有効スループット、拡張性、または全体的な運用コストを完全には表さなくなっています。
これにより、AIインフラを計画・評価する際、すべての人がラックおよびクラスター全体のレベルへ視点を引き上げる必要があります。この考え方の転換は、データセンターの基盤アーキテクチャの設計、拡張、展開を再構築しており、包括的な計画、システムレベルの検証、展開準備がこれまで以上に重要になっています。本記事では、これらの変化と、それが大規模AIインフラにもたらす実践的な課題を考察します。
AI駆動型データセンターインフラストラクチャの変革
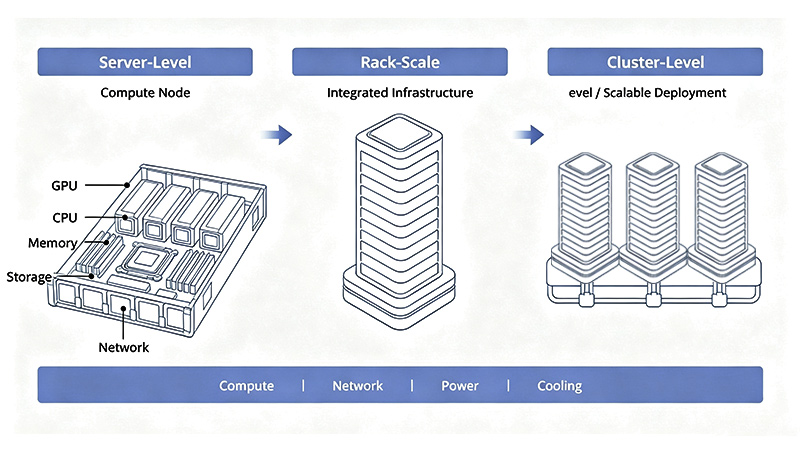
分散トレーニングや大規模推論では、アクセラレーターは常にデータを交換する必要があります。そのため、ネットワーク相互接続、ストレージアクセス、電源供給、冷却能力は、システム全体の安定性にとって極めて重要です。したがって、現在のインフラ計画はすでに単一サーバーの展開を大きく超え、高密度ラック、さらにはマルチラッククラスターへと拡張されています。サーバーは依然として最も基本的なコンピューティングノードですが、ラックとクラスターはより中核的なアーキテクチャ設計単位になりつつあります。
NVIDIAのGB300 NVL72は、この「ラックレベル」アプローチの代表的な例です。同社のエンタープライズ向けリファレンスアーキテクチャでは、液冷式GB300 NVL72ラックは標準の独立した拡張ユニットとして扱われ、18台のコンピュートトレイと72基のGPUを統合しています。より大規模なコンピューティングプールを構築するために、このようなラックレベルユニットを複数、専用のコンピュートネットワーク、コンバージドネットワーク、および管理ネットワークを通じて接続し、水平に拡張できます。
このアーキテクチャは、高性能サーバーを大量に並べるだけでは効率的に利用できません。ノード間の高速通信と将来の容易な拡張のためには、ネットワーク配線、相互接続、電力供給、液冷ソリューションを、最初から全体のインフラ設計に組み込む必要があります。
高密度サーバーラックは、データセンターの電源供給および液冷能力に非常に大きな要求を課すだけでなく、GPUとサーバー間の膨大な東西トラフィックも、ネットワーク帯域幅、トポロジー、拡張性に対してより大きな課題をもたらします。
したがって、今日コンピューティングクラスターを計画する際、中核となる問いはもはや単純ではありません。
AIコンピューティングパワーの性能:ハードウェアのアップグレードだけでは不十分
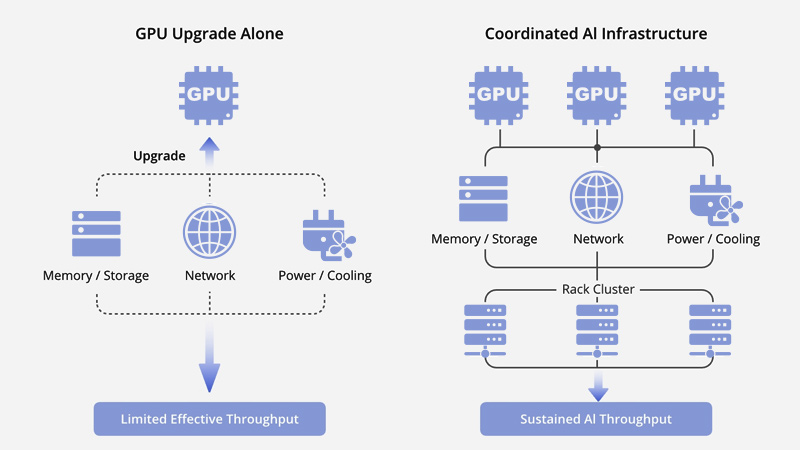
より高性能なハードウェアを追加するだけでも、確かに AI システムを改善できますが、その価値がどの程度実現されるかは、基盤となるインフラストラクチャが、これらのデバイスの理論上の能力を事業運用中の実際の出力へ本当に変換できるかどうかに依存します。
データ経路の効率
ストレージスループット、メモリ帯域幅、さらにデータ前処理と入力チャネルが一体となって、アクセラレータが時間どおりにデータを受信できるかどうかを決定します。データ伝送がわずかでも遅いと、GPU の魅力的な理論演算性能は無駄になります。さらに、ストレージ性能はモデルのチェックポイント作成、障害復旧、特徴量検索、中間データ処理に直接影響します。したがって、この能力を測定する基準は、単一のハードドライブやメモリモジュールのパラメータに注目することではなく、データパス全体が実際のビジネスワークロードをサポートできるかどうかを評価することです。
ネットワーク通信の実際のメリット
メーカーが公称する帯域幅は ネットワークカード およびスイッチは通常、利用可能な物理容量のみを表しており、アプリケーション実行時に達成される実際の速度とは同等ではありません。ネットワークトポロジー、過剰容量、ネットワーク輻輳から、光リンク、ケーブル配線、ソフトウェア設定、さらには端末自体の性能に至るまで、あらゆる要素がコンピューティングクラスターによるネットワークの実際の利用率に影響します。多くの場合、より高速なインターフェースを使用して通信上限を引き上げても、アプリケーション側の性能向上は比例しないことがあります。
クラスター拡張のスケール効果
GPUを追加すれば総計算能力は確かに向上しますが、ビジネス性能が必ずしも比例して向上するとは限りません。ノード同期、タスクスケジューリング、複数マシン間の連携、通信に伴う追加オーバーヘッドが、新たに追加されたハードウェアの利点を徐々に相殺していきます。
したがって、インフラストラクチャを設計する際、ピークパラメータは確かに必ず確認すべき指標ですが、アクセラレータの実際の使用率、有効スループット、拡張効率、最終的なタスク完了時間と併せて総合的に考慮する必要があります。
AIインフラが拡大するにつれて:待ち受けるいくつかの課題
AI インフラのスケールアップは、技術的な課題であるだけでなく、慎重なビジネス上の計算も必要とします。企業は、どれだけ追加容量を増やせるかだけでなく、この計算能力が実際に展開されるまでにどれくらいの時間がかかるか、またその変換効率がどれほど高いかも考慮する必要があります。
物理インフラストラクチャの限界
ラックおよびクラスターのレベルに達すると、ネットワーク拡張は単にネットワーク速度を高めることではありません。ポート密度、スイッチ配置、ケーブル配線、光モジュールの伝送距離、トラフィックモデル、オーバーサイズ比率をすべて再計画する必要があります。小規模展開で良好に機能するネットワークでも、クラスターが大きくなるにつれて、アーキテクチャ全体の見直しが必要になる場合があります。
電源供給と冷却にも深刻な制約があります。電力不足や不十分な冷却は、ラック密度を制限し、搭載されるアクセラレータカードの数を減らすだけでなく、拡張プロセスも遅らせます。冷却余力が不足していると、高負荷時にマシンで周波数スロットリングや運用上の制限が発生する可能性もあります。
したがって、ラック間展開はしばしば広範な影響を及ぼし、ネットワークトポロジー、ストレージアーキテクチャ、電源供給と配電、冷却、さらにはその後のサービスアクセスおよび管理プロセスの調整が必要になります。不均衡な統合コストや性能低下を引き起こさずに容量を増やす方法は、大きな課題です。
設備投資と実装タイムライン
投資の規模は GPUやサーバーをはるかに超えます。ネットワーキング、ストレージ、ラック、光 通信インターコネクト、各種ケーブル、さらに電源供給および冷却インフラ、データセンター改修、保守ツール—各項目が大きな費用です。
さらに、調達からコンピューティングパワーの実際の展開までには、データセンターの準備、ラック配線、ソフトウェア構成、相互運用性テスト、ビジネス検証、最終引き渡しという複数の段階があります。これらの段階のいずれかにボトルネックがあると、クラスター全体の納入と利用開始が遅れます。
機器の利用率と技術アップグレードへの不安
AI クラスターの価値は、その計算能力だけで測定することはできません。機器の利用率、エネルギー消費、日常保守、管理コスト、および十分に活用されていないマシンはすべて、全体的な運用コストの増加につながります。
アクセラレータ、ネットワーク、単一点の消費電力、液冷技術が急速に変化する中で、ハードウェアのイテレーションの速いペースは、インフラ計画のライフサイクルを絶えず短縮しています。企業は、現在のコンピューティング能力のニーズと、将来の拡張性や改修困難性に関する潜在的リスクとの間でバランスを取る必要があります。
マルチベンダー相互運用性
AIインフラストラクチャは通常、複数のベンダーの機器群で構成されます。ネットワークカード、 スイッチ, 光モジュール、ケーブル、サーバー、および多種多様なファームウェアとソフトウェアはすべて、本番環境に導入される前に厳格な互換性検証を必要とします。
統合およびトラブルシューティングのリスクを最小限に抑えるため、仕様は早期に定義し、認定済みの組み合わせをテストし、各当事者のサポート責任を明確にする必要があります。
最終的に、これは包括的なビジネスゲームです。設備投資、コンピューティング能力の可用性、機器利用率、日々の運用コスト、そしてアーキテクチャの長期的な柔軟性の間で最適なバランスを見つけることです。
大規模AIインフラストラクチャ:計画と検証
最新のAIに対するThe インフラストラクチャ要件は高まっています。ハードウェアの選定は、個々のコンポーネントを選ぶだけではなく 、システムアーキテクチャ全体とワークロードの文脈で包括的に検討する必要があります。
グローバル計画
コンピューティング能力、ネットワーク、ストレージ、さらに電源供給と冷却—これらの中核コンポーネントは、ビジネスニーズ、導入規模、ラック密度、将来の拡張計画に基づいて総合的に計画する必要があります。
具体的には、ネットワークトポロジー、光モジュールの伝送距離の妥当性、ケーブル配線ルート、電力配分、冷却方式、ストレージアクセス、データセンターの物理レイアウト、および将来の拡張計画—すべてを事前に明確に定義しておく必要があります。これにより、実際の導入時にデバイスの非互換性によって生じる多大な手間や極めて高額な手戻りを回避できます。
システムレベル検証
紙面上のハードウェア仕様だけを見るだけでは、AI インフラの使いやすさを判断するには不十分です。完全な信頼を得るには、包括的なシステムレベルの検証が必要であり、主に以下が含まれます:
各種ハードウェアコンポーネント間の互換性;
ネットワークと光通信モジュール間のスムーズな相互運用性;
ストレージおよびデータパス全体の持続可能なパフォーマンス。
実際のビジネス業務における通常のコミュニケーション;
長時間のフルロード下での安定動作;
安定した電源供給と冷却性能;
クロスノードおよびクロスラック拡張時の効率低下。
この全プロセスを完了して初めて、個々のコンポーネントテストで優れたスコアを達成するだけでなく、実環境の負荷下でインフラストラクチャが確実に信頼できると確信できます。
導入準備状況
導入準備とは、単にすべてのハードウェアを購入することだけではありません。標準化された構成テンプレート、検証済みの部品表(BOM)、互換性テストレポート、適切なドキュメント、設置手順、明確なトラブルシューティング責任—こうしたソフト面の準備がすべて、クラスターをできるだけ迅速にオンライン化し導入するために必要です。
今後、AIインフラを構築するプロセスは、もはや誰が最も強力なマシンを持っているかだけに依存するのではなく、これらのデバイスをどれだけ効果的に計画、接続、テストし、完全に機能する一体として連携できるようにするかにかかっています。
結論
現代のAIデータセンターは、すでに「単一ポイントのデバイス最適化」の時代を大きく超え、システムレベルの協調運用へと完全に移行しています。印象的なピーク性能パラメータには依然として価値がありますが、AI計算能力の実際の利用率は、計算能力、ネットワーク、ストレージ、電源供給・配電、冷却、そして導入プロセス全体の連携にますます依存しています。企業にとって真に必要なのは、ハードウェアの理論上の能力を、高い柔軟性、信頼性、費用対効果を備えた実際のビジネス能力へと変換する基盤アーキテクチャです。
ネットワークおよび相互接続のニーズに対して、QSFPTEKは高速スイッチ、ネットワークインターフェースカード(NIC)を含む完全なソリューションを提供します。 光モジュール, および構造化ケーブリング。システムレベルのアーキテクチャの重要なコンポーネントとして、これらのコンポーネントはネットワーク全体の互換性、総帯域幅、スケーラビリティ、導入準備性を効果的に向上させ、非常に要求の厳しいAIワークロードにも容易に対応します。QSFPTEKのAIソリューションをさらにご覧いただき、コンピューティングクラスター向けに、柔軟性が高く、厳格に実証された相互接続基盤を構築してください。


共有
