


Rubinアーキテクチャに向けて:AIデータセンターネットワークの800Gから1.6Tへの飛躍
著者 Leslie
日付 04/02/2026

NVIDIAの次世代Rubin GPUプラットフォームは、AIインフラストラクチャ設計の根本的な変革を推進しています。AIワークロードが数十億のパラメータから数兆へと増大するにつれ、課題は計算性能だけにとどまらなくなっています。システム効率を真に左右するのは、多くの場合、数千基のGPU間でデータを効率的に移動する能力です。この文脈において、ネットワークはもはや単なるサポート層ではなく、AI性能を決定する中核コンポーネントです。これらのシステムは本質的に大規模な並列処理向けに設計されており、ノード間で継続的かつ高密度な通信が行われるため、データセンターの設計ロジックを再構築しています。
Rubinアーキテクチャとは
NVIDIAのRubinアーキテクチャは、Blackwellアーキテクチャをアップグレードしたものです。超大規模AIモデルのトレーニングと低レイテンシー推論向けに特別に設計された、フルスタックの協調コンピューティングプラットフォームです。複数の新しいチップで構成され、より高い性能とエネルギー効率を誇り、大規模AIタスクの効率的な運用を支え、AIの大規模な発展を推進する中核インフラストラクチャとして機能します。
主に単一チップの性能向上に重点を置いていた従来のGPUとは異なり、Rubinは当初から大規模分散AIシステム向けに設計されました。その最終目標は、数万基のGPUを含むクラスター上で効率的なトレーニングを実現することです。
この環境では、GPUは勾配、パラメータ、中間データを継続的に交換する必要があります。通信負荷は非常に大きく、データ伝送効率がトレーニング速度に直接影響します。InfiniBandやRDMAなどの技術はレイテンシーを低減し、スループットを向上させることができますが、それでも物理層に十分な帯域幅が必要です。
AIインフラストラクチャにおける800Gの役割
800G相互接続は、高性能AIインフラストラクチャの事実上の標準になりつつあります。400Gソリューションと比較して、800Gは帯域幅を2倍にすると同時に、現段階における消費電力と導入の複雑さの合理的なバランスを実現します。
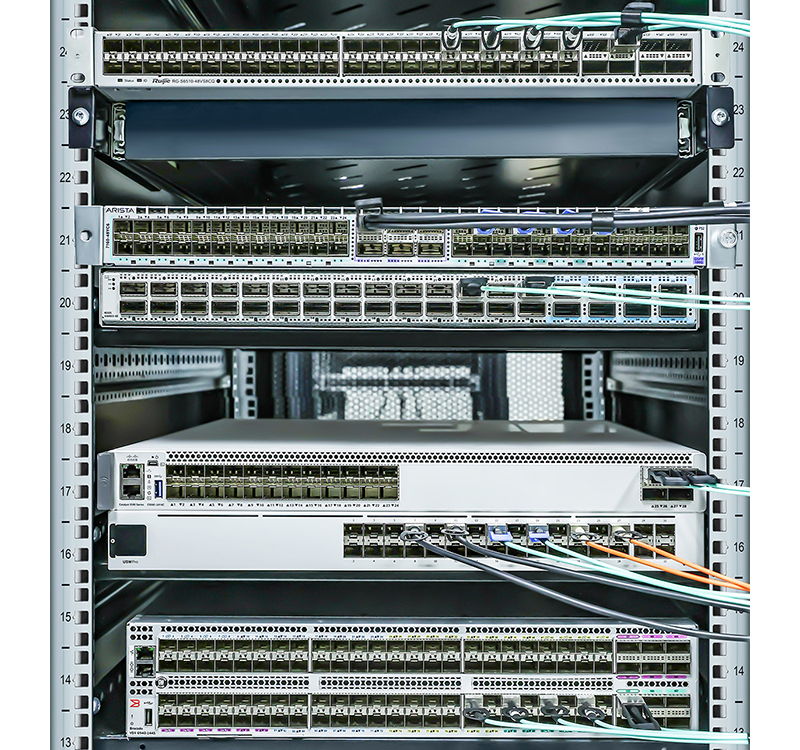
実際の導入環境では、 800Gソリューション 用途に応じた明確な役割分担があります:
DACは、サーバーラック内のGPUとToRスイッチ間の超短距離接続に使用されます。銅線ケーブルは追加の電力をほとんど消費せず、伝送遅延が最も低いため、サーバーラック内の高密度相互接続に適した媒体です。
AOCsは、サーバーラック間の短距離から中距離の接続に適しています。AOCsは光モジュールとケーブルを統合しており、信号の完全性を確保し、光ファイバーインターフェースの清掃および保守要件を軽減しながら、現場での導入プロセスを簡素化します。
光モジュールは構造化ネットワークのコアバックボーン層で使用され、Spine-Leafアーキテクチャにおける長距離相互接続をサポートします。光モジュールは、光ファイバー配線システムと組み合わせることで、PODおよびリージョンをまたぐネットワーク拡張を可能にします。
この階層型導入アプローチは、大規模AIクラスターの実際のエンジニアリングニーズを反映しています。QSFPTEKを例に挙げると、その800G製品ラインはDAC、AOC、光モジュールの全範囲をカバーしています。その中核的な価値は、3層ネットワークアーキテクチャにおいて、ユーザーが一貫した互換性パフォーマンスを得られるようにすることにあります。高密度かつ高スループットのAIクラスター環境では、さまざまなシナリオにわたる安定した相互運用性が、単一の性能指標よりも重要であることが少なくありません。
Rubin時代における800Gの限界
800Gソリューションは現在のAIクラスターで十分に実証されていますが、NVIDIA Rubinアーキテクチャに代表される次世代のコンピューティング密度に対応する際、その限界がますます明らかになっています。
主な圧力源は、次の3つの側面です。
急上昇するGPU密度: ラックあたりのGPU数は、現在主流の8から16または32へと増加しており、ラック内の集約帯域幅需要はTbpsレベルから数十Tbpsへと急増し、ToRスイッチポートの収束比に深刻な課題をもたらしています。
クラスターサイズの拡張: クラスターノードは数千から数万、さらには数十万ノードへと拡大しており、ネットワーク輻輳のパターンは局所的なホットスポットからグローバルに分散した輻輳へと変化しています。単純にリンク数を増やすと、配線の複雑さ、消費電力、保守コストが超線形に増加します。
通信モードの進化: Expert Parallelism (MoE)に代表される新しいモデル並列化戦略は、従来のTransformerアーキテクチャと比較してGPU間の同期頻度を大幅に増加させるため、ネットワークシステムには高帯域幅と低遅延という要件を同時に満たすことが求められます。
コンピューティングとネットワークの対応関係という観点から見ると、Rubinプラットフォームのカード1枚当たりのコンピューティングスループットは、Blackwellアーキテクチャの2倍以上になると予想されています。ネットワーク帯域幅が変わらない場合、コンピューティングリソースがデータを待つアイドル時間の割合が大幅に増加し、GPUコンピューティング能力の実効利用率が直接制限されます。
1.6Tモジュールが必要な理由
1.6Tインターコネクトの進歩は、主に次世代GPUアーキテクチャによるネットワーク帯域幅への強い需要によって推進されています。その重要性は、ポート速度を2倍にすることだけでなく、前述の構造的なボトルネックに対処するための実現可能な技術的道筋を提供することにもあります。
1.6Tの中核的価値は、以下の側面に反映されています:
帯域幅密度の向上: 単一ポートで200GB/sのデータスループットを実現します。例えば、48ポートスイッチは約10Tbpsの総帯域幅を提供でき、800Gソリューションと比較して、ポート数と占有ラックスペースを約半分に削減できます。
簡略化されたトポロジー: 同じクラスター規模では、1.6Tはよりフラットなネットワークトポロジーをサポートします。たとえば、3層Closアーキテクチャを2層アーキテクチャに簡素化することで、Spine層のデバイス数を削減すると同時に、層をまたぐ転送によって生じる遅延の蓄積も抑えられます。
運用の複雑さを軽減: リンク数の削減は、ファイバー芯数、光モジュール数、障害ポイント数の同時削減に直結します。大規模クラスターでは、この効果により運用効率が大幅に向上する可能性があります。
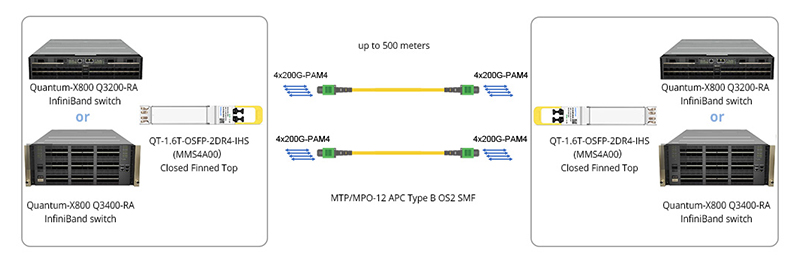
QSFPTEKはすでに1.6T製品ラインで技術展開を開始しており、いくつかの 1.6Tモジュール AIデータセンター向けです。これは、Rubinアーキテクチャの本格導入時に事後対応的なアップグレードの圧力に直面するのではなく、既存の800Gインフラストラクチャ上で次世代ネットワークの統合を事前に計画できることを意味します。
推奨される実際のアップグレードパス
実際のデータセンター環境における800Gから1.6Tへの進化は、通常、一度に完全に置き換えるのではなく、段階的な道筋をたどります。
次のアップグレードパスを参照できます:
アクセスレイヤーおよび短距離相互接続:800G DACおよびAOCソリューションを引き続き使用します。消費電力とコストの面で、銅線ケーブルとアクティブ光ケーブルが持つ利点は、ラック内およびラック間の短距離用途では、短期的に代替することが依然として困難です;
スパイン層とコアバックボーン:まず1.6T光モジュールとスイッチを導入して、POD間の集約トラフィックを収容し、将来の拡張ニーズに対応できるようコア層に十分な帯域幅の余裕を確保します;
ハイブリッドアーキテクチャへの移行:リンクアグリゲーションまたはレートネゴシエーションの仕組みにより、800Gおよび1.6T機器のハイブリッド運用を実現し、アクセス層からコア層への世代交代を段階的に完了することで、一度に発生する設備投資とサービス中断のリスクを回避します。
すでに800Gインフラを導入しているデータセンターでは、通常、2~3年間の円滑な移行期間が設けられます。この期間中は、光モジュールの下位互換性、配線システムの予備容量、ネットワークオペレーティングシステムのマルチレート連携機能に同時に注意を払う必要があります。
結論
800Gから1.6T光モジュールへの移行は、NVIDIA’のRubinアーキテクチャをサポートするために不可欠です。1.6Tは、次世代データセンターの要件を満たす、より高い帯域幅密度、よりシンプルなネットワーク構成、より低いレイテンシーを実現します。段階的なアップグレード方式により、ユーザーはインフラストラクチャを円滑に移行しながら、QSFPTEK’の1.6T光ソリューションを最大限に活用して、安定した高性能なクラスター接続を実現できます。


共有
