


AIファクトリーとは?そして、なぜ800G/1.6T光トランシーバがその基幹を担うのか
著者 Moore
日付 03/20/2026

データセンターからAIファクトリーへの移行
インフラストラクチャの構築方法に、いつの間にか変化が起きています。少し前まで、データセンターは主にストレージ、仮想化、ユーザーリクエストの処理を目的としていました。今では様相が異なります。ワークロードはより重く、より継続的になり、多くの場合、ユーザーの直接的な操作にさえ結び付いていません。AIシステムはバックグラウンドで稼働し、生成、推論、反復を行い、ときには従来の意味では決して本当に“終わる”ことのないタスクを繰り返し処理します。
“AIファクトリー”という概念は、もはや単なるバズワードではなく、現実のものになりつつあります。データは大規模モデルに入力されて処理され、継続的に出力が生成されます。このシステムは、ITアーキテクチャというよりも産業システムに近いものです。NVIDIAがRubinプラットフォームを発表した際に意図したとおり、その目標は、このアーキテクチャ革命を成し遂げることです。現在直面している課題は、ハードウェアの能力だけにとどまりません。インフラストラクチャのレベルでは、推論コストを削減し、導入の予測可能性を向上させながら、大規模なAI生産を支えられるシステムをどのように構築するかを検討する必要があります。
インフラストラクチャが工場のように動作し始めると、その圧力はスタック全体に波及します。コンピューティングはその一部にすぎません。ストレージ、メモリ、スケジューリング、オーケストレーション、そして特にネットワーキングが、それぞれ異なる形で重要になってきます。単にパフォーマンスが必要なだけではありません—負荷がかかった状態での一貫性と、すべてが脆弱になることなく拡張できる能力が必要です。
Rubin Platformの内部:異なる種類のシステム設計
Rubinを詳しく見てみると、従来の段階的なアップグレードのパターンにはあまり従っていません。むしろ、リセットに近い印象です。個々のコンポーネントを個別に改善するのではなく、このプラットフォームは複数のレイヤーを統合し、全体として最適化しています。Vera CPU、Rubin GPU、NVLink 6、ConnectX-9 SuperNIC、BlueField-4 DPU、Spectrum-6 Ethernetは、すべてその設計の一部です。
このような連携は、システムの動作を変化させます。たとえば、現在のMoEトレーニングワークロードでは、前世代と比べて必要なGPUの数が大幅に減っていますが、全体的なアクティビティが減るわけではありません。単に再配分されるだけです。推論の頻度が高まり、モデルがより複雑になり、ワークロードがより長いシーケンスにわたるようになります。結果として、システムが移動させるデータ量は減るのではなく、増加します。
NVL72ラックスケールシステムは、その好例です。数十基のGPUを緊密に統合されたユニットに集約することは効率的に思えます—そして実際に効率的です—が、ラック内部に高密度な通信パターンも生み出します。データはもはや上下方向に流れるだけではありません。GPU、メモリプール、アクセラレータの間を横方向に絶えず移動します。その内部圧力は、最終的により広範なネットワークへと波及します。
AIファクトリーが従来とは異なる形でネットワークに負荷をかける理由
AI Factory内のネットワークは、従来の前提が成り立たなくなるほど大きく異なります。単に帯域幅の需要が高まるだけではありません。トラフィックパターンも変化します。東西方向のトラフィックが中心となり、通常は変動せず高い状態が続きます。GPUは、特に分散トレーニングや多段階推論のシナリオにおいて、常にデータを交換しています。レイテンシーは、理論上ではなく実際のパフォーマンスにおいて、より顕著になります。
同時に、基盤となる技術は急速に進化しています。たとえば、NVLink 6はGPU間の帯域幅を、各デバイスが毎秒数テラバイトを処理できるレベルまで引き上げます。単一のラック内では、総帯域幅が毎秒数百テラバイトに達します。これはわずかな向上ではなく—まったく異なる規模です。
Ethernetの分野では、NVIDIA Spectrum-XがAIネットワークの構築方法を変革しています。Ethernetを汎用ファブリックとして扱うのではなく、AIワークロード専用に調整しています。効率の向上は明らかですが、それ以上に際立つのは、持続的な負荷の下での安定性です。AIクラスターがアイドル状態になることはあまりないため、稼働時間と一貫性がピーク性能と同じくらい重要になります。
さらに、BlueField-4も加わっており、一部のデータ処理機能とセキュリティ機能をCPUから切り離します。必ずしもそれほど注目されるわけではありませんが、大規模な導入環境では、管理しやすい状態を維持するのに役立ちます。また、推論コンテキストをセッション間で再利用できるAIネイティブストレージへの移行に伴い、システム全体はサーバーの集合というよりも、連携して動作するパイプラインのようになっていきます。
これらすべてから、単純な見解が導き出されます。今日のネットワークは、単なるコンピューターノード間の接続手段ではありません。ネットワーク自体が計算プロセスの一部となっています。そして、そうなると、旧来の設計—特に400Gを前提として構築された設計—の限界がより明確になります。
400G vs 800G vs 1.6T:実際に何が変わり、なぜそれが重要なのか
移行元 400G 800G、さらには1.6Tへの移行は、単純な速度アップのように思えるかもしれません。実際には、その違いは帯域幅の数値以上に根深いものです。
400Gには依然として活躍の場があります。広く導入され、比較的成熟しており、トラフィックパターンが予測可能な環境や、トラフィックが常に飽和しているわけではない環境で良好に機能します。従来のクラウドワークロードや、さらに小規模なAIクラスターでも、コストとパフォーマンスの妥当なバランスを実現できます。問題は、AI Factoriesがもはやそのようには動作しないことです。トラフィックはより高密度かつ継続的になり、ボトルネックが発生した際の許容度も低くなっています。
スイッチアーキテクチャが200G SerDesへ移行すると、800Gはより合理的になり始めます。多数の低速リンクを組み合わせる代わりに、スイッチの容量と光インターフェースの間により明確な接続が得られます。これにより状況によっては物事が簡素化されますが、さらに重要なのは、より多くのスペースを必要とせずに全体的な生産性が向上することです。大規模なGPUクラスターでは、そのような効率性がすぐに積み上がります。
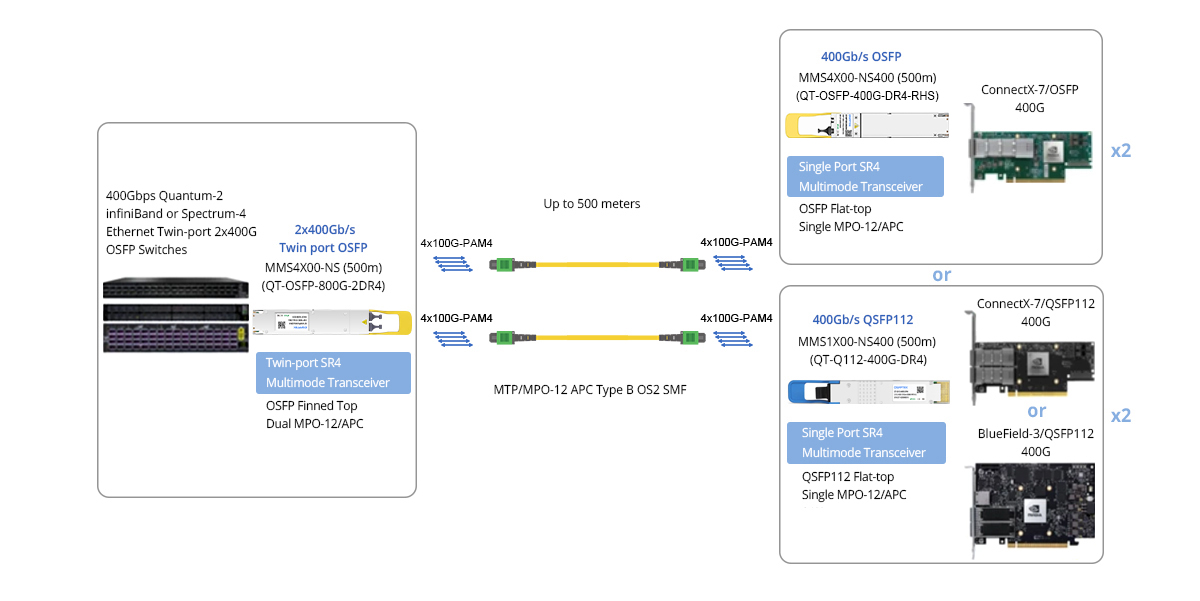
800G NVIDIA/Mellanox MMS4X00-NS Quantum-2およびSpectrum-4の空冷スイッチ、液冷システムおよびDGX-H100システム、ConnectX-7およびBlueField-3 DPUと互換性があります。
さらに1.6Tがありますが、これはアップグレードというよりも、次のステップに向けた準備のように感じられます。ポート密度を高められるため、同じ規模を実現するのに必要なスイッチの数が少なくなります。ビットあたりの電力効率も向上します。エネルギー消費が拡張の制約になり始める中、これは重要です。数万台、あるいは数十万台のGPUを使用するような非常に大規模なAI導入環境では—800Gで拡張する場合と1.6Tへ移行する場合の違いは、単なる技術的なものではなく、コストモデルや物理レイアウトにも影響します。
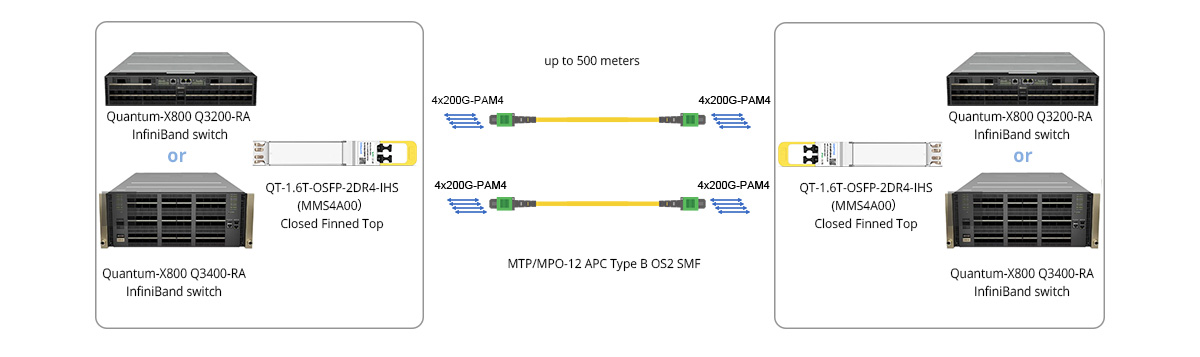
1.6T NVIDIA/Mellanox MMS4A00 はQuantum-3空冷および液冷スイッチと互換性があります。
実際には、これらの選択肢が一夜にして互いに置き換わるわけではありません。通常は共存します。400Gは、エッジや要件がそれほど厳しくないセグメントで引き続き使用される可能性があります。800Gは、現在のAIクラスターの主要なファブリックになりつつあります。1.6Tは、新規構築環境や、密度と効率が最も重視されるネットワーク部分で採用され始めています。"最適な"選択肢は、仕様書よりも、システムが時間の経過とともにどのように変化すると想定されているかによって決まります。
これは、ソリューションプロバイダーが支援できる分野でもあります。例えば、QSFPTEKは800Gと 1.6T光モジュール, また、AIデータセンターに適した構築方法についても説明します。速度階層だけでなく、これらの階層が実際のアーキテクチャにどのように組み込まれるかに重点を置いています。場合によっては、一度に全面的なアップグレードを強いるよりも、同じネットワーク内で異なる世代を混在させる方が、より良い結果につながることがあります。
今後の展望:1.6Tが思ったよりも間近に迫っている理由
800Gは一般的になりつつありますが、これが最終形だとは思えません。AIワークロードは増大していますが、必ずしも同じように増えているわけではありません。モデルは大規模化する一方で、よりインタラクティブにもなっています。推論はもはや単純なリクエスト・レスポンスのサイクルではありません。複数のステップ、外部ツール、より長いコンテキストウィンドウが関わる場合があります。そのすべてが、システム内を移動するデータ量を増加させます。
単一拠点を超えた規模の問題もあります。新しいアーキテクチャの中には、複数のデータセンターを単一の論理環境として接続するよう設計されたものがあります。それにより距離も考慮する必要が生じ、新たな遅延や同期の課題も加わります。
1.6T光トランシーバーは、この構図にごく自然に適合します。すべてを解決するわけではありませんが、帯域幅と密度に関する当面の制約の一部を取り除きます。限界への対応を絶えず繰り返す必要がなくなり、ネットワーク設計に再び多少の柔軟性が生まれます。それだけでも、大規模な導入を簡素化できます。
結論
QSFPTEKは、1.6Tポートフォリオやその他のAIインフラストラクチャソリューションを通じて、このようなシナリオに備えてきました。常に可能な限り高速化することが重要なのではありません。段階的なアップグレードでは不十分となる段階にネットワークが達したときに、選択肢を用意しておくことがより重要です。
結局のところ、AI Factoryという考え方は、すべてをフロー—つまり、データがどのように移動し、どれほど速く移動し、ある場所から別の場所へどれほど確実に到達するかという点に立ち返らせます。光モジュールは通常あまり注目されませんが、まさにその経路上にあります。そして、システムの他の部分が拡張し続けるにつれて、その役割はますます無視できなくなります。


共有
