


InfiniBand XDRとは何か、そしてAIネットワークにおいてなぜ重要なのか
著者 Leslie
日付 06/18/2026

InfiniBand XDRは、AIトレーニングクラスターの規模が拡大し続け、GPU間のデータ交換が急増していることを背景に導入された重要なソリューションです。数万基のGPUを備えた大規模なトレーニングプラットフォームにとって、ネットワークはもはや単なる補助システムではなく、トレーニング効率に影響を与える重要なインフラストラクチャです。このような背景から、InfiniBand技術がより高い帯域幅へと継続的に進化することがトレンドとなっており、InfiniBand XDRはまさに次の段階のAIネットワーク要件に対応する技術です。
InfiniBand XDRとは何ですか
InfiniBand XDRは、NVIDIAが推進するInfiniBandテクノロジーロードマップにおける最新の速度クラスであり、主に次世代AIコンピューティングプラットフォームとハイパフォーマンスコンピューティング環境を対象としています。前世代のNDRの400Gbpsポート速度と比較して、XDRはシングルポート帯域幅を800Gbpsに拡大し、ネットワーク容量を大幅に向上させています。
技術的な観点から見ると、XDRは低遅延、高スループット、RDMAというInfiniBandの中核的な利点を継承しつつ、次世代の高速SerDes、スイッチングチップ、光インターコネクト技術を組み合わせることで、超大規模GPUクラスターにより強力なネットワークサポート機能を提供します。
簡単に言えば、XDRは単に速度を2倍にするだけのものではなく、AIクラスターの将来的な拡張ニーズに対応するために設計された次世代の相互接続プラットフォームです。
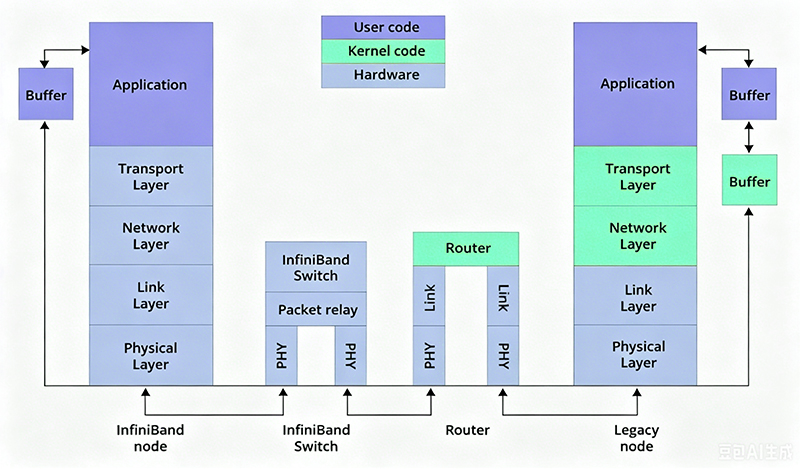
AIトレーニングになぜ800Gまたは1.6Tネットワークが必要なのか
従来のエンタープライズネットワークでは、トラフィックの大部分はユーザーがサーバーにアクセスすることで発生する南北トラフィックです。AIトレーニング環境はまったく異なり、その中核となるトラフィックは主にサーバー間、すなわち東西トラフィックで発生します。
大規模モデルのトレーニングでは、多数のGPUが勾配、モデルパラメーター、中間計算結果を頻繁に交換する必要があります。たとえば、分散トレーニングで一般的なAll-Reduce演算では、ノード間通信に対する大きな要件が生じます。
モデルの規模が数十億のパラメータから数千億、さらには数兆のパラメータへと拡大するにつれて、ネットワーク通信量も増加します。ネットワークがデータを適時に同期できない場合、GPUはデータ転送が完了するまで待機することしかできず、その結果、全体的な使用率が低下します。
したがって、最新のAIクラスターでは、ネットワーク性能はGPU性能と同じくらい重要です。
InfiniBand XDRがAIクラスターの効率を向上させる仕組み
まず、帯域幅が拡大します。A 1.6T XDR リンクは同じ時間内により多くのトレーニングデータを伝送できるため、分散トレーニングにおける同期遅延が短縮され、GPU使用率が向上します。
第二に、スケーラビリティが向上します。AIクラスターが拡大するにつれて、スイッチポートの数とネットワーク層も増加します。ポートレートが高いほど、同じ帯域幅を実現するために使用するリンク数を減らすことができ、ネットワークアーキテクチャの設計が簡素化されます。
さらに、より広い帯域幅はホットスポットトラフィックや輻輳の問題を緩和します。数千のGPUノードが同時にデータを交換している場合、ネットワークはより十分な伝送リソースを提供でき、性能の変動を低減します。
大規模言語モデル、マルチモーダルモデル、科学計算タスクのトレーニングにおいて、これらの利点はトレーニング効率の向上に直結します。
InfiniBand XDRおよびEthernet AIネットワーク
近年、RoCEv2ベースのEthernetソリューションが急速に発展し、400Gおよび800G EthernetがAI データセンター市場で広く採用されています。しかし、InfiniBandは依然として超大規模トレーニングのシナリオで大きな優位性を維持しています。
まず、InfiniBandは当初から高性能コンピューティング環境向けに設計されており、そのRDMAメカニズム、輻輳制御、および集約通信機能は長年にわたって検証されてきました。
第二に、NVIDIAは、Quantumスイッチ、ConnectXネットワークカード、CUDAソフトウェアスタックを含む完全なInfiniBandエコシステムを構築しています。これらのコンポーネントが連携し、AIトレーニングのパフォーマンスを最適化します。
究極のパフォーマンスと最小限の通信遅延を求めるAIプラットフォームにとって、InfiniBandは今も多くのスーパーコンピューティングセンターや大規模AIトレーニングクラスターで推奨されるソリューションです。
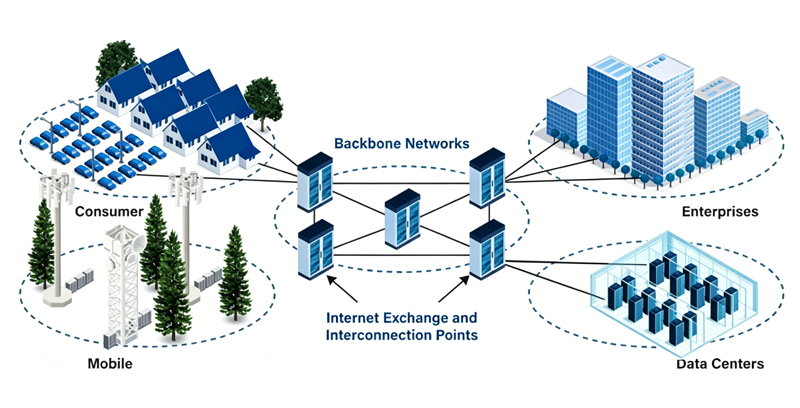
InfiniBand XDRが高速光インターコネクトのアップグレードを促進
XDRネットワークの導入が段階的に進むにつれて、データセンターの光インターコネクトアーキテクチャもそれに応じてアップグレードされます。800Gbpsリンクには、より高性能なスイッチと光モジュールが必要です。現在利用可能な高速光モジュールとしては、たとえば 800G OSFP, 800G OSFP SR8、800G DR8、および800G 2x FR4は、XDRネットワークを構築するうえで重要なコンポーネントになりつつあります。
同時に、光ファイバー配線、ラック設計、冷却システムも、より高密度かつ広帯域な導入要件に適応する必要があります。今後数年間のAIデータセンターにおけるネットワークのアップグレードは、主に800G相互接続エコシステムを中心に進むと予想されます。
結論
AIモデルの規模が拡大し続けるにつれ、ネットワークはトレーニング効率を左右する重要な要因となっています。最新世代のInfiniBand技術であるXDRは、800Gおよび1.6Tの帯域幅、低遅延アーキテクチャ、優れた拡張性により、将来のハイパースケールGPUクラスター向けに、より効率的な相互接続プラットフォームを提供します。AIインフラストラクチャが進化を続ける中、XDRは次世代インテリジェントコンピューティングセンターの発展を促進する主要技術の1つになると期待されています。


共有
