


XPOトランシーバーの概要:CPOとの違いは何ですか?
著者 Moore
日付 05/18/2026

光モジュールが100Gから400G、800G、さらには1.6Tへと進化するにつれて、データセンターの帯域幅容量は継続的に増加してきました。長い間、「高速化すれば問題は解決する」という考え方が通用していました。しかし、AIトレーニングのワークロードが急速に拡大する中、単に速度向上だけに頼るのでは不十分です。
現在のボトルネックは、もはや単一ポートの帯域幅が十分かどうかだけではありません。システム全体のレベルへと拡大しており—ポート密度、消費電力の制御、放熱スペース、その後の保守に関する問題が同時に顕在化し、相互に制約し合っています。
こうした背景から、業界では新たな光インターコネクト方式が模索されています。一方ではCPOのような高度に統合されたソリューションがあり、他方ではプラガブルアーキテクチャに対する新たな調整が進められています。XPO (eXtra-dense Pluggable Optics)は、このアプローチのもとで徐々に登場してきた方向性です。
AIインフラは制約の新たな段階へ
データセンターが従来のクラウド構成から徐々に移行し、AIに特化した大規模なコンピューティングシステムを採用するにつれて、ネットワークの役割も変化しています。ネットワークは単にデータを転送する手段ではありません — トレーニングの性能やリソースの利用効率に直接影響を与える、インフラストラクチャの重要な一部です。
通常、ポート速度を400Gから800G、さらに1.6Tへと向上させるだけでは、実際のシステムのニーズを満たすには不十分です。主な問題は、「単一ポート帯域幅」から、より複雑なシステムレベルの課題へと移行することです。
帯域幅の負荷は単一ポイントからグローバルへ移行している
大規模モデルのトレーニング中、多数のGPUまたはアクセラレータカードは、パラメータと勾配を継続的に同期する必要があるため、ノード間のデータ交換頻度が極めて高くなります。モデルサイズが増大するにつれて、ネットワークトラフィックはシングルポート速度の向上を大幅に上回るペースで増加します。
インターフェース速度が向上し続けているにもかかわらず、ネットワーク帯域幅密度は、特にマルチノード並列トレーニングのシナリオにおいて、依然としてトレーニング効率を容易に制限する可能性があります。
大規模展開では信頼性の問題が増幅される
AIクラスターでは、光モジュールのリンク数は容易に数万、あるいはそれ以上に達する可能性があります。規模が大きくなると、各リンクで障害が発生する頻度がそれほど高くなくても、何らかの問題が発生する可能性があります。これらの問題を完全に回避することは困難です。
このような環境では、1つのリンクに障害が発生すると、影響はローカルエリアだけにとどまりません。すべてのコンピューティングリソースを使用しているトレーニングタスクを一時停止、再スケジュール、またはキャンセルできます。ネットワークの信頼性は、単なる視覚的な機能ではありません。ビジネスは円滑に稼働する必要があります。
冷却システムは液冷アーキテクチャへと移行しています。
AIコンピューティングチップの消費電力が増加し続ける中、従来の空冷ソリューションは限界に近づいており、液冷が高密度データセンターの主流のアプローチになりつつあります。
これは光相互接続デバイスにも新たな制約をもたらします。信号性能を保証するだけでなく、より高密度なラックレベルの導入をサポートするために、構造設計、材料選定、熱設計も液冷環境に適応させる必要があります。
エネルギー効率Hasがネットワーク設計の中核指標の一つに
高密度AIクラスターでは、電力リソースをコンピューティングとネットワーキングの間で再配分する必要があります。システム規模が大きくなるにつれて、ネットワーク側の消費電力は無視できなくなります。
その結果、「power per bit」は光インターコネクトソリューションを評価するための重要な指標として浮上しており、全体的な運用コストとシステムのエネルギー効率の上限に直接影響します。
工学的限界に近づく物理ポート密度
現在主流のプラガブル光モジュールのフォームファクター(OSFPなど)は、帯域幅の増加に伴い、物理的な密度限界に近づいています。ポート密度を同時に高められないままチップ帯域幅が拡大し続けると、ネットワークアーキテクチャに階層を追加する必要が生じ、その結果、遅延が増大し、設計がより複雑になります。
XPO (eXtra-dense Pluggable Optics)とは何ですか?
OFC 2026が近づく中、Arista Networksは複数の光モジュールメーカーと共同で、XPO (eXtra-dense Pluggable Optics)というコンセプトを提案しました。XPOは、次世代AIデータセンター向けの高密度プラガブル光インターコネクトソリューションと捉えることができます。その中核的な目的は、プラガブルモジュールの運用上の利点を損なうことなく、帯域幅密度と放熱能力をさらに向上させ、高電力コンピューティング環境に適応することです。
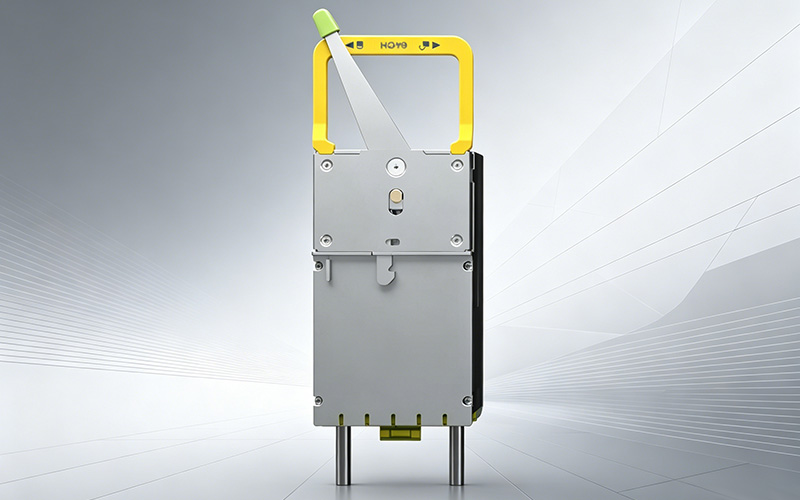
XPOは単なる「速度向上」ではありません。AIのラックレベル導入のニーズを満たすことに重点を置き、構造、電源供給、放熱方式を全面的に再構築したものです。
XPOの主な仕様と機能
設計の観点から見ると、XPOは従来のOSFPの進化路線から明らかに離れ、より「システムレベルの光インターコネクトユニット」へと傾いています:
これらすべての要因は同じ現実を示しています。XPOは単なる光モジュールではなく、高密度コンピューティング相互接続コンポーネントなのです。
OSFPと比較した変化は単なる「倍増」以上
従来のものを使用する場合 OSFPソリューション 参考までに、XPOは複数の面で大きな飛躍を遂げています。単一モジュールの帯域幅は約8倍、パネル密度は約4倍に向上し、標準的なプラガブルフォームファクターに完全な液冷ソリューションが導入されたのはこれが初めてです。
より重要な変化は、数値そのものではなく、設計ロジックが「単一ポートの速度向上」から「ラックレベルの消費電力と密度を中心に光インターコネクトのフォームファクターを再定義する」へと転換したことにあります。このアプローチでは、XPOは基本的なインターコネクトユニットに近く、AIの超高消費電力シナリオ向けに再設計されています。
XPOの革新的なコア設計:
「Belly-to-Belly」デュアルPCBスタッキングアーキテクチャ
XPOのハードウェア構造における最も大きな変更点は、従来の単一PCB設計が「デュアルPCBスタッキング」に置き換えられたことです。2枚の32チャネルPCBが背中合わせに密接して配置され、システムレベルで発熱領域と機能領域を再定義しています。
この構造では、発熱量の多いコンポーネント(送信回路やレーザードライバーモジュールなど)を内側の「ホットゾーン」に配置し、消費電力の少ないコンポーネント(受信機や制御ロジックなど)を外側の「コールドゾーン」に配置します。この方法の主な考え方は、熱が移動する経路を短縮することで、熱をより迅速に冷却システムへ送り込み、熱除去の効率を向上させることです。
より多くのチャネルが1つのモジュールに収容されるにつれて、機械的な面での要求が高まります。指をかける場所が多いため、抜き差しにはより多くの手間がかかります。時間が経つにつれて、特に複雑な構成では、日常的なメンテナンスが少し面倒に感じられることがあります。
モジュールレベルの液体冷却:光モジュールに直接組み込み
XPOでは現在、モジュールの一部として液体冷却が含まれています。コールドプレートは2枚のPCBの間に挟まれています。これにより、両方の層からの熱を、より短く直接的な経路でまとめて除去できます。つまり、外気やダクトを使用して空気を循環させる必要がないため、熱が発生している場所で直接放熱できます。
実際には、この設計は400W以上のTDPに対応できます。冷却液の温度が約40–45°Cの場合、全体の温度は通常、従来の空冷ソリューションより20~25°C低くなります。
コネクタには、漏れ防止設計のブラインドプラグ式クイックコネクタが採用されており、約500回の挿抜に耐えることができます。コールドプレートの内部は単なる金属板ではなく、熱が集中する領域に沿って配置された流路を備えています。構造はシンプルで、入口と出口がそれぞれ1つずつあります。全体的なアプローチは、従来の「外付け」モジュール冷却システムというよりもGPUコールドプレートソリューションに近く、システムレベルの設計に似ています。
電気アーキテクチャおよび50V電源
信号および電源供給レベルでも、XPOは再設計されています。その電気アーキテクチャは、それぞれ200Gbps PAM4の64本の高速電気チャネルをサポートし、合計帯域幅12.8Tbpsを実現しています。また、25.6Tbpsの能力を達成するため、400Gbpsチャネルへの進化が計画されています。
電気設計の主な特徴は次のとおりです。
第一に、最適化されたチャネル配置: クロストークを低減して信号インテグリティを向上させるため、Tx信号とRx信号をパドルカードの反対側に配置しており、リニアドライブアーキテクチャ(LPO)のシナリオにより適しています。
第二に、電源部と制御部は別々に設計されています。低速制御信号(I2C/I3C、リセット、アラーム信号など)には、独立した中央コネクタが使用されます。このコネクタは、高速データチャネルから物理的に分離されています。これにより、電気的干渉が低減され、制御信号の安定性が向上し、高速リンクによる制御信号への影響を防止できます。
さらに重要なのは、電源アーキテクチャがアップグレードされたことです。XPOは、ラックレベルのバス電源から直接供給される46–53V DC入力(通常は約48V/50V)を使用します。従来の3.3Vモジュールと比較して、必要な電流が大幅に低減されるため、配線損失とコネクタのサイズが削減され、電源全体の効率が向上します。この設計は、データセンターにおける高電圧DC電源の将来的なトレンドにも、より適合しています。
XPOがデータセンターアーキテクチャに与える実際の影響
XPOの重要性は、個々のものを作ることにとどまりません 光モジュール またはスイッチングデバイスを改善することです。これはデータセンター全体の設計に直接影響します。単一のモジュールで帯域幅、消費電力、放熱性が大幅に改善されると、この変化はネットワーク階層に沿って層ごとに積み重なっていきます。最終的には、システム全体の容量、その利用方法、そして全体的なコスト構造に影響を及ぼします。
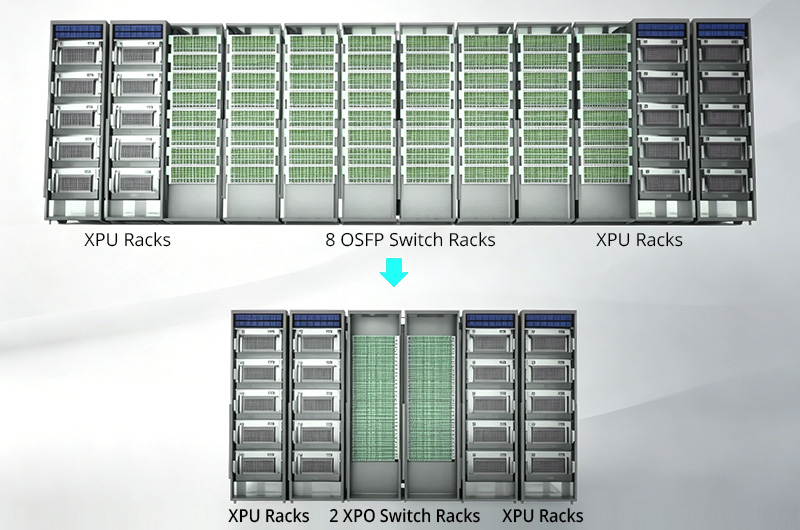
システム設計の観点から見ると、例えば総スイッチング容量204.8 Tbpsのネットワークを構築する場合、XPOソリューションに必要なラックスペースは従来のOSFPソリューションの約4分の1にすぎず、帯域幅密度は約4倍になります。これは、同じ物理スペース内でネットワークデバイスがより高いスループットをサポートできることを意味し、AIトレーニングやハイパフォーマンスコンピューティングに、よりコンパクトなインフラストラクチャを提供します。
一般的なORv3 (HPR)液冷ラック環境でも、2つのソリューションの違いは非常に顕著です。従来のOSFPアーキテクチャでは、ラック1台あたりの消費電力は約32 kWです。これに対し、XPOソリューションでは約128 kWまで引き上げることができ、液冷システムで一般的に計画される120 kW以上の電力密度範囲に近づきます。実際の導入では、OSFPソリューションは液冷インフラストラクチャの能力を十分に活用できないことがよくあります。一方、XPOは消費電力と放熱能力をより適切に整合させ、エネルギーおよび冷却リソースをさらに有効活用できるため、全体的なTCOパフォーマンスが向上します。
要するに、XPOは同じスペースで約4倍のネットワーク容量を提供できます。この改善は単なる省スペース化にとどまらず、データセンターの構築コスト、導入時間、運用の複雑さにも影響します。
ハイパースケールAIシナリオでは、この利点はさらに強くなります。たとえば、約128,000個のXPUを使用し、3層Closトポロジーを採用した400MW級AIデータセンターでは、約12.8Tbpsのスケールアップ帯域幅と1.6Tbpsのスケールアウト帯域幅が必要です。従来のOSFPアーキテクチャでは、ラックあたりのスイッチング容量は約1.64 Pbpsです。しかし、XPOアーキテクチャでは約6.55 Pbpsを達成でき、ラック数を約75%削減できます。
ラック数の削減により、電源、冷却、ケーブル配線などのインフラ需要が減少します。その結果、全体的な建設コストが大幅に削減されます。また、XPOは既存のデータセンター環境でも使用でき、追加の物理スペースを必要とせずにアクセラレータの導入密度を高めることで、既存リソースの利用効率を向上させます。
XPOとCPOの主な違い
現在、光デバイスを接続する主な方法には、XPOとCPOの2つがあります。XPOは「深い統合」に重点を置いており、これはデバイスが完全に接続されていることを意味します。一方、CPOは利用可能なスペースを最大限に活用することに重点を置いており、これは差し込み可能なデバイスにとって重要です。
CPO: 最大限の性能を実現する究極の統合
Co-packaged Opticsは、光エンジンとスイッチングチップを直接統合します。その結果、信号経路が短くなり、損失が低減し、エネルギー効率が向上します。理論上、この設計はより高い帯域幅密度と低い消費電力を実現でき、より長期的な進化の道筋を示しています。
しかし、考慮すべき問題もいくつかあります。光学部品とスイッチングチップは密接に接続されています。光モジュールまたはその部品が正常に動作しない場合、作業はかなり複雑になる可能性があります。多くの場合、これはデバイス全体、さらにはシステム全体に変更を加えることを意味します。その結果、コストが上昇し、保守や交換がより複雑になる可能性があります。
CPOでは、製造プロセスとサプライチェーンにも極めて高い成熟度が求められます。現時点では、大規模な商用利用の準備が整っているかどうかは不明であるため、どの程度の速さで普及するかを判断するのは困難です。
XPO:プラガブルアーキテクチャにおけるエンジニアリングの最適化
XPOは、プラガブルアーキテクチャの使用をやめないため、CPOとは異なります。代わりに、現在のシステムを改善します。XPOは、チャネル密度の向上、液体冷却の追加、電源供給の改善によってCPOの性能に近づきます。また、同じモジュール式の交換可能性も維持します。
この設計は、保守性、アップグレードの柔軟性、導入コストの間で、より現実的なバランスを実現しており、現在の大規模データセンターにおけるエンジニアリング実装のニーズにより適しています。
エンジニアリングの観点から見た選択の違い
CPOは、極限のパフォーマンスや将来的な変化など、長期的な技術目標をより重視しています。しかし、短期的な導入には依然として課題があります。一方、XPOはより実用的な選択肢です。改善とシンプルさの維持を両立しているため、クラウドベンダーが大規模に導入しやすくなっています。
このため、安定性と保守性を重視するクラウドデータセンター環境では、プラガブルソリューションが依然として非常に魅力的です。
概要
全体として、XPOとCPOは単純な代替関係ではなく、むしろ長期的には異なるアプリケーションシナリオで共存する可能性が高いです。CPOはアーキテクチャの長期的な上限を示す一方、XPOは既存の業界エコシステム内でより速い進化の道筋を示します。データセンターネットワークの将来の形態は、「性能限界」と「エンジニアリング上の実現可能性」の間で続くトレードオフに大きく依存するでしょう。


共有
