


Apakah Kilang AI? Dan Mengapa Optik 800G/1.6T Menjadi Tulang Belakangnya
Pengarang Moore
Tarikh 03/20/2026

Peralihan daripada Pusat Data kepada Kilang AI
Sesuatu telah berubah secara senyap-senyap dalam cara infrastruktur dibina. Tidak lama dahulu, pusat data kebanyakannya berkaitan dengan storan, virtualisasi dan pengendalian permintaan pengguna. Kini keadaannya terasa berbeza. Beban kerja menjadi lebih berat, lebih berterusan dan dalam banyak kes tidak lagi berkaitan secara langsung dengan tindakan pengguna. Sistem AI berjalan di latar belakang, menjana, menaakul, mengulang, dan kadangkala melalui gelung tugas yang tidak pernah benar-benar “berakhir” dalam erti kata tradisional.
Konsep “kilang AI” bukan lagi sekadar kata kunci; ia semakin menjadi kenyataan. Data dimasukkan ke dalam model besar untuk pemprosesan dan penjanaan output berterusan. Sistem ini lebih menyerupai sistem perindustrian berbanding seni bina IT. Seperti yang dimaksudkan NVIDIA ketika melancarkan platform Rubin, matlamatnya adalah untuk melengkapkan revolusi seni bina ini. Cabaran yang kita hadapi hari ini melangkaui keupayaan perkakasan. Pada peringkat infrastruktur, kita mesti mempertimbangkan cara membina sistem yang mampu menyokong pengeluaran AI berskala besar sambil mengurangkan kos inferens dan meningkatkan kebolehramalan penggunaan.
Sebaik sahaja infrastruktur mula berfungsi seperti kilang, tekanan merebak ke seluruh susunan teknologi. Pengkomputeran hanyalah satu bahagiannya. Storan, memori, penjadualan, orkestrasi dan, khususnya, rangkaian semuanya mula menjadi penting dalam cara yang berbeza. Anda bukan sekadar memerlukan prestasi—anda memerlukan konsistensi di bawah beban, serta keupayaan untuk berkembang tanpa menyebabkan segala-galanya menjadi rapuh.
Di Dalam Platform Rubin: Reka Bentuk Sistem yang Berbeza
Jika dilihat dengan lebih dekat, Rubin sebenarnya tidak mengikuti corak peningkatan berperingkat yang lama. Ia lebih terasa seperti satu penetapan semula. Daripada menambah baik komponen yang berasingan, platform ini menyatukan pelbagai lapisan dan mengoptimumkannya sebagai satu keseluruhan. CPU Vera, GPU Rubin, NVLink 6, ConnectX-9 SuperNIC, BlueField-4 DPU dan Spectrum-6 Ethernet semuanya merupakan sebahagian daripada reka bentuk itu.
Penyelarasan seperti ini mengubah cara sistem berkelakuan. Sebagai contoh, beban kerja latihan MoE kini memerlukan GPU yang jauh lebih sedikit berbanding generasi terdahulu, tetapi itu tidak mengurangkan aktiviti keseluruhan. Ia hanya mengagihkannya semula. Inferens menjadi lebih kerap, model menjadi lebih kompleks dan beban kerja merentasi jujukan yang lebih panjang. Kesudahannya, sistem memindahkan lebih banyak data, bukannya kurang.
Sistem berskala rak NVL72 ialah contoh yang baik. Memasukkan berpuluh-puluh GPU ke dalam unit yang bersepadu rapat kedengaran cekap—dan sememangnya begitu—, tetapi ia juga mewujudkan corak komunikasi yang padat di dalam rak. Data tidak lagi hanya mengalir ke atas dan ke bawah. Data sentiasa bergerak secara sisi merentasi GPU, kumpulan memori dan pemecut. Tekanan dalaman itu akhirnya merebak ke rangkaian yang lebih luas.
Mengapa Kilang AI Memberi Tekanan kepada Rangkaian dengan Cara yang Berbeza
Rangkaian dalam Kilang AI cukup berbeza sehingga andaian lama mula tidak lagi terpakai. Isunya bukan sekadar permintaan lebar jalur yang lebih tinggi. Corak trafik juga berubah. Trafik timur-barat merupakan perkara utama dan biasanya kekal tinggi, bukannya berubah-ubah. GPU sentiasa bertukar data, terutamanya dalam senario latihan teragih dan inferens berbilang langkah. Kependaman menjadi lebih ketara, bukan secara teori tetapi dalam prestasi sebenar.
Pada masa yang sama, teknologi asas berkembang dengan pantas. Sebagai contoh, NVLink 6 meningkatkan lebar jalur GPU-ke-GPU ke tahap di mana setiap peranti boleh mengendalikan beberapa terabait sesaat. Di dalam satu rak, lebar jalur agregat meningkat sehingga ratusan terabait sesaat. Itu—bukan peningkatan kecil—ia merupakan skala yang sama sekali berbeza.
Dalam bidang Ethernet, NVIDIA Spectrum-X sedang mengubah cara rangkaian AI dibina. Daripada menganggap Ethernet sebagai fabrik serba guna, ia ditala khusus untuk beban kerja AI. Peningkatan kecekapan amat ketara, tetapi perkara yang lebih menonjol ialah kestabilan di bawah beban berterusan. Kluster AI tidak banyak berada dalam keadaan melahu, jadi masa beroperasi dan konsistensi mula menjadi sama penting dengan prestasi puncak.
Terdapat juga BlueField-4 dalam gabungan ini, yang mengalihkan sesetengah fungsi pengendalian data dan keselamatan daripada CPU. Ia tidak sentiasa mendapat perhatian yang sama, tetapi dalam penggunaan berskala besar, ia membantu memastikan segala-galanya kekal mudah diurus. Dan dengan peralihan ke arah storan natif AI, yang membolehkan konteks inferens digunakan semula merentas sesi, sistem keseluruhan mula kelihatan kurang seperti sekumpulan pelayan dan lebih seperti saluran paip yang diselaraskan.
Semua ini membawa kepada satu pemerhatian mudah. Rangkaian kini lebih daripada sekadar penyambung antara nod komputer. Rangkaian menjadi sebahagian daripada proses pengkomputeran itu sendiri. Dan apabila hal itu berlaku, batasan reka bentuk lama—terutamanya yang dibina berdasarkan andaian 400G—menjadi semakin ketara.
400G vs 800G vs 1.6T: Apakah yang Sebenarnya Berubah dan Mengapa Ia Penting
Beralih daripada 400G kepada 800G, atau bahkan 1.6T, mungkin kelihatan seperti peningkatan kelajuan yang mudah. Sebenarnya, perbezaannya lebih mendalam daripada sekadar angka lebar jalur.
400G masih mempunyai tempatnya. Ia digunakan secara meluas, agak matang dan berfungsi dengan baik dalam persekitaran yang mempunyai corak trafik yang boleh dijangka atau apabila trafik tidak sentiasa tepu. Untuk beban kerja awan tradisional atau kelompok AI yang lebih kecil, ia masih dapat memberikan keseimbangan yang munasabah antara kos dan prestasi. Masalahnya ialah AI Factories tidak lagi beroperasi sedemikian. Trafik lebih padat, lebih berterusan dan kurang bertolak ansur apabila kesesakan berlaku.
800G mula lebih masuk akal apabila seni bina suis beralih kepada SerDes 200G. Daripada menggabungkan banyak pautan yang lebih perlahan, anda memperoleh sambungan yang lebih jelas antara kapasiti suis dengan antara muka optik. Ini boleh memudahkan keadaan tertentu, tetapi yang lebih penting, ia meningkatkan produktiviti keseluruhan tanpa memerlukan ruang tambahan. Dalam kelompok GPU yang besar, kecekapan seperti ini terkumpul dengan pantas.
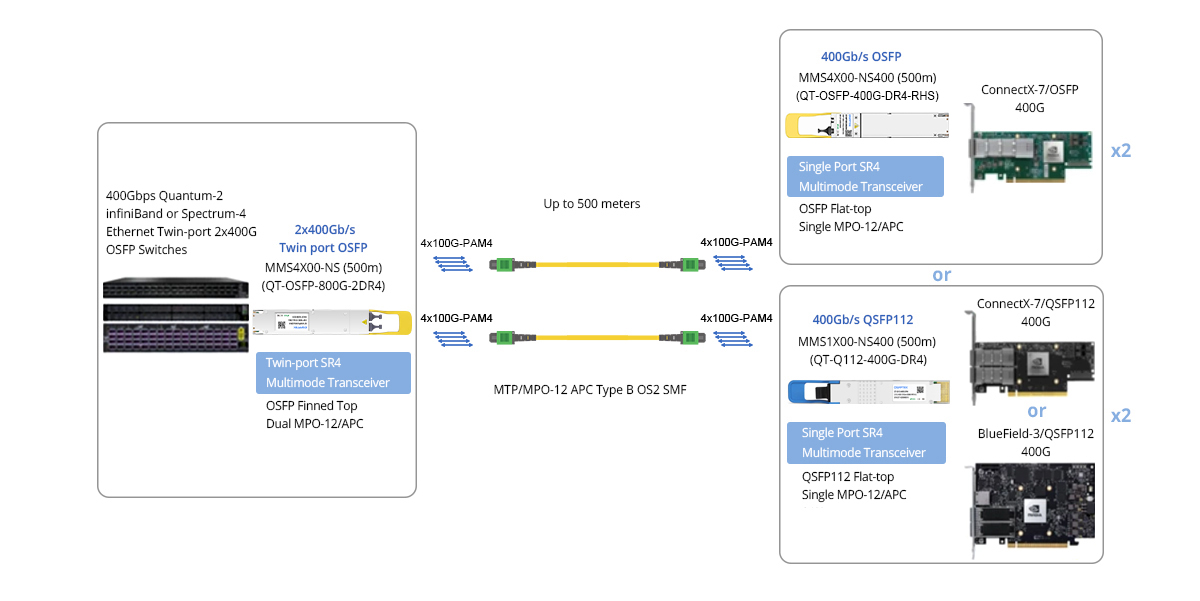
NVIDIA/Mellanox MMS4X00-NS 800G serasi dengan suis Quantum-2 dan Spectrum-4 berpenyejukan udara, sistem berpenyejukan cecair dan DGX-H100, DPU ConnectX-7 dan BlueField-3.
Kemudian terdapat 1.6T, yang sebenarnya tidak terasa seperti peningkatan, sebaliknya lebih seperti persediaan untuk langkah seterusnya. Ia membolehkan ketumpatan port yang lebih tinggi, bermakna lebih sedikit suis diperlukan untuk mencapai skala yang sama. Kecekapan kuasa bagi setiap bit juga bertambah baik, yang penting apabila penggunaan tenaga mula mengehadkan pengembangan. Dalam penggunaan AI yang sangat besar—bayangkan puluhan atau ratusan ribu GPU—perbezaan antara penskalaan dengan 800G dan beralih kepada 1.6T bukan sekadar teknikal; ia turut mempengaruhi model kos dan susun atur fizikal.
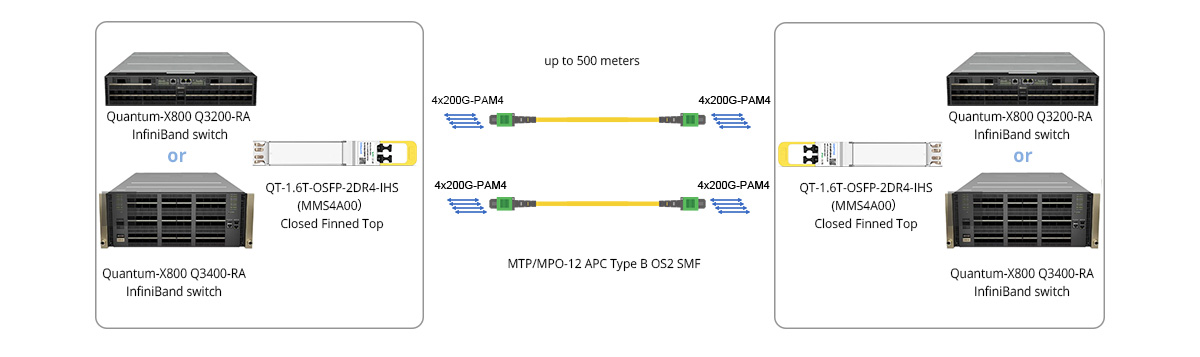
NVIDIA/Mellanox MMS4A00 1.6T serasi dengan suis Quantum-3 yang disejukkan udara dan disejukkan cecair.
Dalam amalan, pilihan-pilihan ini tidak saling menggantikan dalam sekelip mata. Biasanya, pilihan-pilihan ini digunakan bersama. 400G mungkin masih digunakan di pinggir atau dalam segmen yang kurang menuntut. 800G semakin menjadi fabrik utama untuk kluster AI semasa. 1.6T mula muncul dalam binaan baharu atau di bahagian rangkaian yang paling memerlukan kepadatan dan kecekapan. Pilihan "terbaik" bergantung kurang pada helaian spesifikasi dan lebih kepada cara sistem dijangka berubah dari semasa ke semasa.
Penyedia penyelesaian juga boleh membantu dalam hal ini. QSFPTEK, sebagai contoh, mempunyai 800G dan modul optik 1.6T, serta cara menyediakannya yang berfungsi dengan baik untuk pusat data AI. Fokusnya adalah pada cara peringkat ini disepadukan ke dalam seni bina sebenar, bukan sekadar pada peringkat kelajuan. Dalam sesetengah kes, mencampurkan generasi dalam rangkaian yang sama boleh menghasilkan keputusan yang lebih baik berbanding memaksa peningkatan penuh sekaligus.
Masa Depan: Mengapa 1.6T Lebih Dekat Daripada Yang Disangka
Walaupun 800G semakin biasa, ia tidak terasa seperti versi terakhir. Beban kerja AI semakin berkembang, tetapi tidak semestinya dalam cara yang sama. Model semakin besar, tetapi juga semakin interaktif. Inferens bukan lagi kitaran permintaan-tindak balas yang mudah. Ia boleh melibatkan berbilang langkah, alat luaran dan tetingkap konteks yang lebih panjang. Semua itu meningkatkan jumlah data yang bergerak melalui sistem.
Terdapat juga persoalan tentang skala yang melangkaui satu lokasi. Sesetengah seni bina baharu direka untuk menghubungkan beberapa pusat data ke dalam satu persekitaran logik. Ini menambahkan jarak ke dalam persamaan, bersama cabaran kependaman dan penyegerakan baharu.
Optik 1.6T sesuai dengan gambaran ini secara semula jadi. Ia tidak menyelesaikan segala-galanya, tetapi menghapuskan beberapa kekangan segera berkaitan lebar jalur dan ketumpatan. Daripada sentiasa mengatasi had, reka bentuk rangkaian menjadi sedikit lebih fleksibel semula. Itu sahaja sudah boleh memudahkan penggunaan berskala besar.
Kesimpulan
QSFPTEK telah membuat persediaan untuk senario sebegini dengan portfolio 1.6Tnya, serta penyelesaian infrastruktur AI yang lain. Ini bukan tentang sentiasa bergerak sepantas yang boleh. Ini lebih kepada menyediakan pilihan apabila rangkaian mencapai tahap di mana peningkatan berperingkat tidak lagi mencukupi.
Pada akhirnya, idea Kilang AI membawa semuanya kembali kepada aliran—bagaimana data bergerak, sepantas mana ia bergerak dan sejauh mana kebolehpercayaannya untuk sampai dari satu tempat ke tempat yang lain. Modul optik biasanya tidak mendapat banyak perhatian, tetapi ia terletak tepat pada laluan tersebut. Dan apabila sistem yang lain terus berkembang, peranannya menjadi semakin sukar untuk diabaikan.


Kongsi
