


На подходе масштабные нагрузки ИИ: как меняется инфраструктура центров обработки данных?
Автор Moore
Дата 09/18/2026

По мере расширения рабочих нагрузок ИИ на серверы и стойки итоговая производительность всей системы всё больше зависит от согласованной работы таких компонентов, как вычислительные ресурсы, сеть, хранилище, электропитание и охлаждение. Хотя пиковые показатели важны, они уже не дают полного представления об эффективной пропускной способности, масштабируемости или совокупных эксплуатационных затратах кластера.
Это заставляет всех при планировании и оценке инфраструктуры ИИ учитывать уровень стойки и всего кластера. Такой сдвиг в подходе меняет проектирование, расширение и развертывание базовых архитектур центров обработки данных, поэтому комплексное планирование, проверка на уровне системы и готовность к развертыванию становятся важнее, чем когда-либо. В этой статье рассматриваются эти изменения и практические трудности, которые они создают для крупномасштабной инфраструктуры ИИ.
Трансформация инфраструктуры центра обработки данных с использованием ИИ
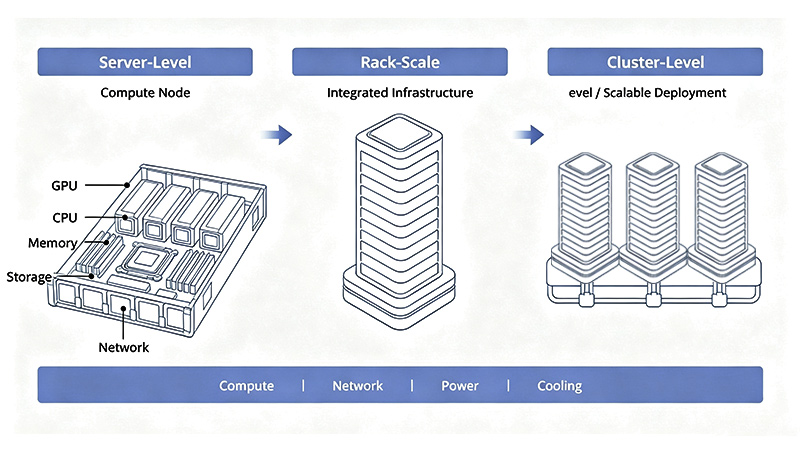
Для распределенного обучения или масштабного инференса ускорители должны постоянно обмениваться данными. Поэтому сетевые соединения, доступ к хранилищу, электропитание и охлаждение имеют критическое значение для стабильной работы всей системы. В результате планирование инфраструктуры давно вышло за рамки развертывания отдельных серверов и теперь охватывает стойки высокой плотности и даже кластеры из нескольких стоек. Серверы остаются базовыми вычислительными узлами, однако стойки и кластеры становятся все более важными единицами архитектурного проектирования.
GB300 NVL72 от NVIDIA — яркий пример такого подхода на уровне стойки. В эталонной архитектуре для предприятий стойка GB300 NVL72 с жидкостным охлаждением рассматривается как стандартный независимый модуль расширения, объединяющий 18 вычислительных лотков и 72 GPU. Чтобы создать более крупный вычислительный пул, можно подключить несколько таких модулей на уровне стоек и горизонтально масштабировать их с помощью специализированных вычислительных, конвергентных сетей и сетей управления.
Эту архитектуру нельзя эффективно реализовать, просто объединив несколько высокопроизводительных серверов. Для быстрой связи между узлами и удобного расширения в будущем кабельные сети, соединительные решения, подача питания и системы жидкостного охлаждения должны быть интегрированы в общую архитектуру инфраструктуры с самого начала.
Высокоплотные серверные стойки предъявляют огромные требования не только к электроснабжению и возможностям жидкостного охлаждения центра обработки данных, но и к пропускной способности сети, ее топологии и масштабируемости из-за интенсивного трафика между GPU и серверами.
Поэтому при планировании вычислительных кластеров сегодня ключевые вопросы уже не сводятся к простому выбору:
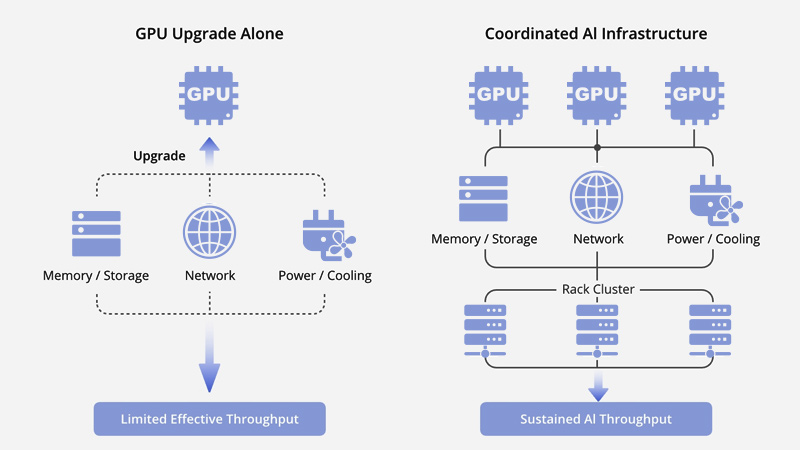
Производительность вычислительных систем ИИ: одних аппаратных обновлений недостаточно
Добавление более производительного оборудования действительно может улучшить системы ИИ, однако степень реализации этой ценности зависит от того, способна ли базовая инфраструктура преобразовать теоретические возможности устройств в реальную производительность при выполнении бизнес-операций.
Эффективность передачи данных
Пропускная способность хранилища и памяти, а также предварительная обработка данных и каналы ввода в совокупности определяют, сможет ли ускоритель своевременно получать данные. Даже небольшая задержка передачи данных приведёт к тому, что заманчивый теоретический вычислительный потенциал GPU будет потрачен впустую. Кроме того, производительность хранилища напрямую влияет на создание контрольных точек модели, восстановление после сбоев, извлечение признаков и обработку промежуточных данных. Поэтому при оценке этой возможности важно учитывать не параметры отдельного жёсткого диска или модуля памяти, а то, способен ли весь тракт передачи данных поддерживать фактическую рабочую нагрузку.
Реальная польза сетевой связи
Пропускная способность, заявляемая производителями для сетевые карты а коммутаторы обычно лишь отражают доступную физическую пропускную способность и не соответствуют фактической скорости при запуске приложений. На фактический коэффициент использования сети вычислительным кластером влияют все факторы: от топологии сети, избыточной пропускной способности и перегрузки сети до оптических линий, кабельной разводки, конфигурации программного обеспечения и даже производительности самого терминала. Часто, даже если для повышения предела пропускной способности используются более быстрые интерфейсы, прирост производительности на уровне приложения может быть непропорциональным.
Эффект масштабирования при расширении кластера
Добавление графических процессоров действительно может увеличить общую вычислительную мощность, но производительность бизнеса не обязательно вырастет пропорционально. Дополнительные затраты на синхронизацию узлов, планирование задач, взаимодействие нескольких машин и обмен данными постепенно сведут на нет преимущества нового оборудования.
Поэтому при проектировании инфраструктуры пиковые показатели, безусловно, являются важным ориентиром, но их необходимо всесторонне оценивать с учетом фактической загрузки ускорителей, эффективной пропускной способности, эффективности масштабирования и итогового времени выполнения задачи.
По мере масштабирования инфраструктуры ИИ: впереди несколько препятствий
Масштабирование инфраструктуры AI — это не только техническая задача, но и вопрос тщательных бизнес-расчётов. Предприятиям нужно учитывать не только объём дополнительных мощностей, которые они могут добавить, но и то, сколько времени потребуется для фактического развертывания этих вычислительных ресурсов и насколько эффективно они будут задействованы.
Ограничения физической инфраструктуры
При расширении сети до уровня стоек и кластера задача сводится не просто к увеличению скорости. Необходимо заново спланировать плотность портов, размещение коммутаторов, кабельную разводку, дальность передачи оптических модулей, модели трафика и коэффициенты резервирования. Сеть, хорошо работающая в небольших развертываниях, по мере роста кластера может потребовать полной перестройки архитектуры.
Электропитание и охлаждение также создают серьёзные ограничения. Недостаточная мощность или неэффективное охлаждение не только ограничивают плотность размещения оборудования в стойке и сокращают число устанавливаемых ускорительных карт, но и замедляют расширение инфраструктуры. Недостаточный резерв охлаждения может также привести к снижению частоты или ограничению работы оборудования при высоких нагрузках.
Поэтому развертывание между стойками часто имеет далеко идущие последствия: оно требует изменений в топологии сети, архитектуре хранения данных, системах электропитания и распределения энергии, охлаждении, а также в последующих процессах обслуживания и управления. Как увеличить емкость, не вызвав несбалансированного роста затрат на интеграцию или снижения производительности, — серьезная задача.
Капитальные инвестиции и график внедрения
Масштаб инвестиций выходит далеко за рамки GPU и серверов. Сети, системы хранения данных, стойки, оптические коммуникационные соединения, различные кабели, а также инфраструктура электропитания и охлаждения, модернизация центров обработки данных и инструменты для обслуживания—каждая статья расходов обходится дорого.
Кроме того, от закупки до фактического ввода вычислительных мощностей в эксплуатацию необходимо пройти несколько этапов: подготовка центра обработки данных, прокладка кабелей в стойках, настройка программного обеспечения, тестирование совместимости, проверка бизнес-процессов и окончательная передача. Узкое место на любом из этих этапов задержит поставку и ввод в эксплуатацию всего кластера.
Загрузка оборудования и тревога из-за обновления технологий
Ценность кластера ИИ нельзя оценивать только по его вычислительной мощности. Загрузка оборудования, энергопотребление, ежедневное обслуживание, затраты на управление и недоиспользуемые машины увеличивают общие эксплуатационные расходы.
Быстрый темп обновления аппаратного обеспечения, при котором стремительно меняются ускорители, сети, энергопотребление отдельных компонентов и технологии жидкостного охлаждения, постоянно сокращает жизненный цикл планирования инфраструктуры. Предприятиям необходимо найти баланс между текущими потребностями в вычислительных мощностях и потенциальными рисками, связанными с масштабированием в будущем и сложностями модификации.
Совместимость оборудования разных производителей
Инфраструктура ИИ обычно состоит из оборудования от нескольких поставщиков. Сетевые карты, коммутаторы, для оптических модулей, кабелей, серверов, а также разнообразных прошивок и программного обеспечения перед внедрением в рабочую среду необходимо провести тщательную проверку совместимости.
Чтобы свести к минимуму риски интеграции и устранения неполадок, спецификации следует определить заранее, сертифицированные комбинации оборудования необходимо протестировать, а обязанности каждой стороны по поддержке — четко разграничить.
В конечном счете это комплексная бизнес-задача: найти оптимальный баланс между капитальными вложениями, доступностью вычислительных ресурсов, загрузкой оборудования, ежедневными эксплуатационными расходами и долгосрочной гибкостью архитектуры.
Крупномасштабная инфраструктура ИИ: планирование и проверка
Требования к инфраструктуре для современных систем ИИ растут. Выбор оборудования определяется не только подбором отдельных компонентов: его необходимо рассматривать комплексно, в контексте полной архитектуры системы и рабочей нагрузки.
Глобальное планирование
Вычислительные мощности, сеть, системы хранения данных, а также электропитание и охлаждение—эти ключевые компоненты необходимо планировать комплексно с учётом потребностей бизнеса, масштаба развертывания, плотности размещения оборудования в стойках и планов будущего расширения.
В частности, топология сети, достаточность расстояний передачи оптических модулей, маршруты прокладки кабелей, распределение электропитания, методы охлаждения, доступ к хранилищу, физическая планировка центра обработки данных и планы будущего расширения— должны быть четко определены заранее. Это избавит от множества хлопот и позволит избежать чрезвычайно дорогостоящих переделок из-за несовместимости устройств при фактическом развертывании.
Проверка на уровне системы
Одних только спецификаций оборудования недостаточно, чтобы определить пригодность инфраструктуры ИИ. Для полной уверенности необходима всесторонняя проверка на уровне системы, которая в первую очередь включает:
Совместимость различных аппаратных компонентов;
Бесперебойная совместимость сетевых и оптических модулей связи;
Стабильная производительность системы хранения данных и всего пути передачи данных;
Обычная коммуникация в ходе реальной деловой деятельности;
Стабильная работа при полной нагрузке в течение длительного времени;
Стабильное электропитание и эффективное охлаждение;
Снижение эффективности при расширении между узлами и стойками.
Только завершив весь этот процесс, можно быть уверенным, что инфраструктура полностью надёжна при реальных нагрузках, а не просто показывает впечатляющие результаты в отдельных тестах компонентов.
Готовность к развертыванию
Готовность к развертыванию — это не просто закупка всего оборудования. Для быстрого ввода кластера в эксплуатацию и его развертывания необходима вся сопутствующая подготовка: стандартизированные шаблоны конфигурации, проверенные спецификации материалов (BOM), отчеты о проверке совместимости, надлежащая документация, процедуры установки и четкое распределение обязанностей по устранению неполадок—.
В дальнейшем построение инфраструктуры ИИ будет зависеть не только от того, у кого самые мощные машины, но и от того, насколько эффективно эти устройства спланированы, соединены и протестированы, чтобы работать вместе как единое целое.
Заключение
Современные центры обработки данных для ИИ уже давно вышли за рамки эпохи «оптимизации отдельных устройств» и полностью перешли к совместной работе на уровне системы. Высокие пиковые показатели производительности по-прежнему важны, однако фактическая эффективность использования вычислительных мощностей ИИ все больше зависит от согласованной работы вычислительных ресурсов, сети, систем хранения данных, электроснабжения и распределения питания, охлаждения, а также от всего процесса развертывания. Предприятиям нужна базовая архитектура, которая превращает теоретические возможности оборудования в реальные бизнес-ресурсы, отличающиеся гибкостью, надежностью и экономической эффективностью.
Для сетевых задач и межсоединений QSFPTEK предлагает комплексное решение, включающее высокоскоростные коммутаторы и сетевые адаптеры (NIC), оптические модули, а также структурированная кабельная система. Будучи важными компонентами архитектуры на уровне системы, они эффективно повышают общую совместимость сети, пропускную способность, масштабируемость и готовность к развертыванию, легко справляясь с чрезвычайно высокими требованиями ИИ-нагрузок. Приглашаем вас подробнее изучить решения QSFPTEK для ИИ и создать высокогибкую, тщательно проверенную основу межсоединений для вычислительных кластеров.


Поделиться
