


На пути к архитектуре Rubin: скачок сетей центров обработки данных для ИИ от 800G до 1.6T
Автор Leslie
Дата 04/02/2026

GPU-платформа NVIDIA Rubin следующего поколения приводит к фундаментальным изменениям в проектировании инфраструктуры ИИ. По мере роста рабочих нагрузок ИИ от миллиардов параметров до триллионов задачи выходят далеко за рамки вычислительной производительности. Эффективность системы зачастую в большей степени определяется способностью эффективно перемещать данные между тысячами GPU. В этом контексте сеть уже не является лишь вспомогательным уровнем, а становится ключевым компонентом, определяющим производительность ИИ. Эти системы изначально рассчитаны на массивный параллелизм с постоянным интенсивным обменом данными между узлами, что меняет логику проектирования центров обработки данных.
Что такое архитектура Rubin
Архитектура Rubin от NVIDIA является обновлением архитектуры Blackwell. Это полнофункциональная платформа совместных вычислений, специально разработанная для обучения сверхкрупных моделей ИИ и вывода с низкой задержкой. Она состоит из нескольких новых чипов, отличается более высокой производительностью и энергоэффективностью, поддерживает эффективное выполнение масштабных задач ИИ и служит ключевой инфраструктурой, обеспечивающей широкомасштабное развитие ИИ.
В отличие от предыдущих графических процессоров, которые в основном были ориентированы на повышение производительности одного чипа, Rubin с самого начала разрабатывался для крупномасштабных распределённых систем искусственного интеллекта. Его конечная цель — обеспечить эффективное обучение на кластерах, содержащих десятки тысяч графических процессоров.
В этой среде графическим процессорам необходимо непрерывно обмениваться градиентами, параметрами и промежуточными данными. Коммуникационная нагрузка чрезвычайно высока, а эффективность передачи данных напрямую влияет на скорость обучения. Хотя такие технологии, как InfiniBand и RDMA, позволяют снизить задержку и увеличить пропускную способность, они по-прежнему зависят от достаточной пропускной способности на физическом уровне.
Роль 800G в инфраструктуре ИИ
Соединения 800G постепенно стали де-факто стандартом для высокопроизводительной инфраструктуры ИИ. По сравнению с решениями 400G, 800G обеспечивает вдвое большую пропускную способность, сохраняя на данном этапе разумный баланс между энергопотреблением и сложностью развертывания.
При фактическом развертывании, Решения 800G демонстрируют четкое разделение труда в зависимости от сценариев применения:
DAC используются для соединения на сверхкоротких расстояниях между графическими процессорами и коммутаторами ToR внутри серверной стойки. Медная кабельная система практически не потребляет дополнительную мощность и обеспечивает минимальную задержку передачи, что делает ее предпочтительной средой для межсоединений высокой плотности внутри серверных стоек.
AOC подходят для соединений между серверными стойками на коротких и средних расстояниях. AOC объединяют оптические модули и кабели, упрощая процесс развертывания на месте, одновременно обеспечивая целостность сигнала и снижая требования к очистке и обслуживанию оптоволоконных интерфейсов.
Оптические модули используются на уровне магистрального ядра структурированных сетей, поддерживая межсоединения на больших расстояниях в архитектурах Spine-Leaf. Оптические модули вместе с системами оптоволоконной кабельной инфраструктуры обеспечивают расширение сети между POD и регионами.
Этот многоуровневый подход к развертыванию отражает реальные инженерные потребности крупномасштабных кластеров ИИ. В качестве примера можно привести QSFPTEK: его линейка продуктов 800G охватывает весь спектр DAC, AOC и оптических модулей. Ее ключевая ценность заключается в обеспечении стабильной совместимости для пользователей в трехуровневой сетевой архитектуре. В средах кластеров ИИ с высокой плотностью и высокой пропускной способностью стабильная совместимость между различными сценариями часто имеет большее значение, чем отдельный показатель производительности.
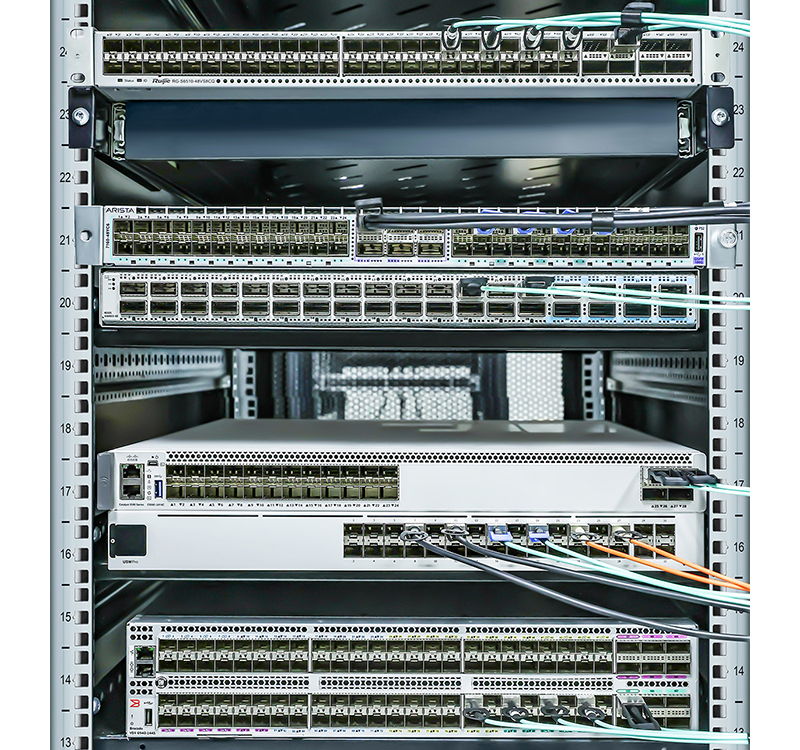
Ограничения 800G в эпоху Rubin
Хотя решения 800G уже доказали свою эффективность в современных кластерах ИИ, их ограничения становятся все более очевидными при переходе к следующему поколению вычислительной плотности, представленному архитектурой NVIDIA Rubin.
Основными источниками давления являются следующие три аспекта:
Стремительный рост плотности GPU: Количество графических процессоров в стойке увеличивается с текущих стандартных 8 до 16 или 32, а потребность в агрегированной пропускной способности внутри стойки стремительно возрастает с уровня Tbps до десятков Tbps, создавая серьезную проблему для коэффициента конвергенции портов коммутатора ToR.
Расширение размера кластера: Количество узлов кластера увеличивается с тысяч до десятков и даже сотен тысяч, а характер перегрузки сети меняется: от локальных узких мест к глобально распределенной перегрузке. Простое увеличение количества соединений приведет к сверхлинейному росту сложности кабельной разводки, энергопотребления и затрат на обслуживание;
Эволюция режимов связи: Новые стратегии параллелизма моделей, представленные параллелизмом экспертов (MoE), значительно увеличивают частоту синхронизации между GPU по сравнению с традиционной архитектурой Transformer, требуя от сетевой системы одновременного соответствия совокупным требованиям высокой пропускной способности и низкой задержки.
С точки зрения соответствия между вычислительными ресурсами и сетью, ожидается, что однокарточная вычислительная пропускная способность платформы Rubin будет более чем вдвое выше, чем у архитектуры Blackwell. Если пропускная способность сети останется неизменной, доля времени простоя вычислительных ресурсов в ожидании данных значительно возрастёт, напрямую ограничивая эффективное использование вычислительной мощности GPU.
Зачем нужны модули 1.6T
Развитие межсоединений 1.6T в значительной степени обусловлено жестким спросом на пропускную способность сети со стороны архитектур GPU следующего поколения. Его значение заключается не только в удвоении скоростей портов, но и в обеспечении технически реализуемого пути для устранения упомянутых выше структурных узких мест.
Ключевая ценность 1.6T проявляется в следующих аспектах:
Повышенная плотность пропускной способности: Один порт обеспечивает пропускную способность 200GB/s. Например, 48-портовый коммутатор может обеспечить совокупную пропускную способность почти 10Tbps, примерно вдвое сократив количество портов и занимаемое стоечное пространство по сравнению с решениями 800G;
Упрощенная топология: При одинаковом размере кластера 1.6T поддерживает более плоскую топологию сети, например упрощение трехуровневой архитектуры Clos до двухуровневой, сокращение количества устройств уровня Spine и одновременное уменьшение задержки, возникающей из-за пересылки между уровнями.
Снижение операционной сложности: Сокращение количества соединений напрямую приводит к одновременному уменьшению числа оптоволоконных жил, оптических модулей и точек отказа. В крупномасштабных кластерах этот эффект может значительно повысить эффективность эксплуатации.
QSFPTEK уже начала внедрение технологий в линейке продуктов 1.6T, предлагая несколько модули 1.6T для центров обработки данных с ИИ. Это означает, что они могут заранее спланировать интеграцию сетей следующего поколения в существующую инфраструктуру 800G, вместо того чтобы сталкиваться с необходимостью срочной модернизации во время полномасштабного развертывания архитектуры Rubin.
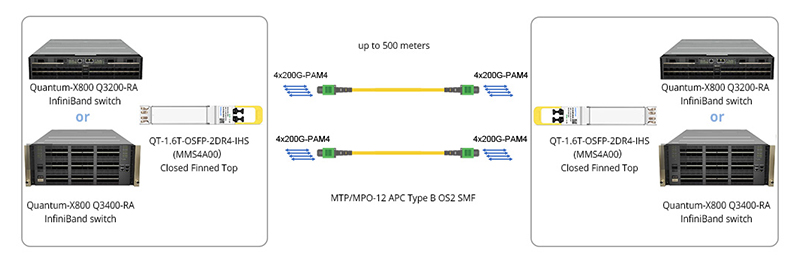
Рекомендуемый фактический путь модернизации
Переход с 800G на 1.6T в реальных средах центров обработки данных обычно происходит постепенно, а не в виде одномоментной полной замены.
Вы можете обратиться к следующему пути обновления:
Уровень доступа и межсоединения на коротких расстояниях: продолжайте использовать решения 800G DAC и AOC. Преимущества медной кабельной инфраструктуры и активных оптических кабелей с точки зрения энергопотребления и стоимости в краткосрочной перспективе остаются труднозаменимыми для сценариев на коротких расстояниях внутри стоек и между ними;
Уровень Spine и магистральное ядро: сначала внедрите оптические модули и коммутаторы 1.6T для передачи агрегированного трафика между POD, предусмотрев достаточный запас пропускной способности на уровне ядра для удовлетворения будущих потребностей в расширении;
Переход к гибридной архитектуре: обеспечьте гибридную работу оборудования 800G и 1.6T с помощью механизмов агрегации каналов или согласования скоростей, постепенно завершив замену поколений от уровня доступа до уровня ядра и избегая рисков единовременных капитальных затрат и прерывания обслуживания.
Для центров обработки данных, в которых уже развернута инфраструктура 800G, обычно предусматривается плавный переходный период продолжительностью 2-3 года. В этот период необходимо одновременно учитывать обратную совместимость оптических модулей, зарезервированную емкость кабельной системы и возможности многоскоростной координации операционной системы сети.
Заключение
Переход от оптических модулей 800G к модулям 1.6T необходим для поддержки архитектуры Rubin компании NVIDIA’s. Модули 1.6T обеспечивают более высокую плотность пропускной способности, более простую структуру сети и меньшую задержку, отвечая требованиям центров обработки данных нового поколения. Благодаря поэтапному обновлению пользователи могут плавно модернизировать свою инфраструктуру, в полной мере используя оптические решения QSFPTEK’s 1.6T для стабильного высокопроизводительного подключения кластеров.


Поделиться
