


Что такое фабрика ИИ? И почему оптика 800G/1.6T является ее основой
Автор Moore
Дата 03/20/2026

Переход от центров обработки данных к фабрикам ИИ
В способе построения инфраструктуры произошли незаметные изменения. Еще недавно дата-центр в основном был связан с хранением данных, виртуализацией и обработкой запросов пользователей. Теперь все ощущается иначе. Рабочие нагрузки стали более тяжелыми и непрерывными, а во многих случаях они даже не связаны с непосредственными действиями пользователей. Системы ИИ работают в фоновом режиме, генерируя, рассуждая, повторяя итерации, а иногда выполняя циклы задач, которые в традиционном смысле никогда по-настоящему не “заканчиваются”.
Концепция “фабрики ИИ” больше не является просто модным словом; она все чаще становится реальностью. Данные вводятся в большие модели для обработки и непрерывной генерации результатов. Эта система больше напоминает промышленную систему, чем IT-архитектуру. Как и предполагала NVIDIA при запуске платформы Rubin, цель заключается в завершении этой архитектурной революции. Современные вызовы выходят за рамки возможностей оборудования. На уровне инфраструктуры необходимо подумать о том, как построить систему, способную поддерживать крупномасштабное производство ИИ, одновременно снижая затраты на инференс и повышая предсказуемость развертывания.
Как только инфраструктура начинает работать подобно фабрике, нагрузка распространяется на весь стек. Вычислительные ресурсы — лишь одна его часть. Хранилища, память, планирование, оркестрация и особенно сети начинают играть разную, но важную роль. Вам нужна не просто производительность—вам нужна стабильность под нагрузкой и возможность масштабирования без того, чтобы вся система становилась хрупкой.
Внутри платформы Rubin: другой подход к проектированию систем
Если рассмотреть Rubin внимательнее, становится ясно, что он не совсем следует старой схеме поэтапных обновлений. Скорее, это похоже на перезапуск. Вместо улучшения отдельных компонентов платформа объединяет несколько уровней и оптимизирует их как единое целое. В эту конструкцию входят CPU Vera, GPU Rubin, NVLink 6, SuperNIC ConnectX-9, DPU BlueField-4 и Ethernet Spectrum-6.
Такая координация меняет поведение систем. Например, для обучающих нагрузок MoE теперь требуется значительно меньше GPU по сравнению с предыдущими поколениями, но это не снижает общую активность. Она лишь перераспределяется. Вывод выполняется чаще, модели становятся сложнее, а нагрузки охватывают более длинные последовательности. В итоге система перемещает больше данных, а не меньше.
Система NVL72 в масштабе стойки служит наглядным примером. Размещение десятков графических процессоров в одном тесно интегрированном блоке кажется эффективным—и так оно и есть—, но оно также создает плотные коммуникационные потоки внутри стойки. Данные больше не перемещаются только вверх и вниз. Они постоянно передаются горизонтально между графическими процессорами, пулами памяти и ускорителями. Это внутреннее напряжение в конечном итоге выходит в более широкую сеть.
Почему сети испытывают нагрузку от фабрик ИИ иначе
Сеть внутри AI Factory настолько отличается, что прежние представления начинают терять актуальность. Дело не только в более высокой потребности в пропускной способности. Изменяется характер трафика. Главную роль играет трафик «восток — запад», который обычно остаётся высоким, а не колеблется. GPU постоянно обмениваются данными, особенно в сценариях распределённого обучения и многоэтапного вывода. Задержка становится более заметной не в теории, а с точки зрения фактической производительности.
В то же время базовые технологии развиваются стремительно. Например, NVLink 6 увеличивает пропускную способность между GPU до уровня, при котором каждое устройство может обрабатывать несколько терабайт в секунду. В пределах одной стойки суммарная пропускная способность достигает сотен терабайт в секунду. Это не небольшое улучшение—это совершенно иной масштаб.
В сфере Ethernet NVIDIA Spectrum-X меняет подход к построению сетей ИИ. Вместо того чтобы рассматривать Ethernet как универсальную фабрику, его специально оптимизируют для рабочих нагрузок ИИ. Повышение эффективности очевидно, но еще более примечательна стабильность при длительной нагрузке. Кластеры ИИ редко простаивают, поэтому безотказная работа и стабильность становятся не менее важными, чем пиковая производительность.
В эту систему также входит BlueField-4, который переносит некоторые функции обработки данных и безопасности с CPU. Ему не всегда уделяют много внимания, но в крупномасштабных развертываниях он помогает поддерживать управляемость системы. А с переходом к хранилищам, ориентированным на AI, где контекст инференса можно повторно использовать между сеансами, общая система начинает выглядеть не столько как набор серверов, сколько как скоординированный конвейер.
Все это приводит к простому наблюдению. В наши дни сеть — это нечто большее, чем просто соединитель между вычислительными узлами. Она становится частью самого вычислительного процесса. И как только это происходит, ограничения более старых конструкций—особенно основанных на предположениях о 400G—становятся более очевидными.
400G против 800G против 1.6T: что на самом деле меняется и почему это важно
Переходя от 400G переход к 800G или даже 1.6T может показаться простым повышением скорости. На самом деле различия выходят далеко за рамки показателей пропускной способности.
У 400G по-прежнему есть своё место. Эта технология широко внедрена, относительно зрелая и хорошо работает в средах с предсказуемыми схемами трафика или там, где трафик не достигает постоянной насыщенности. Для традиционных облачных нагрузок или даже небольших кластеров ИИ она по-прежнему может обеспечивать разумный баланс между стоимостью и производительностью. Проблема в том, что фабрики ИИ больше так не работают. Трафик стал более плотным и непрерывным, а возникающие узкие места стали менее допустимыми.
Переход к архитектуре коммутаторов на базе 200G SerDes делает 800G более целесообразным. Вместо объединения множества более медленных соединений обеспечивается более четкая связь между пропускной способностью коммутатора и оптическими интерфейсами. В некоторых ситуациях это упрощает систему, но, что еще важнее, повышает общую производительность без необходимости увеличения занимаемого пространства. В крупных кластерах GPU такая эффективность быстро дает значительный результат.
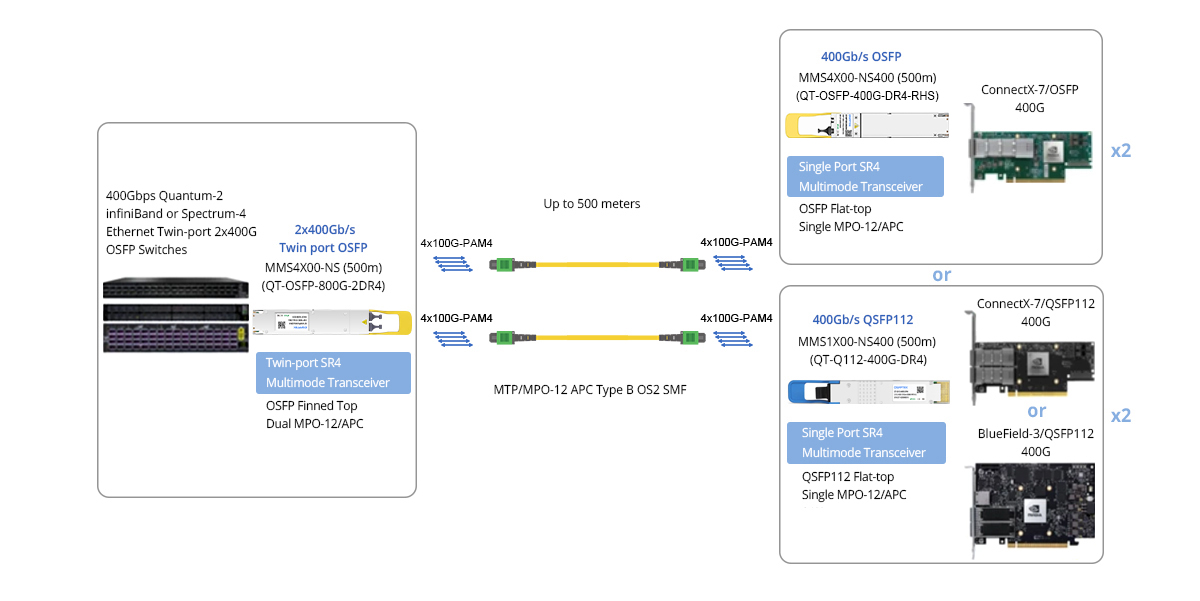
800G NVIDIA/Mellanox MMS4X00-NS совместим с коммутаторами Quantum-2 и Spectrum-4 с воздушным охлаждением, системами с жидкостным охлаждением и DGX-H100, а также DPU ConnectX-7 и BlueField-3.
Затем появляется 1.6T, который на самом деле не воспринимается как обновление, а скорее как подготовка к следующему этапу. Он обеспечивает более высокую плотность портов, то есть для достижения того же масштаба требуется меньше коммутаторов. Энергоэффективность на бит также повышается, что важно, поскольку энергопотребление начинает ограничивать расширение. При очень крупных развертываниях ИИ—представьте десятки или сотни тысяч GPU—разница между масштабированием с использованием 800G и переходом на 1.6T имеет не только техническое значение, но и влияет на модели затрат и физическую компоновку.
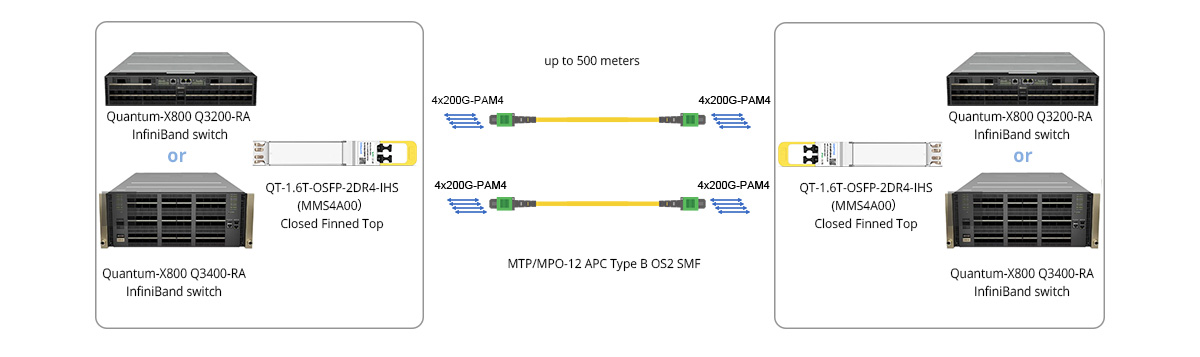
1.6T NVIDIA/Mellanox MMS4A00 совместим с воздухоохлаждаемыми и жидкостноохлаждаемыми коммутаторами Quantum-3.
На практике эти варианты не заменяют друг друга в одночасье. Обычно они хорошо сосуществуют. 400G по-прежнему может использоваться на периферии или в менее требовательных сегментах. 800G становится основной фабричной сетью для современных кластеров ИИ. 1.6T начинает появляться в новых конфигурациях или в частях сети, где плотность и эффективность имеют первостепенное значение. «Лучший» выбор зависит не столько от технических характеристик, сколько от того, как, согласно ожиданиям, система будет изменяться со временем.
Здесь также могут помочь поставщики решений. Например, у QSFPTEK есть решения на 800G и Оптические модули 1.6T, а также способы их настройки, хорошо подходящие для центров обработки данных с ИИ. Основное внимание уделяется тому, как эти уровни вписываются в реальные архитектуры, а не только скоростным уровням. В некоторых случаях смешивание поколений в одной сети может дать лучшие результаты, чем принудительное полное обновление за один раз.
Взгляд в будущее: почему 1.6T ближе, чем кажется
Хотя 800G становится все более распространенным, это не похоже на окончательный вариант. Рабочие нагрузки AI растут, но не всегда одинаковым образом. Модели становятся больше, однако они также становятся более интерактивными. Вывод больше не представляет собой простой цикл запроса и ответа. Он может включать несколько этапов, внешние инструменты и более длинные контекстные окна. Все это увеличивает объем данных, проходящих через систему.
Также возникает вопрос масштабирования за пределами одного объекта. Некоторые из новых архитектур предназначены для объединения нескольких центров обработки данных в единую логическую среду. Это добавляет в уравнение расстояние, а также новые проблемы, связанные с задержкой и синхронизацией.
Оптические модули 1.6T вполне естественно вписываются в эту картину. Они не решают всех проблем, но снимают некоторые непосредственные ограничения, связанные с пропускной способностью и плотностью размещения. Вместо постоянного поиска обходных решений для ограничений проектирование сети снова становится немного более гибким. Уже одно это может упростить крупномасштабные развертывания.
Заключение
QSFPTEK подготовилась к такому сценарию с помощью своей линейки 1.6T, а также других решений для инфраструктуры ИИ. Речь не о том, чтобы всегда двигаться настолько быстро, насколько это возможно. Гораздо важнее иметь готовую возможность, когда сеть достигнет точки, в которой постепенных обновлений будет недостаточно.
В конечном счёте идея AI Factory возвращает нас к потоку—к тому, как перемещаются данные, насколько быстро они перемещаются и насколько надёжно они передаются из одного места в другое. Оптические модули обычно не привлекают особого внимания, но находятся прямо на этом пути. И по мере дальнейшего масштабирования остальной системы их роль становится всё труднее игнорировать.


Поделиться
