


Massive KI-Workloads kommen: Welche Veränderungen durchläuft die Rechenzentrumsinfrastruktur?
Autor Moore
Datum 09/18/2026

Da sich KI-Workloads über Server und Racks hinweg ausweiten, hängt die endgültige Leistung des gesamten Systems zunehmend vom koordinierten Betrieb von Elementen wie Rechenleistung, Netzwerk, Speicher, Stromversorgung und Kühlung ab. Während Spitzenparameter auf dem Papier wichtig sind, stellen sie den effektiven Durchsatz, die Skalierbarkeit oder die Gesamtbetriebskosten eines Clusters nicht mehr vollständig dar.
Dies zwingt alle dazu, bei der Planung und Bewertung von KI-Infrastrukturen ihre Perspektive auf die Ebene des Racks und des gesamten Clusters zu erweitern. Dieser Wandel im Denken verändert die Gestaltung, Erweiterung und Bereitstellung der zugrunde liegenden Architekturen von Rechenzentren und macht eine umfassende Planung, eine systemweite Verifizierung und die Einsatzbereitschaft wichtiger denn je. Dieser Artikel untersucht diese Veränderungen und die praktischen Herausforderungen, die sie für groß angelegte KI-Infrastrukturen mit sich bringen.
Transformation der KI-Rechenzentrumsinfrastruktur durch KI
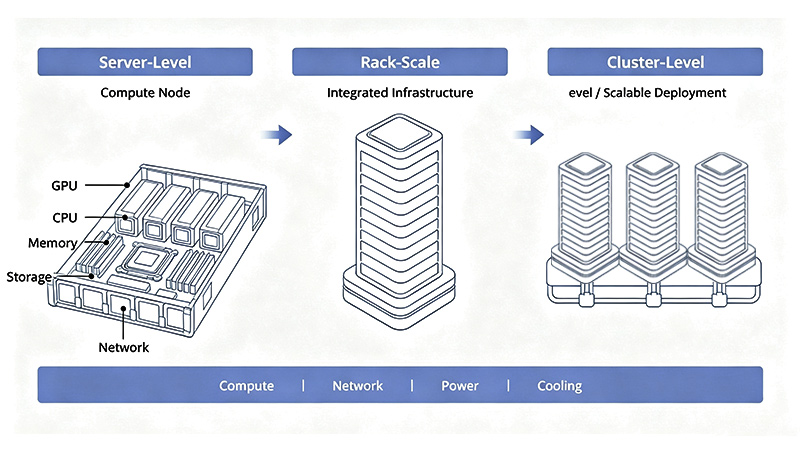
Bei verteiltem Training oder groß angelegter Inferenz müssen Beschleuniger ständig Daten austauschen. Dadurch sind Netzwerkverbindungen, Speicherzugriff, Stromversorgung und Kühlleistung für die Stabilität des gesamten Systems äußerst kritisch. Daher geht die Planung der aktuellen Infrastruktur längst über einzelne Serverbereitstellungen hinaus und umfasst hochdichte Racks sowie sogar Cluster aus mehreren Racks. Server bleiben zwar die grundlegendsten Rechenknoten, doch Racks und Cluster werden zunehmend zu zentralen Einheiten der Architekturplanung.
NVIDIAs GB300 NVL72 ist ein herausragendes Beispiel für diesen Ansatz auf Rack-Ebene. In ihrer Referenzarchitektur für Unternehmen wird ein flüssigkeitsgekühltes GB300 NVL72-Rack als standardmäßige unabhängige Erweiterungseinheit behandelt, die 18 Compute-Trays und 72 GPUs integriert. Um einen größeren Computing-Pool zu schaffen, können mehrere solcher Einheiten auf Rack-Ebene über dedizierte Computing-Netzwerke, konvergierte Netzwerke und Verwaltungsnetzwerke verbunden und horizontal erweitert werden.
Diese Architektur lässt sich nicht effizient nutzen, indem lediglich eine Vielzahl von Hochleistungsservern zusammengestellt wird. Für eine schnelle Kommunikation zwischen Knoten und ein einfaches zukünftiges Wachstum müssen Netzwerkverkabelung, Interconnects, Stromversorgung und Flüssigkühlung von Anfang an in das Gesamtdesign der Infrastruktur integriert werden.
Hochdichte Server-Racks stellen nicht nur enorme Anforderungen an die Stromversorgung und die Flüssigkeitskühlung des Rechenzentrums, sondern der massive Ost-West-Datenverkehr zwischen GPUs und Servern stellt auch höhere Anforderungen an Netzwerkbandbreite, Topologie und Skalierbarkeit.
Daher lauten die zentralen Fragen bei der Planung von Rechenclustern heute nicht mehr einfach:
Leistung der KI-Rechenleistung: Hardware-Upgrades allein reichen nicht aus
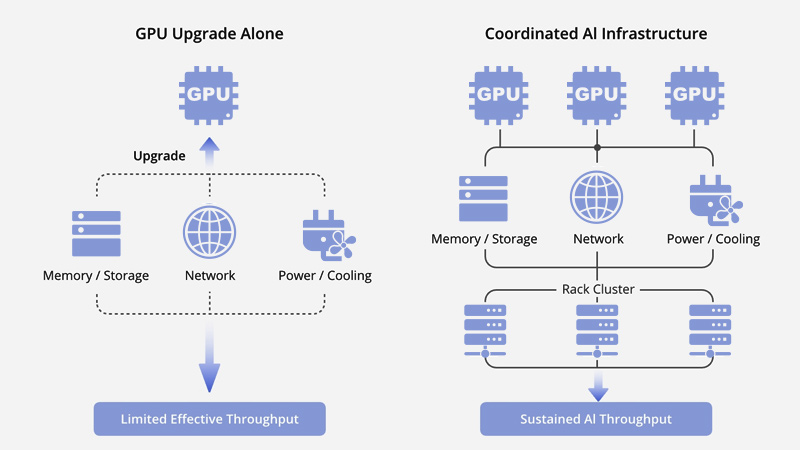
Das einfache Hinzufügen leistungsstärkerer Hardware kann KI-Systeme tatsächlich verbessern. In welchem Umfang dieser Nutzen jedoch realisiert wird, hängt davon ab, ob die zugrunde liegende Infrastruktur die theoretischen Fähigkeiten dieser Geräte im Geschäftsbetrieb tatsächlich in messbare Ergebnisse umsetzen kann.
Effizienz des Datenpfads
Der Speicherdurchsatz, die Speicherbandbreite sowie die Datenvorverarbeitung und Eingangskanäle bestimmen gemeinsam, ob der Beschleuniger rechtzeitig Daten empfangen kann. Wenn die Datenübertragung auch nur geringfügig zu langsam ist, bleibt die verlockende theoretische Rechenleistung der GPU ungenutzt. Darüber hinaus wirkt sich die Speicherleistung direkt auf das Speichern von Modellprüfpunkten, die Fehlerwiederherstellung, den Abruf von Merkmalen und die Verarbeitung von Zwischendaten aus. Daher besteht der Maßstab für die Messung dieser Fähigkeit nicht darin, sich auf die Parameter einer einzelnen Festplatte oder eines einzelnen Speichermoduls zu konzentrieren, sondern zu bewerten, ob der gesamte Datenpfad die tatsächliche Geschäftsarbeitslast unterstützen kann.
Die tatsächlichen Vorteile der Netzwerkkommunikation
Die von den Herstellern angegebene Bandbreite für Netzwerkkarten und Switches stellen normalerweise nur die verfügbare physische Kapazität dar und entsprechen nicht der tatsächlich erreichten Geschwindigkeit bei der Ausführung von Anwendungen. Von der Netzwerktopologie, Überkapazität und Netzwerküberlastung über optische Verbindungen, Verkabelung und Softwarekonfiguration bis hin zur Leistung des Endgeräts selbst beeinflusst alles die tatsächliche Auslastung des Netzwerks durch den Rechencluster. Selbst wenn schnellere Schnittstellen verwendet werden, um das Kommunikationslimit zu erhöhen, steht die Leistungssteigerung auf der Anwendungsseite oft nicht in einem proportionalen Verhältnis dazu.
Der Skalierungseffekt der Cluster-Erweiterung
Das Hinzufügen von GPUs kann die gesamte Rechenleistung tatsächlich erhöhen, aber die Geschäftsleistung wird dadurch nicht unbedingt proportional steigen. Der zusätzliche Aufwand für Knotensynchronisierung, Aufgabenplanung, Zusammenarbeit mehrerer Maschinen und Kommunikation wird die Vorteile der neu hinzugefügten Hardware allmählich aufzehren.
Daher sind Spitzenparameter beim Entwurf einer Infrastruktur sicherlich ein unverzichtbarer Indikator, müssen jedoch umfassend in Verbindung mit der tatsächlichen Auslastung des Beschleunigers, dem effektiven Durchsatz, der Effizienz der Erweiterung und der endgültigen Aufgabenausführungszeit betrachtet werden.
Mit der Skalierung der KI-Infrastruktur: Mehrere Hürden stehen bevor
Die Skalierung der KI-Infrastruktur ist nicht nur eine technische Herausforderung, sondern erfordert auch eine sorgfältige wirtschaftliche Kalkulation. Unternehmen müssen nicht nur berücksichtigen, wie viel zusätzliche Kapazität sie hinzufügen können, sondern auch, wie lange es dauern wird, bis diese Rechenleistung tatsächlich bereitgestellt ist, und wie effizient ihre Nutzung sein wird.
Die Grenzen der physischen Infrastruktur
Sobald Sie die Rack- und Clusterebene erreichen, geht es bei der Netzwerkerweiterung nicht einfach nur um die Erhöhung der Netzwerkgeschwindigkeit. Portdichte, Switch-Positionierung, Verkabelung, Übertragungsentfernung optischer Module, Verkehrsmodelle und Überdimensionierungsverhältnisse müssen allesamt neu geplant werden. Ein Netzwerk, das bei kleinen Implementierungen gut funktioniert, kann mit zunehmender Clustergröße eine vollständige Überarbeitung der Architektur erfordern.
Auch Stromversorgung und Kühlung stellen erhebliche Einschränkungen dar. Eine unzureichende Stromversorgung oder unzureichende Kühlung begrenzt nicht nur die Rack-Dichte und reduziert die Anzahl der installierten Beschleunigerkarten, sondern verlangsamt auch den Ausbauprozess. Unzureichende Kühlungsreserven können außerdem dazu führen, dass Maschinen bei hoher Last eine Frequenzdrosselung oder Betriebseinschränkungen erfahren.
Daher haben rackübergreifende Bereitstellungen oft weitreichende Folgen und erfordern Anpassungen an Netzwerktopologie, Speicherarchitektur, Stromversorgung und -verteilung, Kühlung sowie sogar an späteren Servicezugängen und Verwaltungsprozessen. Wie lässt sich die Kapazität erhöhen, ohne unausgewogene Integrationskosten oder Leistungseinbußen zu verursachen? Das ist eine große Herausforderung.
Kapitalinvestition und Zeitplan für die Implementierung
Der Investitionsumfang geht weit über GPUs und Server hinaus. Netzwerk, Speicher, Racks, optische Kommunikationsverbindungen, verschiedene Kabel sowie Stromversorgungs- und Kühlinfrastruktur, Renovierungen von Rechenzentren und Wartungswerkzeuge—jeder einzelne Posten stellt eine erhebliche Ausgabe dar.
Darüber hinaus gibt es von der Beschaffung bis zur tatsächlichen Inbetriebnahme der Rechenleistung mehrere Phasen: Vorbereitung des Rechenzentrums, Rack-Verkabelung, Softwarekonfiguration, Interoperabilitätstests, Geschäftsvalidierung und abschließende Übergabe. Jeder Engpass in einer dieser Phasen verzögert die Lieferung und Verfügbarkeit des gesamten Clusters.
Sorgen hinsichtlich der Gerätenutzung und des Technologie-Upgrades
Der Wert eines KI-Clusters lässt sich nicht allein anhand seiner Rechenleistung messen. Die Gerätenutzung, der Energieverbrauch, die tägliche Wartung, die Verwaltungskosten und nicht ausgelastete Maschinen tragen allesamt zu steigenden Gesamtbetriebskosten bei.
Das hohe Tempo der Hardware-Weiterentwicklung mit schnellen Änderungen bei Beschleunigern, Netzwerken, dem Stromverbrauch einzelner Komponenten und der Flüssigkühlungstechnologie verkürzt ständig den Lebenszyklus der Infrastrukturplanung. Unternehmen müssen ein Gleichgewicht zwischen ihrem aktuellen Bedarf an Rechenleistung und den potenziellen Risiken künftiger Skalierbarkeit sowie Schwierigkeiten bei Änderungen finden.
Multi-Vendor-Interoperabilität
KI-Infrastrukturen bestehen typischerweise aus einer Sammlung von Geräten verschiedener Anbieter. Netzwerkkarten, Switches, optische Module, Kabel, Server sowie eine Vielzahl von Firmware und Software erfordern vor dem produktiven Einsatz eine strenge Kompatibilitätsprüfung.
Um Integrations- und Fehlerbehebungsrisiken zu minimieren, sollten Spezifikationen frühzeitig definiert, zertifizierte Kombinationen getestet und die Supportverantwortlichkeiten jeder Partei geklärt werden.
Letztlich handelt es sich um ein umfassendes wirtschaftliches Abwägungsspiel: Es gilt, das optimale Gleichgewicht zwischen Kapitalinvestitionen, Verfügbarkeit von Rechenleistung, Geräteauslastung, täglichen Betriebskosten und der langfristigen Flexibilität der Architektur zu finden.
KI-Infrastruktur im großen Maßstab: Planung und Validierung
Die Infrastruktur-Anforderungen für moderne KI steigen. Weit mehr als die Auswahl einzelner Komponenten bestimmt die Hardware-Auswahl; sie muss ganzheitlich im Kontext der vollständigen Systemarchitektur und der Workload betrachtet werden.
Globale Planung
Rechenleistung, Netzwerk, Speicher sowie Stromversorgung und Kühlung—diese Kernkomponenten müssen ganzheitlich auf Grundlage Ihrer Geschäftsanforderungen, des Bereitstellungsumfangs, der Rack-Dichte und der Pläne für zukünftige Erweiterungen geplant werden.
Insbesondere Netzwerktopologie, die Angemessenheit der Übertragungsentfernungen der optischen Module, Kabelwege, Stromverteilung, Kühlmethoden, Speicherzugriff, physisches Layout des Rechenzentrums und zukünftige Erweiterungspläne— müssen alle im Voraus klar definiert werden. Dies erspart erheblichen Aufwand und vermeidet äußerst kostspielige Nacharbeiten aufgrund von Geräteinkompatibilität während der tatsächlichen Bereitstellung.
Validierung auf Systemebene
Die alleinige Betrachtung von Hardwarespezifikationen auf dem Papier reicht nicht aus, um die Nutzbarkeit einer KI-Infrastruktur zu bestimmen. Um vollständige Sicherheit zu gewährleisten, ist eine umfassende Verifizierung auf Systemebene erforderlich, die hauptsächlich Folgendes umfasst:
Kompatibilität zwischen verschiedenen Hardwarekomponenten;
Reibungslose Interoperabilität zwischen Netzwerk- und optischen Kommunikationsmodulen;
Nachhaltige Leistung des Speichers und des gesamten Datenpfads;
Normale Kommunikation während des realen Geschäftsbetriebs;
Stabiler Betrieb unter Volllast über längere Zeiträume;
Stabile Stromversorgung und Kühlleistung;
Effizienzverschlechterung bei der Erweiterung über Knoten und Racks hinweg.
Erst wenn Sie diesen gesamten Prozess abgeschlossen haben, können Sie sicher sein, dass Ihre Infrastruktur unter realen Lasten absolut zuverlässig ist, statt lediglich beeindruckende Ergebnisse in einzelnen Komponententests zu erzielen.
Bereitschaft für die Bereitstellung
Die Bereitschaft für die Bereitstellung besteht nicht nur darin, die gesamte Hardware zu kaufen. Standardisierte Konfigurationsvorlagen, validierte Stücklisten (BOMs), Kompatibilitätstestberichte, eine ordnungsgemäße Dokumentation, Installationsverfahren und klar zugewiesene Verantwortlichkeiten für die Fehlerbehebung—all diese Aspekte der nicht-technischen Bereitschaft sind erforderlich, um Ihren Cluster so schnell wie möglich online zu bringen und bereitzustellen.
Mit Blick auf die Zukunft wird der Aufbau einer KI-Infrastruktur nicht mehr allein davon abhängen, wer über die leistungsstärksten Maschinen verfügt, sondern vielmehr davon, wie effektiv diese Geräte geplant, verbunden und getestet werden, damit sie als voll funktionsfähiges Ganzes zusammenarbeiten können.
Fazit
Moderne KI-Rechenzentren haben die Ära der „Optimierung einzelner Geräte“ längst hinter sich gelassen und sich vollständig auf kollaborative Abläufe auf Systemebene verlagert. Auch wenn beeindruckende Spitzenleistungsparameter weiterhin von Bedeutung sind, hängt die tatsächliche Auslastung der KI-Rechenleistung zunehmend von der Koordination von Rechenleistung, Netzwerk, Speicher, Stromversorgung und -verteilung, Kühlung sowie dem gesamten Bereitstellungsprozess ab. Für Unternehmen besteht der tatsächliche Bedarf in einer zugrunde liegenden Architektur, die die theoretischen Fähigkeiten der Hardware in hochflexible, zuverlässige und kosteneffiziente tatsächliche Geschäftskapazitäten überführt.
Für Netzwerk- und Interconnect-Anforderungen bietet QSFPTEK eine Komplettlösung, einschließlich Hochgeschwindigkeits-Switches und Netzwerkschnittstellenkarten (NICs), optische Moduleund strukturierte Verkabelung. Als entscheidender Bestandteil der Architektur auf Systemebene verbessern diese Komponenten effektiv die allgemeine Netzwerkkompatibilität, die Gesamtbandbreite, die Skalierbarkeit und die Einsatzbereitschaft und bewältigen mühelos äußerst anspruchsvolle KI-Workloads. Wir laden Sie ein, die KI-Lösungen von QSFPTEK näher kennenzulernen und eine hochflexible, umfassend erprobte Interconnect-Grundlage für Ihre Computing-Cluster zu schaffen.


Teilen
