


Siliziumphotonik und CPO überwinden die Netzwerkgrenzen von 1.6T
Autor Leslie
Datum 09/01/2026

Siliziumphotonik und Co-Packaged Optics gestalten die Interconnect-Infrastruktur von KI-Rechenzentren für die 1,6T-Ära neu. Mit zunehmendem Umfang des Trainings großer Modelle wird der Bedarf an ultrahoher Bandbreite innerhalb von GPU-Clustern immer dringlicher. Herkömmliche steckbare optische Module stoßen bei ihrer Weiterentwicklung hin zu höheren Frequenzbereichen hinsichtlich thermischer und elektrischer Leistung an physikalische Grenzen und werden dadurch zu einem kritischen Engpass, der die vollständige Ausschöpfung der Rechenleistung einschränkt. Die beschleunigte kommerzielle Einführung von Siliziumphotonik- und CPO-Technologien wird voraussichtlich die Leistungsaufnahmebarriere für intelligente Computing-Netzwerke der nächsten Generation grundlegend überwinden.
Leistungsaufnahmegrenzen steckbarer optischer Module
Herkömmliche steckbare optische Module haben Netzwerke in der Datenverarbeitung bisher aufgrund ihrer flexiblen Einsatzmöglichkeiten dominiert. Mit dem Anstieg der Datenraten pro Lane auf 224 Gbit/s PAM4 sind jedoch die elektrischen Einschränkungen ihrer herkömmlichen physischen Architektur deutlich zutage getreten.
In Netzwerken mit herkömmlichen optischen Modulen müssen sich elektrische Hochgeschwindigkeitssignale vom Switching-Chip über Leiterbahnen auf der Hauptplatine—über zehn Zentimeter—bis zur Frontblende ausbreiten. Bei diesen Geschwindigkeiten erreicht die Nyquist-Frequenz des Signals 56 GHz; über solche Entfernungen leiden Hochfrequenzsignale unter einem starken Skin-Effekt und dielektrischen Verlusten, wobei der Kanaleinfügungsverlust häufig 30 dB überschreitet.
Um die daraus resultierende extreme Signaldämpfung und -verzerrung auszugleichen, müssen herkömmliche optische Module leistungsstarke DSP-Chips zur digitalen Signalverarbeitung integrieren. Dadurch steigen die physische Größe und der Stromverbrauch des Moduls erheblich. Beim 1.6T-Knoten nähert sich der Stromverbrauch eines einzelnen Moduls 30 W. Wenn ein 102.4T-Core-Switch vollständig bestückt ist mit 1.6T optische Module, die allein von den optischen Interconnects erzeugte Wärme beträgt mehrere Kilowatt. Eine derart extreme Wärmestromdichte macht herkömmliche Luftkühlungslösungen untragbar, während das Layout der Kaltplatten und die Rohrleitungsführung für Flüssigkeitskühlsysteme enorme technische Herausforderungen darstellen.
Architektonische Entwicklung von Siliziumphotonik und CPO
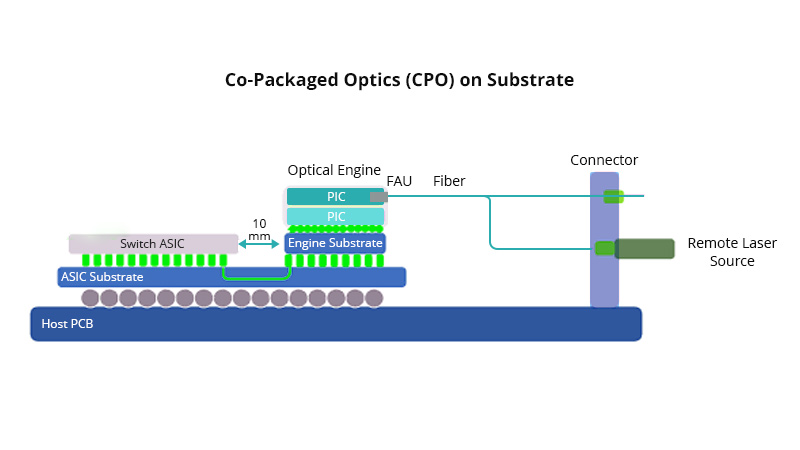
Um die durch die Leiterbahnführung des Motherboards auferlegten physikalischen Einschränkungen zu überwinden, bieten Siliziumphotonik- und Co-Packaged-Optics-Architekturen eine bahnbrechende Lösung, indem sie die Geräteintegration verbessern und elektrische Verbindungen verkürzen.
Herkömmliche optische Module basieren auf Baugruppen aus diskreten optischen Komponenten, was zu sperrigen Gehäusen und hohen optischen Signalverlusten führt. Im Gegensatz dazu nutzt die Siliziumphotonik ausgereifte CMOS-Halbleiterprozesse, um Modulatoren, Detektoren und passive Wellenleiter stark zu miniaturisieren und auf einem einzigen Chip auf Siliziumbasis zu integrieren. Diese grundlegende Neugestaltung von Materialien und Prozessen macht komplexe Stapelungen optischer Komponenten an der Quelle überflüssig, ermöglicht eine extreme Miniaturisierung optoelektronischer Bauelemente und gewährleistet eine hohe Konsistenz in der Massenfertigung.
Aufbauend auf den hohen Integrationsgraden, die durch Siliziumphotonik erreicht wurden, gestaltet CPO die physische Topologie der Geräte weiter um. CPO nutzt fortschrittliche Gehäusetechnologie, um die siliziumphotonische Engine und den Netzwerk-Switching-ASIC auf einem einzigen Multi-Chip-Substrat gemeinsam zu integrieren. Dieses Design komprimiert den physischen Übertragungsweg für elektrische Hochgeschwindigkeitssignale drastisch—und reduziert die Entfernung von über zehn Zentimetern auf der Hauptplatine auf nur wenige Millimeter innerhalb des Substrats. Diese ultrakurzen Verbindungen reduzieren die Kanalabschwächung erheblich und ermöglichen es dem System, eine stromsparende lineare Direktantriebsarchitektur einzusetzen und die Abhängigkeit von energiehungrigen DSP-Chips grundlegend zu beseitigen.
Systemenergieeffizienz und Bandbreitendichte
Der Wechsel von diskreten Komponenten zu hochintegrierten siliziumbasierten Lösungen—und von langen Leiterplattenleitungen zu direkten Verbindungen auf Substratebene—hat die zugrunde liegende Architektur grundlegend neu strukturiert und greifbare, multidimensionale Systemvorteile geschaffen.
Der unmittelbarste Durchbruch ist eine deutliche Reduzierung des Energieverbrauchs pro übertragenem Bit. Durch den Wegfall stromhungriger DSP-Chips senkt die CPO-Architektur den gesamten Stromverbrauch der Kommunikationsverbindung um mehr als 30%. Gleichzeitig beseitigt das Entfernen des DSP die rechnerische Latenz, die der digitalen Signalverarbeitung innewohnt. Im Kontext kollektiver Kommunikation für groß angelegtes verteiltes Training reduziert diese Hardware-Pass-Through-Fähigkeit im Mikrosekundenbereich die Synchronisationswartezeiten zwischen Knoten drastisch und steigert effektiv die tatsächliche Rechenauslastung von GPU-Clustern.
Auf Topologieebene schafft CPO auf der Vorderseite des Switches vollständig Platz. Die Vorderseite des Geräts muss keine sperrigen steckbaren Käfige mehr aufnehmen und behält nur hochdichte Glasfaser-Schnittstellen sowie externe Laserquellen (ELS). Dadurch wird es möglich, innerhalb eines 1RU-Formfaktors eine extrem hohe Switching-Leistung von über 102.4 Tbps zu erreichen; dies vereinfacht nicht nur die Leaf-Spine-Netzwerkhierarchien, sondern reduziert auch die Komplexität der Glasfaserverkabelung für Cluster mit zehntausenden GPUs erheblich.
QSFPTEK-Siliziumphotoniklösungen für 1,6T
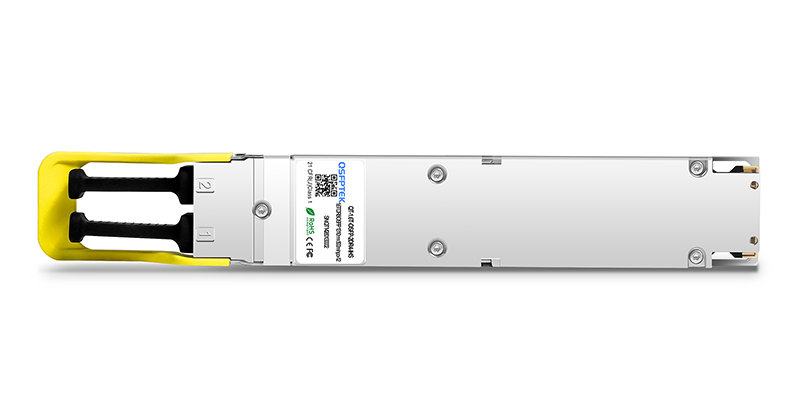
Während des Übergangs zu CPO-Architekturen bleiben leistungsstarke steckbare Module auf Basis der Siliziumphotonik-Technologie die praktische Grundlage für die Skalierung der Rechenleistung. Um die Anforderungen groß angelegter KI-Computing-Cluster zu erfüllen, hat QSFPTEK das 1.6T OSFP224 und die 800G-Serie von Siliziumphotonikmodulen, die einen einkanaligen 224Gbps-Prozess nutzt. Durch den Einsatz hochintegrierter siliziumphotonischer Chips reduzieren diese Dual-Rate-Produkte sowohl die Anzahl diskreter Komponenten als auch den Stromverbrauch im Betrieb erheblich. Gestützt durch strenge Signalintegritätstests gewährleistet das gesamte Hochgeschwindigkeits-Siliziumphotonik-Portfolio von QSFPTEK’ eine stabile Interoperabilität auf niedriger Ebene mit gängigen Netzwerkgeräten und erleichtert Rechenzentren den reibungslosen Übergang zu Netzwerkarchitekturen der nächsten Generation.
Fazit
Für Netzwerkknoten mit 1.6T und mehr hat der herkömmliche Ansatz, eine höhere Bandbreite durch eine verstärkte elektrische Signal-Kompensation zu erzielen, seine physikalischen Grenzen erreicht. Während steckbare Hochgeschwindigkeitsmodule—wie das 1.6T OSFP224—den unmittelbaren Anforderungen an die Skalierung der Rechenleistung gerecht werden, stellen Siliziumphotonik und co-packaged optics die wichtigsten Wege dar, um langfristige Herausforderungen beim Stromverbrauch von Interconnects zu bewältigen. Mit der weiteren Reifung siliziumbasierter photonischer Integrations- und Verpackungstechnologien entwickeln sich Rechenzentrumsnetzwerke stetig in eine neue Ära der Neugestaltung der Computing-Infrastruktur, die durch architektonische Einfachheit und hohe Energieeffizienz gekennzeichnet ist.


Teilen
