


Was ist eine KI-Fabrik? Und warum 800G/1.6T-Optiken ihr Rückgrat sind
Autor Moore
Datum 03/20/2026

Der Wandel von Rechenzentren zu KI-Fabriken
Etwas hat sich stillschweigend in der Art und Weise verändert, wie Infrastruktur aufgebaut wird. Vor nicht allzu langer Zeit ging es in einem Rechenzentrum hauptsächlich um Speicher, Virtualisierung und die Bearbeitung von Benutzeranfragen. Jetzt fühlt es sich anders an. Die Workloads sind schwerer, kontinuierlicher und in vielen Fällen nicht einmal an direkte Benutzeraktionen gebunden. KI-Systeme laufen im Hintergrund, generieren, schlussfolgern, iterieren und durchlaufen manchmal Aufgaben, die im traditionellen Sinne nie wirklich “enden”.
Das Konzept der “KI-Fabrik” ist längst nicht mehr nur ein Schlagwort; es wird zunehmend Realität. Daten werden zur Verarbeitung und kontinuierlichen Ausgabegenerierung in große Modelle eingespeist. Dieses System ähnelt eher einem industriellen System als einer IT-Architektur. Genau wie NVIDIA es bei der Einführung der Rubin-Plattform beabsichtigte, besteht das Ziel darin, diese architektonische Revolution abzuschließen. Die Herausforderungen, vor denen wir heute stehen, gehen über die Fähigkeiten der Hardware hinaus. Auf Infrastrukturebene müssen wir überlegen, wie wir ein System aufbauen können, das eine KI-Produktion in großem Maßstab unterstützt, gleichzeitig die Inferenzkosten senkt und die Vorhersagbarkeit der Bereitstellung verbessert.
Sobald sich Infrastruktur wie eine Fabrik verhält, breitet sich der Druck über den gesamten Stack aus. Compute ist nur ein Teil davon. Storage, Arbeitsspeicher, Scheduling, Orchestrierung und insbesondere Networking beginnen alle auf unterschiedliche Weise wichtig zu werden. Sie benötigen nicht nur Performance—Sie benötigen Konsistenz unter Last und die Fähigkeit zur Skalierung, ohne dass alles fragil wird.
Ein Blick in die Rubin-Plattform: Eine andere Art des Systemdesigns
Bei genauerer Betrachtung von Rubin folgt es nicht wirklich dem alten Muster inkrementeller Upgrades. Es fühlt sich eher wie ein Neustart an. Statt isolierte Komponenten zu verbessern, führt die Plattform mehrere Ebenen zusammen und optimiert sie als Ganzes. Die Vera CPU, Rubin GPU, NVLink 6, ConnectX-9 SuperNIC, BlueField-4 DPU und Spectrum-6 Ethernet sind alle Teil dieses Designs.
Diese Art der Koordination verändert das Verhalten von Systemen. Beispielsweise benötigen MoE-Trainingsworkloads heute im Vergleich zu früheren Generationen deutlich weniger GPUs, doch das verringert die Gesamtaktivität nicht. Es verteilt sie lediglich neu. Inferenz wird häufiger, Modelle werden komplexer, und Workloads erstrecken sich über längere Sequenzen. Am Ende bewegt das System mehr Daten, nicht weniger.
Das rackskalierte NVL72-System ist ein gutes Beispiel. Dutzende von GPUs in eine eng integrierte Einheit zu packen, klingt effizient—und das ist es auch—, aber es erzeugt auch dichte Kommunikationsmuster innerhalb des Racks. Daten fließen nicht mehr nur nach oben und unten. Sie bewegen sich ständig seitlich zwischen GPUs, Speicherpools und Beschleunigern. Dieser interne Druck greift schließlich auf das breitere Netzwerk über.
Warum KI-Fabriken das Netzwerk auf andere Weise belasten
Das Netzwerk innerhalb einer AI Factory unterscheidet sich so stark, dass ältere Annahmen nicht mehr greifen. Es geht nicht nur darum, dass ein höherer Bandbreitenbedarf besteht. Das Verkehrsmuster ändert sich. East-West-Traffic ist der Hauptfaktor, und er bleibt in der Regel hoch, statt zu schwanken. GPUs tauschen ständig Daten aus, insbesondere in Szenarien mit verteiltem Training und mehrstufiger Inferenz. Latenz wird deutlicher sichtbar, nicht in der Theorie, sondern in der tatsächlichen Leistung.
Gleichzeitig entwickeln sich die zugrunde liegenden Technologien rasant weiter. NVLink 6 beispielsweise steigert die GPU-zu-GPU-Bandbreite auf ein Niveau, bei dem jedes Gerät mehrere Terabyte pro Sekunde verarbeiten kann. Innerhalb eines einzelnen Racks steigt die aggregierte Bandbreite auf Hunderte von Terabyte pro Sekunde. Das ist kein kleiner Schritt nach oben—das ist ein völlig anderer Maßstab.
Im Bereich Ethernet verändert NVIDIA Spectrum-X die Art und Weise, wie KI-Netzwerke aufgebaut werden. Anstatt Ethernet als universelles Fabric zu behandeln, wird es gezielt auf KI-Workloads abgestimmt. Die Effizienzsteigerungen sind deutlich, aber noch mehr fällt die Stabilität unter anhaltender Last auf. KI-Cluster bleiben kaum im Leerlauf, daher werden Betriebszeit und Konsistenz ebenso wichtig wie Spitzenleistung.
Außerdem ist BlueField-4 mit dabei, das einige Datenverarbeitungs- und Sicherheitsfunktionen von der CPU weg verlagert. Es bekommt nicht immer so viel Aufmerksamkeit, aber in groß angelegten Bereitstellungen hilft es, die Dinge überschaubar zu halten. Und mit der Entwicklung hin zu KI-nativem Storage, bei dem Inferenzkontext sitzungsübergreifend wiederverwendet werden kann, wirkt das Gesamtsystem zunehmend weniger wie eine Ansammlung von Servern und mehr wie eine koordinierte Pipeline.
All dies führt zu einer einfachen Beobachtung. Das Netzwerk ist heutzutage mehr als nur ein Verbindungselement zwischen Computerknoten. Es wird selbst Teil des Berechnungsprozesses. Und sobald das geschieht, werden die Einschränkungen älterer Designs—insbesondere solcher, die auf 400G-Annahmen basieren—deutlicher.
400G vs 800G vs 1.6T: Was sich tatsächlich ändert und warum es wichtig ist
Wechsel von 400G auf 800G oder sogar 1.6T mag wie ein unkompliziertes Geschwindigkeitsupgrade erscheinen. In Wirklichkeit gehen die Unterschiede tiefer als reine Bandbreitenzahlen.
400G hat weiterhin seinen Platz. Es ist weit verbreitet, relativ ausgereift und funktioniert gut in Umgebungen mit vorhersehbaren Verkehrsmustern oder dort, wo der Datenverkehr nicht ständig ausgelastet ist. Für traditionelle Cloud-Workloads oder sogar kleinere KI-Cluster kann es weiterhin ein vernünftiges Gleichgewicht zwischen Kosten und Leistung bieten. Das Problem ist, dass sich AI Factories heute nicht mehr so verhalten. Der Datenverkehr ist dichter, kontinuierlicher und weniger fehlertolerant, wenn Engpässe auftreten.
800G ergibt mehr Sinn, wenn Switch-Architekturen in Richtung 200G SerDes übergehen. Anstatt eine Reihe langsamerer Links zu kombinieren, entsteht eine klarere Verbindung zwischen der Kapazität des Switches und den optischen Schnittstellen. Das kann die Dinge in manchen Situationen vereinfachen, aber vor allem steigert es die Gesamtproduktivität, ohne mehr Platz zu benötigen. In großen GPU-Clustern summiert sich diese Art von Effizienz schnell.
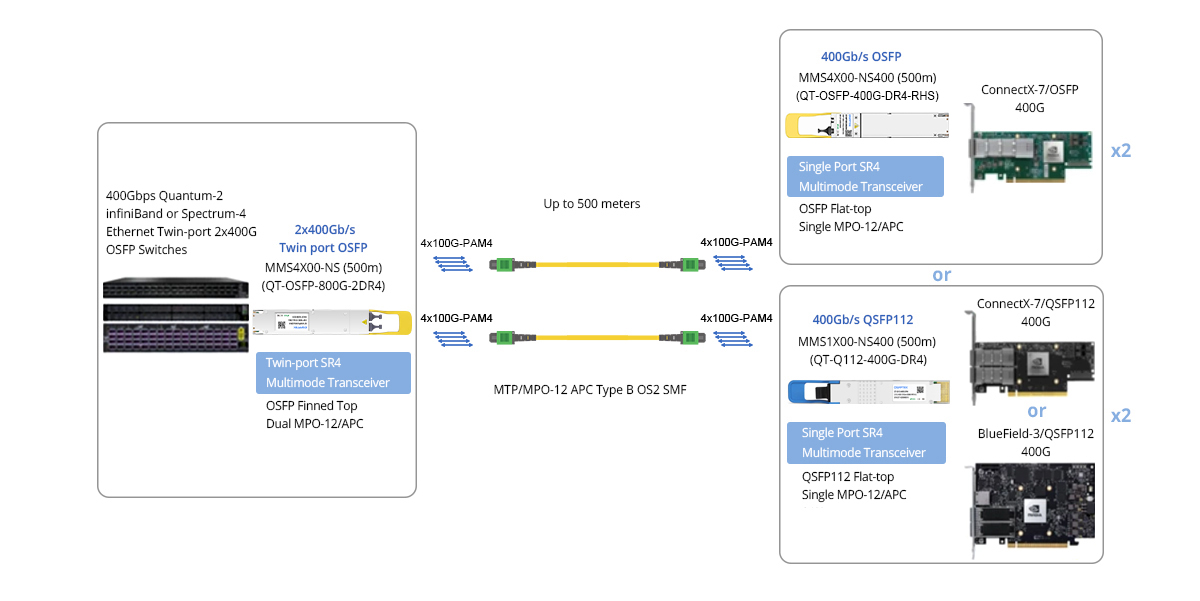
Der 800G NVIDIA/Mellanox MMS4X00-NS ist kompatibel mit Quantum-2 und Spectrum-4 luftgekühlten Switches, flüssigkeitsgekühlten und DGX-H100-Systemen, ConnectX-7 und BlueField-3 DPUs.
Dann gibt es noch 1.6T, das sich nicht wirklich wie ein Upgrade anfühlt, sondern eher so, als würden sie sich auf den nächsten Schritt vorbereiten. Es ermöglicht eine höhere Portdichte, was bedeutet, dass weniger Switches benötigt werden, um dieselbe Skalierung zu erreichen. Auch die Energieeffizienz pro Bit verbessert sich, was wichtig ist, da der Energieverbrauch zunehmend die Erweiterung begrenzt. Bei sehr großen KI-Implementierungen—denken Sie an Zehn- oder Hunderttausende von GPUs—ist der Unterschied zwischen der Skalierung mit 800G und dem Sprung auf 1.6T nicht nur technischer Natur; er wirkt sich auch auf Kostenmodelle und das physische Layout aus.
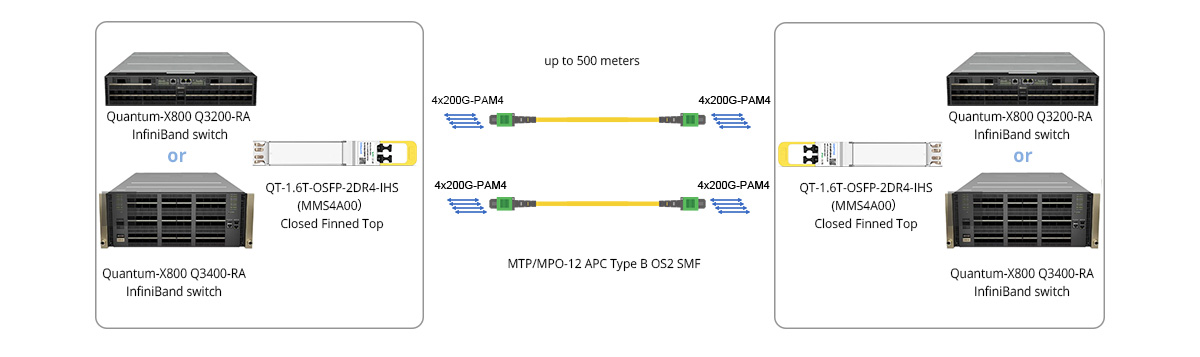
Das 1.6T NVIDIA/Mellanox MMS4A00 ist mit luftgekühlten und flüssigkeitsgekühlten Quantum-3-Switches kompatibel.
In der Praxis ersetzen sich diese Optionen nicht über Nacht gegenseitig. Sie kommen normalerweise miteinander aus. 400G könnte weiterhin am Edge oder in weniger anspruchsvollen Segmenten verwendet werden. 800G wird zum Haupt-Fabric für aktuelle KI-Cluster. 1.6T erscheint zunehmend in neuen Installationen oder in Teilen des Netzwerks, in denen Dichte und Effizienz am wichtigsten sind. Die "beste" Wahl hängt weniger vom Datenblatt ab als vielmehr davon, wie sich das System im Laufe der Zeit voraussichtlich verändern wird.
Auch hier können Lösungsanbieter helfen. QSFPTEK beispielsweise bietet 800G und 1.6T optische Module, sowie Möglichkeiten, sie so einzurichten, dass sie für KI-Rechenzentren gut funktionieren. Der Fokus liegt darauf, wie diese Ebenen in reale Architekturen passen, nicht nur auf Geschwindigkeitsstufen. In einigen Fällen kann das Mischen von Generationen innerhalb desselben Netzwerks zu besseren Ergebnissen führen, als eine vollständige Aufrüstung auf einmal zu erzwingen.
Ausblick: Warum 1.6T näher ist, als es scheint
Obwohl 800G immer verbreiteter wird, fühlt es sich nicht so an, als wäre es die endgültige Version. KI-Workloads wachsen, aber nicht immer auf die gleiche Weise. Modelle werden größer, aber sie werden auch interaktiver. Inferenz ist kein einfacher Anfrage-Antwort-Zyklus mehr. Sie kann mehrere Schritte, externe Tools und längere Kontextfenster umfassen. All das erhöht die Datenmenge, die sich durch das System bewegt.
Es stellt sich auch die Frage der Skalierung über einen einzelnen Standort hinaus. Einige der neueren Architekturen sind darauf ausgelegt, mehrere Rechenzentren zu einer einzigen logischen Umgebung zu verbinden. Dadurch kommt die Entfernung ins Spiel, zusammen mit neuen Herausforderungen bei Latenz und Synchronisierung.
1.6T-Optik passt ganz natürlich in dieses Bild. Sie löst nicht alles, beseitigt aber einige der unmittelbaren Einschränkungen bei Bandbreite und Dichte. Anstatt ständig Grenzen umgehen zu müssen, wird das Netzwerkdesign wieder etwas flexibler. Das allein kann große Bereitstellungen vereinfachen.
Fazit
QSFPTEK hat sich mit seinem 1.6T-Portfolio sowie anderen KI-Infrastrukturlösungen auf diese Art von Szenario vorbereitet. Es geht nicht darum, immer so schnell wie möglich zu gehen. Es geht vielmehr darum, die Option bereitzuhalten, wenn das Netzwerk einen Punkt erreicht, an dem inkrementelle Upgrades nicht mehr ausreichen.
Am Ende führt die Idee einer AI Factory alles wieder auf den Datenfluss zurück—wie Daten sich bewegen, wie schnell sie sich bewegen und wie zuverlässig sie von einem Ort zum anderen gelangen. Optische Module erhalten normalerweise nicht viel Aufmerksamkeit, aber sie liegen genau in diesem Pfad. Und da der Rest des Systems weiter skaliert, wird ihre Rolle immer schwerer zu ignorieren.


Teilen
