


Entrenamiento de IA frente a inferencia de IA: por qué requieren arquitecturas de red diferentes
Autor Moore
Fecha 08/03/2026

A medida que las empresas aceleran la adopción de la IA, el entrenamiento de IA y la inferencia de IA aparecen cada vez más en la misma estrategia de infraestructura. Sin embargo, tratarlos como cargas de trabajo similares puede conducir fácilmente a errores en la planificación de red. En realidad, la diferencia entre entrenamiento e inferencia va mucho más allá del nivel de aplicación; corresponden a objetivos de rendimiento, características de tráfico y prioridades operativas completamente diferentes. Esto dicta que una arquitectura de red no puede depender de un único modelo de programación de tráfico para gestionar ambos extremos simultáneamente.
¿Qué es el entrenamiento de IA?
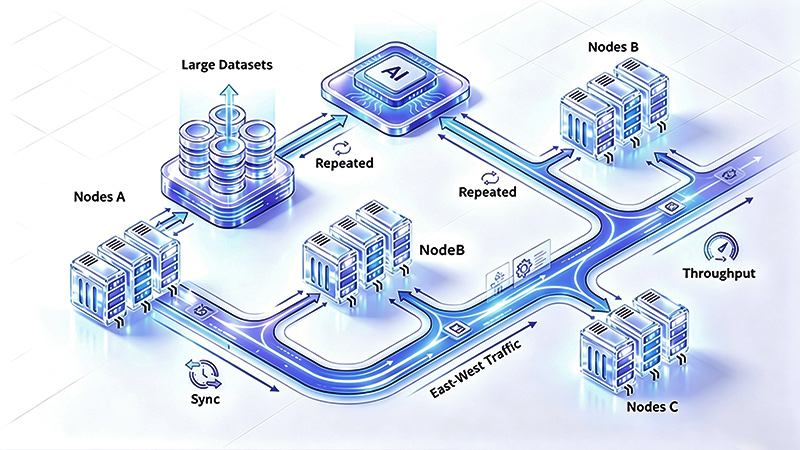
Entrenar una IA implica construir y mejorar continuamente un modelo desde el principio utilizando una gran cantidad de datos y cálculos repetidos. El objetivo es sencillo: en un entorno grande y distribuido, se busca mejorar la precisión del modelo y minimizar el tiempo de entrenamiento.
En la mayoría de los casos, el entrenamiento de IA genera mucho tráfico de red entre GPU, servidores y clústeres. Este tipo de carga de trabajo depende en gran medida de contar con suficiente ancho de banda, buenos mecanismos de sincronización y un rendimiento predecible. Por eso, al diseñar redes para entornos de entrenamiento, normalmente se centran en mantener las canalizaciones de datos a plena capacidad, eliminar los cuellos de botella de comunicación y admitir la computación paralela a gran escala dentro de la infraestructura general de IA.
¿Qué es la inferencia de IA?
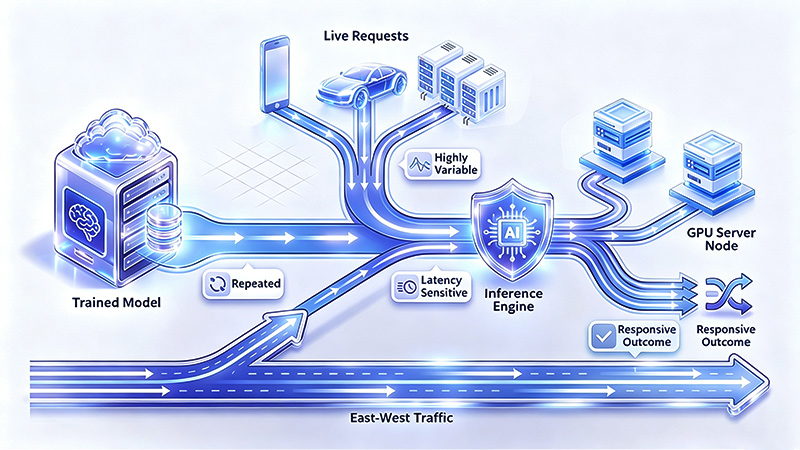
En pocas palabras, la inferencia de IA consiste en desplegar un modelo entrenado en situaciones reales— para recibir y procesar solicitudes de inmediato y ofrecer resultados en tiempo real o casi real. En esta etapa, el objetivo ya no es hacer que el modelo sea más inteligente, sino proporcionar a los usuarios o a las aplicaciones de capas superiores servicios de respuesta rápidos, estables y fácilmente escalables.
En comparación con la fase de entrenamiento, la inferencia gestiona un tráfico de red mucho más dinámico y propenso a ráfagas. El tráfico puede mantenerse estable durante un segundo y, a continuación, aumentar drásticamente, lo que provoca una gran presión de concurrencia y una sensibilidad extrema a la latencia. En este contexto, los estándares para medir el rendimiento de la red han cambiado: en lugar de buscar simplemente un rendimiento alto y constante, la velocidad de respuesta del sistema, la estabilidad de la calidad del servicio y la capacidad para gestionar diversas ráfagas de tráfico en un entorno distribuido centro de datos se han convertido en indicadores más críticos.
Entrenamiento de IA frente a inferencia de IA: ¿Cuáles son las diferencias en los requisitos de red?
Antes de analizar el diseño específico de la arquitectura de red, comparemos el entrenamiento de IA y la inferencia de IA desde varias dimensiones fundamentales. Aunque ambos se encuentran bajo el mismo paraguas de infraestructura de IA, sus objetivos de rendimiento, características de tráfico y prioridades operativas son completamente diferentes. Comprender estas diferencias explica por qué es poco probable que una única estrategia de programación de red gestione eficazmente ambos aspectos simultáneamente.
¿Por qué distintas cargas de trabajo requieren diferentes prioridades de programación?
Entender la diferencia entre el entrenamiento y la inferencia de IA no consiste solo en etiquetarlos. La contradicción más importante es que estas dos tareas llevan a la red en direcciones de optimización completamente distintas.
Veamos primero el entrenamiento de IA. La red debe poder gestionar la comunicación de alto volumen a largo plazo entre los recursos de computación. Si la programación del tráfico es deficiente, la consecuencia más directa es que la capacidad de cómputo de la GPU no se aprovecha plenamente, los ciclos de entrenamiento se prolongan y se desperdicia la infraestructura que tanto costó conseguir. Por lo tanto, los requisitos esenciales de la red de entrenamiento están muy claros—: se busca un alto rendimiento, equidad en la programación de grandes volúmenes y una eficiencia de transmisión constantemente estable.
Pero con la inferencia de IA, la situación cambia mucho. Aquí, el tráfico se conecta directamente con los usuarios o las aplicaciones, y la latencia y las fluctuaciones se convierten en los mayores puntos problemáticos. No se puede aplicar simplemente la misma lógica de programación utilizada para el entrenamiento a gran escala a la inferencia. Si la red trata todo el tráfico por igual, los tiempos de respuesta serán impredecibles cuando haya mucho tráfico o picos repentinos.
Por eso la diferencia entre entrenamiento e inferencia debe elevarse al nivel de diseño de red, en lugar de tratarse como una categoría empresarial. Cuando cambian los objetivos de rendimiento, la lógica de programación subyacente naturalmente también debe cambiar.
¿Cómo puede la programación de red adaptarse con precisión a las demandas de carga de la IA?
Las diferentes características de carga determinan directamente distintas estrategias de programación del tráfico.
En escenarios de entrenamiento de IA, las estrategias de programación deben enfatizar el procesamiento de flujos predecible, el equilibrio de carga eficiente y una utilización de red extremadamente alta. En resumen, se trata de mover continuamente cantidades masivas de datos entre nodos de computación distribuida sin causar congestión. Este tipo de tráfico no es sensible a la microlatencia de una sola solicitud, pero es extremadamente exigente con la eficiencia general de la comunicación durante largos períodos.
La inferencia de IA es un asunto completamente distinto. Su programación del tráfico debe ser flexible y receptiva. La red debe gestionar rápidamente un gran volumen de tráfico y mantenerse estable incluso cuando hay muchas solicitudes. Esto implica no solo una transmisión rápida, sino también minimizar la latencia y la variabilidad del rendimiento.
En última instancia, las diferencias en la lógica de programación entre entrenamiento e inferencia pueden resumirse en dos direcciones básicas:
Entrenamiento de IA: El objetivo es maximizar el rendimiento de la red mediante flujos de datos estables y una transmisión eficiente.
Inferencia de IA: El enfoque se centra en minimizar la latencia de transmisión mediante una respuesta rápida y la adaptación a aumentos repentinos del tráfico.
Para los arquitectos que diseñan infraestructuras de IA, aclarar este límite es una tarea esencial y fundamental que no se puede eludir.
¿Qué se debe priorizar en el diseño de la infraestructura de IA?
Después de aclarar las diferencias entre el entrenamiento y la inferencia, el siguiente paso es traducir estas características en prioridades específicas de diseño arquitectónico. En resumen, el enfoque ya no está en reiterar las diferencias entre ambos, sino en cómo debe implementarse la arquitectura de red en implementaciones prácticas.
Varias consideraciones clave incluyen:
Alineándose estrechamente con las características del negocio: El diseño de la red debe identificar primero el tipo de carga dominante; evita intentar aplicar una sola arquitectura a todo Negocio de IA.
Coincidencia de programación precisa: Las estrategias de programación del tráfico deben ajustarse a los patrones de comportamiento de la carga para garantizar que las estrategias de red sirvan realmente a los objetivos de rendimiento de las aplicaciones.
Coordinación general de recursos: Al planificar la red, la potencia de cómputo, el tráfico y el comportamiento de transmisión deben considerarse de forma integral dentro de la infraestructura general de IA, examinando cómo interactúan entre sí.
Mantener la flexibilidad operativa: Con la creciente prevalencia de la combinación de entrenamiento e inferencia, el sistema de red debe poder ajustar las estrategias y el rendimiento de forma flexible en entornos de carga mixta.
Para las topologías de red orientadas principalmente al entrenamiento, el diseño de red sin pérdidas RoCE ofrece una referencia muy práctica para la transmisión consciente de la congestión.
Conclusión
Considerar el entrenamiento y la inferencia de IA como dos cargas de trabajo de red distintas es un requisito previo crucial para una planificación arquitectónica eficaz. Las diferencias van mucho más allá de la etapa del modelo en su ciclo de vida; afectan directamente a las prioridades de rendimiento, las características del tráfico y los requisitos específicos de programación.
Al final del día, las conversaciones sobre entrenamiento e inferencia nos recuerdan que el diseño de la red debe adaptarse al mundo empresarial. El entrenamiento depende del rendimiento, y la inferencia es muy sensible a la latencia. Por lo tanto, las estrategias de programación del tráfico deben personalizarse para abordar estas necesidades específicas. Si eres una empresa que busca construir una infraestructura de IA escalable, esto es fundamental para tomar decisiones de red precisas y eficaces.


compartir
