


Desbloqueando 1.6T XDR: la nueva piedra angular de la supercomputación de IA de próxima generación
Autor Moore
Fecha 08/28/2026

A medida que el entrenamiento de IA a gran escala y los modelos con billones de parámetros se convierten en la norma, los cuellos de botella de rendimiento en la infraestructura de IA se están desplazando—de la potencia informática pura a la interconectividad de red. Aunque las GPU evolucionan a un ritmo rápido, el enorme tráfico este-oeste generado por el entrenamiento distribuido se expande aún más rápido. Como resultado, el ancho de banda, la latencia y la escalabilidad de la red se han convertido en los factores clave que determinan la utilización informática general de todo el clúster.
La tecnología de red ha evolucionado de HDR 200G a NDR 400G y 800G, y hoy los contornos de la evolución de próxima generación ya están bastante claros: una arquitectura de interconexión de 1.6T basada en tecnología de señal de canal único de 200G está cobrando protagonismo. Al combinar fotónica de silicio, DSP avanzados y tecnología de interconexión óptica de alta densidad, InfiniBand XDR de 1.6T está destinada a desempeñar un papel central en el soporte de futuros clústeres de supercomputación de IA.
Los clústeres de IA impulsan la evolución de las redes de 800G NDR a 1.6T XDR
Desafíos de red a los que se enfrentan los clústeres de IA a hiperescala
El entrenamiento de IA distribuida actual’s a menudo requiere que miles o incluso decenas de miles de GPU trabajen en conjunto. La sincronización de parámetros a escala masiva, la agregación de gradientes y la comunicación frecuente entre clústeres generan una enorme cantidad de tráfico de red este-oeste dentro de los centros de datos.
A medida que los tamaños de los clústeres continúan expandiéndose, las redes HDR y NDR existentes están empezando a mostrar cuellos de botella, principalmente en las siguientes áreas:
Limitaciones de ancho de banda: Ante las exigencias de comunicación de alta velocidad de las grandes matrices de GPU, los enlaces de 400G ya tienen dificultades para mantener el ritmo, lo que puede provocar que los recursos de cómputo permanezcan inactivos y reducir la utilización general.
Limitaciones de la distancia de transmisión: las soluciones ópticas SR multimodo tradicionales tienen distancias de cobertura relativamente cortas, lo que limita directamente la flexibilidad de los centros de datos de hiperescala en la distribución de los racks y la planificación del espacio.
Los desafíos duales del consumo de energía y la integridad de la señal: aumentar la velocidad de la señal eléctrica para incrementar el rendimiento provoca un fuerte aumento del consumo de energía y ejerce una presión significativa sobre la gestión térmica, además de plantear graves desafíos para el control de la tasa de error de bits (BER).
Las redes InfiniBand han mejorado y aumentado su velocidad durante los últimos 20 años para hacer frente a este tipo de problemas. Con cada transición generacional, han logrado grandes avances en el rendimiento, al tiempo que han incorporado continuamente tecnologías SerDes más rápidas y arquitecturas de interconexión subyacentes de mayor rendimiento.
Parámetros de referencia de tecnología central estándar de la industria XDR 1.6T
El núcleo de este salto generacional reside en la actualización integral de las señales eléctricas de SerDes de 100G a 200G. Al duplicar el ancho de banda por canal—combinado con tecnología DSP avanzada y una arquitectura de empaquetado mejorada—la plataforma XDR de nueva generación puede elevar significativamente el límite máximo de rendimiento general de la red sin aumentar significativamente la complejidad del sistema.
Tecnologías subyacentes clave compatibles con 1.6T XDR
Aumentar el ancho de banda no es suficiente. Para Interconexiones de 1.6T para funcionar realmente, necesitan evolucionar juntos en muchas áreas, como el empaquetado óptico, el procesamiento de señales DSP, el diseño de gestión térmica y los chips de conmutación de bajo nivel, por mencionar algunas.
Análisis detallado de la arquitectura de hardware de pila completa: XDR de 1.6T frente a NDR de 800G
Para construir una red de IA de alto rendimiento, simplemente actualizar los chips de switch está lejos de ser suficiente. Toda la infraestructura de interconexión debe depender del trabajo coordinado de módulos ópticos, cables de cobre de conexión directa DAC, cables ópticos activos AOC y componentes de interconexión ramificados para cumplir los requisitos estrictos en diferentes distancias de transmisión.
Desde las GPU dentro del rack hasta las interconexiones de switches, y posteriormente hasta los enlaces troncales de largo alcance que conectan diferentes centros de datos, cada componente desempeña un papel indispensable en el soporte de una red altamente escalable.
Matriz de productos de módulos ópticos: de 800G NDR a fotónica de silicio de 1.6T
Para conexiones de media y larga distancia en centros de datos de IA, los módulos ópticos siguen siendo la solución preferida. Dependiendo de la distancia que deba recorrer la señal y del tipo de fibra, la industria suele clasificarlos en tres categorías: soluciones multimodo SR (corto alcance), soluciones monomodo DR (clase centro de datos) y soluciones monomodo FR (largo alcance).
A medida que las tasas de datos se acercan a 1.6T, la tecnología de fotónica de silicio (SiPh) se vuelve cada vez más importante. Integrar funciones ópticas directamente en una plataforma basada en silicio supone un cambio radical para la fotónica de silicio. Tiene muchas ventajas.
Mayor densidad de integración
Menor consumo de energía
Mejor escalabilidad para la producción en masa
Mayor flexibilidad para la gestión térmica
Gracias a estas características, la tecnología de fotónica de silicio se ha convertido en una de las principales vías para el futuro despliegue a gran escala de redes 1.6T.
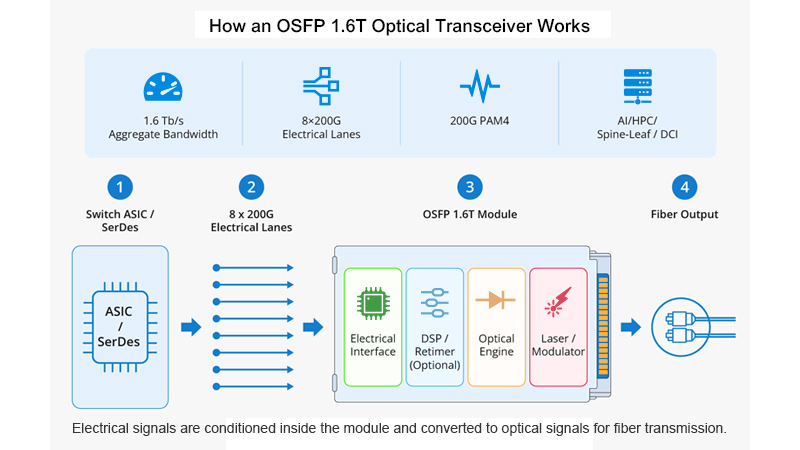
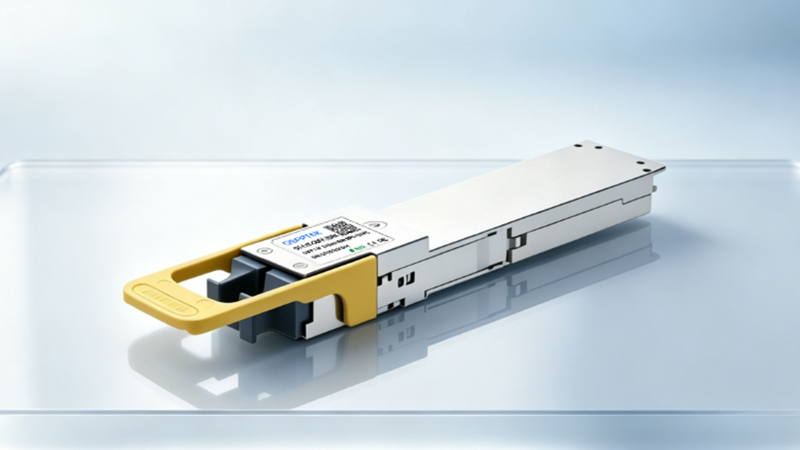
1.6T XDR OSFP DR8 (solución de fotónica de silicio monomodo de 1310 nm)
La longitud de onda operativa es de 1310 nm y utiliza transmisión por fibra monomodo.
La distancia de transmisión típica es de hasta 500 metros.
Cuenta con un diseño de interfaz MPO doble
Arquitectura paralela de 8 canales, con una velocidad de datos de aproximadamente 200G por canal
Aplicaciones típicas: interconexiones troncales entre switches de IA de próxima generación y el despliegue de redes fabric para clústeres de IA a hiperescala.
Serie OSFP NDR 800G
SR8 (850 nm multimodo): Utiliza fibra OM3 y OM4 para realizar conexiones de alta velocidad y corta distancia dentro de los centros de datos.
FR8 (1310 nm monomodo): Puede transmitir a largas distancias, incluso varios kilómetros, por lo que permite realizar conexiones de larga distancia entre edificios y campus.
400G NDR OSFP / QSFP56 Serie
Ofrece arquitecturas probadas como SR4, DR4 y FR4
Permite una evolución y transición fluidas desde redes HDR
Ampliamente desplegado en el lado de acceso del servidor y en redes de capa de acceso.
Matrices de cables de alta velocidad: soluciones de interconexión DAC y AOC
Estos cables se utilizan principalmente para conectar servidores GPU y conmutadores en el mismo rack. Algunos de los tipos más comunes incluyen cables de cobre pasivos (DAC), cables ópticos activos (AOC) y cables divisores (de 1 a 2 o de 1 a 4). Estos cables son populares para conexiones de corta distancia en clústeres de IA porque son asequibles y permiten un cableado de alta densidad.
Cables de cobre de conexión directa DAC pasivos (interfaces OSFP / QSFP56): Estos cables no contienen chips de procesamiento de señales en ninguno de sus extremos y dependen completamente del medio de cobre para la transmisión de señales eléctricas puras, lo que ofrece las ventajas de un consumo de energía ultrabajo y un bajo costo. Las longitudes habituales son principalmente de 1 metro y 3 metros, y están diseñados específicamente para interconexiones internas de bastidores de entre 1 y 3 metros. Las formas de producto incluyen cables estándar de conexión directa, divisores de tipo Y de 1 a 2 y divisores de 1 a 4, que permiten una expansión rentable y flexible de nodos con múltiples GPU al dividir el ancho de banda de un solo puerto.
Cables AOC activos: estos cables integran chips de conversión optoelectrónica en ambos extremos y utilizan fibra óptica para la transmisión en la parte central, superando por completo las limitaciones físicas de distancia de transmisión de los cables de cobre. Entre ellos, el AOC HDR de 200G admite distancias de transmisión de hasta 100 metros, mientras que el AOC NDR de 400G puede cubrir distancias de varias decenas de metros; se utilizan principalmente para interconexiones de alta velocidad entre racks de armarios adyacentes.
Cables breakout: admiten especificaciones de conversión, como OSFP a 2×QSFP56 o OSFP a 4×OSFP, lo que permite dividir un único puerto de 800G en múltiples enlaces descendentes de 200G/400G. Son perfectos para redes flexibles en diversos clústeres de IA y pueden reducir considerablemente los puertos de switch inactivos y desaprovechados.
A lo largo de tres generaciones: la evolución del hardware de red
De HDR a NDR, y ahora a XDR, el salto tecnológico implicado va mucho más allá de simplemente duplicar las cifras de ancho de banda. Con cada generación de evolución, la modulación de señal subyacente, la arquitectura DSP, los diseños de encapsulado óptico y el consumo energético general han experimentado una revisión exhaustiva.
Las diferencias clave entre estas tres generaciones de arquitecturas de hardware se reflejan principalmente en estas métricas fundamentales.
El valor práctico de las redes XDR 1.6T en clústeres de supercomputación de IA
Aumenta significativamente la utilización de la capacidad de cómputo de la GPU
Gracias a la arquitectura de latencia ultrabaja que combina RDMA 1.6T e InfiniBand, la latencia de comunicación entre GPU se ha reducido al rango de microsegundos. En el entrenamiento distribuido de modelos grandes, la utilización efectiva de la potencia de cómputo de los clústeres de GPU puede pasar directamente de aproximadamente el 40% al 75%–80%, acortando sustancialmente el ciclo de entrenamiento para modelos con billones de parámetros. Si los clústeres NDR 800G existentes se actualizan y se reemplazan por una red troncal XDR, se espera que la eficiencia general de entrenamiento de todo el clúster aumente en más del 40%.
Optimización del cableado y de los costes de infraestructura del centro de datos
Reducción del número total de puertos de los switches: Con el doble de ancho de banda por puerto, el número de puertos necesarios en un switch se reduce en un 50 % al tiempo que se admite la misma capacidad de computación, reduciendo así significativamente el espacio en rack, las cargas de distribución eléctrica y los costes de refrigeración.
Distancia de transmisión ampliada: los módulos de la serie DR/FR monomodo de 1310nm admiten distancias de transmisión de entre 500 metros y 2 kilómetros. Esto es mejor que las limitaciones de distancia impuestas por la fibra multimodo de 850nm en las disposiciones físicas de los centros de datos. Esto facilita la división de los racks y la incorporación de más capacidad en los centros de computación inteligente.
Eficiencia energética superior de extremo a extremo: la integración de la fotónica de silicio con una solución DSP de 3 nm de nueva generación reduce el consumo de energía por Gbps de ancho de banda en aproximadamente un 25 % en comparación con los componentes discretos convencionales. Esto reduce considerablemente los costos de electricidad de los clústeres de supercomputación que utilizan 10 000 tarjetas y funcionan con una carga elevada durante todo el año.
Compatible con los activos de red existentes
El protocolo XDR de 1.6T funciona con NDR de 800G y HDR de 200G. No hace falta reconstruir por completo los clústeres de 200G/400G. Basta con sustituir los conmutadores principales y los módulos ópticos troncales para pasar gradualmente a 1.6T. Esto reducirá considerablemente los costes iniciales de actualización.
Recomendaciones de selección para escenarios comunes
Los distintos escenarios empresariales tienen diferentes requisitos de interconexión. Al elegir hardware, normalmente se tienen en cuenta aspectos como la distancia que debe recorrer la señal, la cantidad de cableado necesaria, cuánto se desea gastar y si será necesario ampliar el sistema en el futuro.
En función de las necesidades reales de los entornos empresariales convencionales, las soluciones de hardware de red recomendadas para diferentes escenarios se resumen de la siguiente manera:
Conclusión
Al observar las tendencias tecnológicas generales de la industria, la adopción de la fotónica de silicio continúa acelerándose. A medida que las velocidades de red superan el umbral de 800G, el valor de la fotónica de silicio para reducir el consumo de energía y aumentar la integración se vuelve irremplazable; al mismo tiempo, las redes de 1.6T están pasando de una planificación orientada al futuro hacia una implementación comercial sustancial y se convertirán en el pilar principal del entrenamiento de IA de gran ancho de banda en los próximos años. En cuanto a las soluciones a más largo plazo, como la óptica coempaquetada (CPO), el entusiasmo de R&D sigue siendo elevado. Tanto ahora como en el futuro previsible, los módulos ópticos enchufables maduros serán la corriente absolutamente dominante en el sector de la implementación.
Esto también significa que 1.6T representa el paso clave más claro y pragmático en la actual actualización de la infraestructura de IA. Sin embargo, para que la arquitectura de 1.6T funcione realmente, actualizar únicamente el hardware de los switches está lejos de ser suficiente; requiere los esfuerzos coordinados de todo un ecosistema de interconexión que abarque módulos ópticos, cables de alta velocidad y arquitectura de red.
Aprovechando una cartera completa de productos que cubre 400G, 800G y el emergente 1.6T—incluidos módulos transceptores basados en fotónica de silicio, conjuntos de cables DAC/AOC de alta densidad y soluciones de red enfocadas en IA— QSFPTEK se compromete a ayudar a los usuarios a construir una infraestructura informática altamente escalable y de alto rendimiento, garantizando una transición más estable y fluida desde la arquitectura NDR existente hacia la Fabric de IA 1.6T de próxima generación.


compartir
