


Evolución de la arquitectura de computación de IA: Scale-Up frente a Scale-Out y la elección de módulos ópticos
Autor Moore
Fecha 04/02/2026

A medida que los modelos a gran escala alcanzan billones de parámetros y el tamaño de los clústeres de IA se acerca a cientos de miles de GPU, la infraestructura informática subyacente está experimentando un cambio arquitectónico significativo. Los dos modelos de red principales para la computación de IA—Scale-Up y Scale-Out—avanzan por diferentes caminos técnicos, pero en la práctica, convergen gradualmente en puntos clave.
Este cambio es esencialmente el resultado de repetidas compensaciones entre "baja latencia y alta escalabilidad" y "alta fiabilidad y control de costes". Al mismo tiempo, la evolución continua de las tecnologías de módulos ópticos (como LPO, NPO y CPO) está moldeando cada vez más el diseño de sistemas.
Scale-Up vs. Scale-Out: diferenciación y compensaciones entre dos enfoques
En el diseño de clústeres de computación de IA, Scale-Up y Scale-Out tienen objetivos diferentes desde el principio, y sus criterios de evaluación no están alineados en la misma dimensión. Pueden entenderse como dos enfoques divergentes.
Escalamiento vertical: arquitectura estrechamente acoplada que enfatiza la baja latencia y la consistencia sólida
El escalado vertical se acerca más a ampliar la potencia de cómputo de un único nodo; esencialmente, se trata de una "integración horizontal" dentro de la arquitectura de GPU existente. Al construir unidades de cómputo altamente acopladas, la memoria local de múltiples GPU se abstrae en un espacio lógico unificado, lo que permite que el núcleo de cómputo experimente una HBM casi local al acceder a memoria remota. Este enfoque de semántica de memoria cercana tiene como objetivo no solo ampliar la escala, sino también minimizar la distancia entre el cómputo y los datos, reduciendo la latencia por debajo de los microsegundos mientras se mantiene una alta coherencia y estabilidad.
Scale-Out: modelo de computación distribuida orientado a la escalabilidad
En cambio, Scale-Out se parece más a ensamblar potencia de cómputo dispersa organizando una gran cantidad de nodos en un conjunto cohesionado a través de una red. Las implementaciones típicas se basan en una arquitectura Clos de dos o tres capas, que conecta decenas de miles de GPU, o incluso más, al mismo clúster de entrenamiento para admitir paralelismo de datos, paralelismo segmentado y otros modos de entrenamiento. Este enfoque se centra en la escalabilidad y el control de costes, garantizando que el sistema esté siempre disponible y pueda crecer para satisfacer sus necesidades mientras trabaja con su hardware y software actuales.
En general, Scale-Up consiste en mejorar las "capacidades individuales" para lograr el máximo rendimiento y baja latencia. Por otro lado, Scale-Out se centra en la "eficiencia de escala", lo que permite que los clústeres a gran escala funcionen sin problemas. El primero se enfoca en las unidades centrales de la informática de alto rendimiento, mientras que el segundo forma la red fundamental para el entrenamiento y la inferencia a gran escala. Estos dos modos suelen coexistir y complementarse en la infraestructura de IA del mundo real.
Evolución actual: cambios en la arquitectura Scale-Up y tendencias de simplificación Scale-Out
En los últimos años, Scale-Up y Scale-Out han evolucionado rápidamente, y los fabricantes líderes han descubierto cómo implementarlos en la práctica. El objetivo es aumentar el rendimiento simplificando al mismo tiempo la complejidad.
Scale-Up: De sistemas basados en chasis a coexistencia multiformato, la interconexión 224G se convierte en un nodo clave
Las primeras soluciones para empresas en crecimiento se centraban principalmente en "SuperNodes de chasis", que reunían recursos informáticos en un único sistema y los conectaban mediante enlaces de alta velocidad. Estas soluciones hacían hincapié en la estabilidad y la coherencia, empleando normalmente una combinación de "backplane de cable + conmutación L1/L2": las interconexiones internas del chasis dependían principalmente de conexiones eléctricas para garantizar una alta densidad de ancho de banda; la expansión entre chasis dependía de interconexiones ópticas.
Las interconexiones ópticas 224G se están convirtiendo gradualmente en la opción principal para escenarios de escalado vertical. Desde la perspectiva de un modelo de costes, el precio de módulos ópticos 1.6T probablemente seguirá siendo aproximadamente de 1,2 a 1,4 veces el de 800G durante los próximos tres a cinco años. Esta diferencia es bastante fácil de manejar, ya sea que se base en LPO o en una arquitectura DSP tradicional. Pero usar tecnología 112G a menudo significa usar más fibra para el mismo ancho de banda, lo que termina costando más. Cuando se consideran factores como el ancho de banda, el consumo de energía y la complejidad del cableado, la solución 224G es mejor a largo plazo.
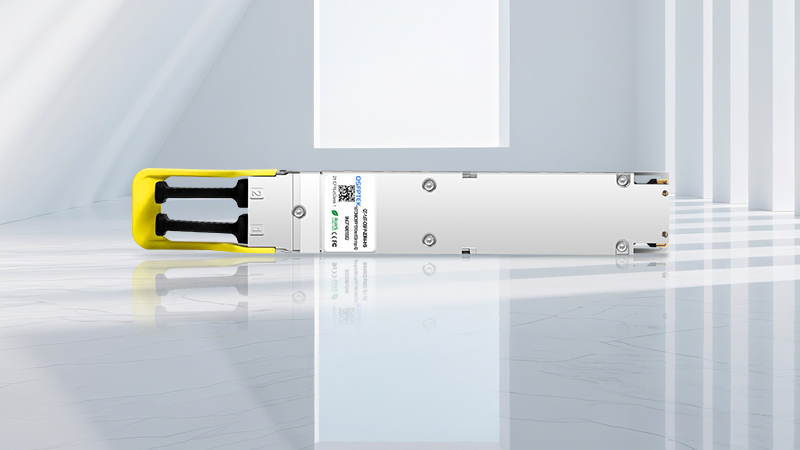
Módulo óptico QSFPTEK 1.6T
La industria ha estado siguiendo esta tendencia y ha comenzado a desarrollar productos relacionados, como los módulos de la serie OSFP de QSFPTEK que admiten velocidades de 1.6T (por ejemplo, especificaciones 2×DR4 y 2×FR4). Estos están orientados principalmente a satisfacer los requisitos de alto ancho de banda y baja latencia de las futuras arquitecturas de supernodos. Estos productos también están preparando los centros de datos para el siguiente paso en su crecimiento.
Escalamiento horizontal: de tres capas a dos capas, la estructura de red se aplana gradualmente
Un cambio significativo en las arquitecturas de escalado horizontal es el énfasis cada vez mayor en la simplificación del diseño general. La red Clos de tres capas, antes habitual, está siendo reemplazada gradualmente por una arquitectura Clos de dos capas. Al reducir el número de capas intermedias, la ruta de red se vuelve más directa, lo que reduce la complejidad del sistema. Con este diseño, incluso los clústeres de entrenamiento destinados a cientos de miles de GPU pueden mantener una alta escalabilidad mientras mantienen los costos de red bajo control.
Este cambio se debe en gran medida a las mejoras en las capacidades de los chips de conmutación. A medida que los tamaños de los puertos siguen aumentando, por ejemplo, con Radix alcanzando 512 puertos, una red Clos de dos capas puede admitir directamente escalas de nodos superiores a 100.000 y, en algunos modelos de diseño, incluso cubrir alrededor de 130.000 tarjetas aceleradoras, sin necesidad de una capa adicional de conmutación central. Esto significa que los grandes clústeres de IA pueden mantener la densidad de ancho de banda mientras conservan una topología de red más clara durante el escalado.
Redes multiplano: Alivio de la presión del ancho de banda mediante un diseño multiplano
Sobre esta base, algunos fabricantes han comenzado a explorar nuevos métodos de organización de redes. Por ejemplo, la arquitectura Multi-Plane propuesta en investigaciones relacionadas es un enfoque típico. En este esquema, la AI-NIC accede simultáneamente a diferentes planos de red Clos mediante múltiples puertos de alta velocidad; por ejemplo, utiliza cuatro interfaces 200G para conectar cuatro planos de red independientes y, en el lado de envío, distribuye el mismo flujo de datos entre los planos mediante un método round-robin.
En el extremo receptor, un mecanismo de procesamiento de datos que admite escrituras fuera de orden reensambla los datos de diferentes rutas, de modo que un solo enlace no se convierta en un cuello de botella. Este enfoque mejora la utilización del ancho de banda en una sola GPU en escenarios Scale-Out, logrando una tasa de utilización general superior al 95% en algunos modelos de prueba.
Desde la perspectiva de las tendencias, el enfoque de Scale-Out no consiste solo en aumentar la escala, sino en lograr un equilibrio más razonable entre ancho de banda, eficiencia y costo en clústeres de IA de escala ultra grande mediante la optimización estructural y la innovación en el diseño de redes.
Tendencias en la selección de módulos ópticos: LPO/NPO gana popularidad, CPO disminuye gradualmente
Tanto en las arquitecturas Scale-Up como Scale-Out, los módulos ópticos no solo son el medio de conexión, sino que también afectan directamente a la latencia, el consumo de energía y la estabilidad del enlace. Por lo tanto, los diferentes enfoques tecnológicos difieren cada vez más en sus elecciones respecto a los factores de forma de los módulos ópticos. Las diferencias entre LPO, NPO y las soluciones tradicionales habilitadas con DSP son cada vez más claras, mientras que la popularidad de CPO ha disminuido relativamente.
Escalabilidad: Las soluciones de menor latencia prefieren LPO/NPO
En escenarios en los que el sistema se escala, el objetivo es reducir la latencia y el consumo de energía. Esto hace que las soluciones LPO o NPO sin DSP sean más populares. Estos módulos ópticos simplifican la ruta de procesamiento de señales, lo que reduce en gran medida la cantidad de energía que consumen. Por ejemplo, un módulo 800G con una solución LPO consume aproximadamente 6W, una mejora significativa con respecto a los productos tradicionales equipados con DSP, que suelen consumir alrededor de 15W.
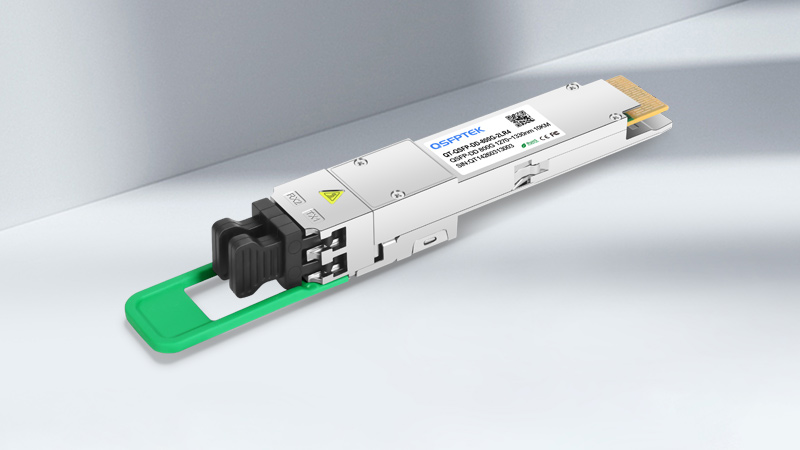
Módulo óptico QSFPTEK 800G
Al mismo tiempo, la menor intervención del DSP en el procesamiento de datos también reduce la latencia del enlace. La latencia unidireccional puede acortarse en decenas de nanosegundos, con una reducción aún más pronunciada en la latencia de ida y vuelta. Estas características los hacen más adecuados para los requisitos de escalado horizontal de "corto alcance, alta consistencia", y algunos productos LPO optimizados para centros de datos de IA están diseñados en torno a estas métricas.
Scale-Out: la arquitectura DSP sigue siendo la opción principal
Sin embargo, en entornos donde los sistemas se escalan horizontalmente, es una situación completamente diferente. Los módulos ópticos con procesadores de señales digitales (DSP) son mejores para gestionar grandes conexiones de red y largas distancias de transmisión. Por este motivo, siguen siendo la opción preferida.
Por un lado, en términos de control de errores, los DSP pueden admitir mecanismos de corrección de errores directa más complejos, lo que permite que el enlace alcance una tasa de errores menor después de la corrección, haciéndolos adecuados para escenarios de transmisión de larga distancia. Los módulos LPO/NPO, por otro lado, tienen capacidades relativamente limitadas en este aspecto, y a menudo no cumplen los requisitos de estabilidad para enlaces entre centros de datos o de nivel de 10 km.
Por otro lado, los clústeres a gran escala suelen implicar el despliegue mixto de equipos de múltiples proveedores, lo que impone mayores exigencias a la interoperabilidad. Los módulos ópticos DSP basados en protocolos estándar (como IEEE 802.3) son más maduros en cuanto a compatibilidad entre proveedores, mientras que los estándares LPO/NPO siguen evolucionando y el ecosistema aún no está completamente unificado.
En general, las dos vías técnicas han quedado claras: Scale-Up suele utilizar LPO/NPO para lograr menor latencia y consumo de energía. Scale-Out sigue dependiendo de la arquitectura DSP para garantizar la transmisión a larga distancia y la compatibilidad del sistema. A pesar de sus diferentes métodos de implementación, ambas comparten el mismo objetivo en la evolución del ancho de banda—avanzar hacia velocidades de 224G por canal.
Los verdaderos desafíos de la integración y la implementación: las oportunidades y las limitaciones coexisten
Cuando la alta fiabilidad de scale-up y la escalabilidad a gran escala de scale-out comienzan a converger, la dirección de las "redes convergentes" parece natural. Sin embargo, todavía hay varios obstáculos inevitables entre la experimentación y el despliegue a gran escala.
Diferencias arquitectónicas: dificultad para unificar la semántica de memoria y la semántica de mensajes
Los dos sistemas operan en niveles diferentes. Scale-Up es como la "semántica de memoria", que es una forma en que las GPU acceden a recursos remotos. Esto hace que todos los dispositivos puedan comunicarse entre sí rápidamente. Scale-Out, por otro lado, se basa en la "semántica de mensajes", usando mecanismos como RDMA para enviar y recibir datos. Es básicamente un modelo de comunicación explícito. Las principales diferencias en la forma en que diseñan y construyen sus sistemas significan que integrarlos es más complicado que simplemente asegurarse de que todos puedan comunicarse entre sí.
Rutas de fiabilidad inconsistentes: Cómo introducir enlaces estables
Para garantizar que un diseño sea fiable, Scale-Up suele utilizar una "placa posterior de cables + estructura de conmutación" para reducir el riesgo de fallos de enlace y mantener la ruta crítica dentro de un rango de alta estabilidad. En cambio, los sistemas Scale-Out suelen utilizar módulos ópticos para la interconexión. Para lograr la convergencia, parte del tráfico Scale-Out debe desviarse a los enlaces altamente fiables de Scale-Up, lo que requiere reconstruir la topología de red existente. En clústeres con decenas de miles o incluso cientos de miles de tarjetas, tales ajustes son proyectos de ingeniería inherentemente complejos.
Colaboración entre proveedores: los estándares y los ecosistemas siguen fragmentados
Las redes convergentes no son solo una cuestión arquitectónica; también implican colaboración de la industria. Se necesita una alineación más estrecha de los estándares entre chips de conmutación, GPUs y módulos ópticos. Por ejemplo, las soluciones relacionadas con LPO aún dependen del perfeccionamiento de especificaciones unificadas para la interoperabilidad entre proveedores. Al mismo tiempo, las estructuras de conmutación basadas en memoria deben adaptarse a las implementaciones de interfaces de diferentes proveedores de GPU. Actualmente, los proveedores líderes se centran principalmente en sus propios ecosistemas, y los protocolos y las rutas de implementación no están completamente unificados, lo que ha ralentizado en cierta medida el ritmo de la convergencia.
En torno a estos problemas, están surgiendo algunas preguntas clave: ¿Tiene LPO la oportunidad de lograr un avance en interoperabilidad y convertirse en una solución de interconexión óptica más universal? ¿Pueden integrarse la semántica de memoria y la semántica de mensajes a nivel de software para permitir que el sistema logre tanto baja latencia como alta escalabilidad?
Lo cierto es que la competencia por la infraestructura informática ha entrado en una etapa más profunda. Cada ajuste en la tecnología de módulos ópticos, la estructura de red y los métodos de colaboración de la industria afectará al resultado. En lugar de elegir simplemente entre dos caminos, una dirección más realista puede ser permitir que diferentes sistemas funcionen de forma colaborativa dentro de la misma infraestructura. En consonancia con esta tendencia, también se han propuesto ideas similares a "Scale-Across" como una forma de transición que conecta los dos modos.


compartir
