


Hacia la arquitectura Rubin: el salto de las redes de centros de datos de IA de 800G a 1.6T
Autor Leslie
Fecha 04/02/2026

La plataforma GPU Rubin de próxima generación de NVIDIA está impulsando un cambio fundamental en el diseño de la infraestructura de IA. A medida que las cargas de trabajo de IA pasan de miles de millones de parámetros a billones, los desafíos van mucho más allá del rendimiento computacional. Lo que realmente determina la eficiencia del sistema suele ser la capacidad de mover datos de forma eficiente entre miles de GPU. En este contexto, la red ya no es solo una capa de soporte, sino un componente central que determina el rendimiento de la IA. Estos sistemas están diseñados inherentemente para un paralelismo masivo, con una comunicación continua e intensiva entre nodos, lo que está remodelando la lógica de diseño de los centros de datos.
Qué es la arquitectura Rubin
La arquitectura Rubin de NVIDIA es una actualización de la arquitectura Blackwell. Es una plataforma de computación colaborativa de pila completa diseñada específicamente para el entrenamiento de modelos de IA a ultra gran escala y la inferencia de baja latencia. Compuesta por múltiples chips nuevos, ofrece mayor rendimiento y eficiencia energética, admite el funcionamiento eficiente de tareas de IA a gran escala y sirve como infraestructura central que impulsa el desarrollo a gran escala de la IA.
A diferencia de las GPU anteriores, que se centraban principalmente en mejorar el rendimiento de un solo chip, Rubin fue diseñado desde el principio para sistemas de IA distribuida a gran escala. Su objetivo final es lograr un entrenamiento eficiente en clústeres que contengan decenas de miles de GPU.
En este entorno, las GPU necesitan intercambiar continuamente gradientes, parámetros y datos intermedios. La carga de comunicación es extremadamente pesada, y la eficiencia de la transmisión de datos afecta directamente a la velocidad de entrenamiento. Aunque tecnologías como InfiniBand y RDMA pueden reducir la latencia y aumentar el rendimiento, siguen dependiendo de un ancho de banda suficiente en la capa física.
El papel de 800G en la infraestructura de IA
La interconexión 800G se ha convertido gradualmente en el estándar de facto para la infraestructura de IA de alto rendimiento. En comparación con las soluciones 400G, 800G alcanza el doble de ancho de banda, manteniendo al mismo tiempo un equilibrio razonable entre el consumo de energía y la complejidad de implementación en esta etapa.
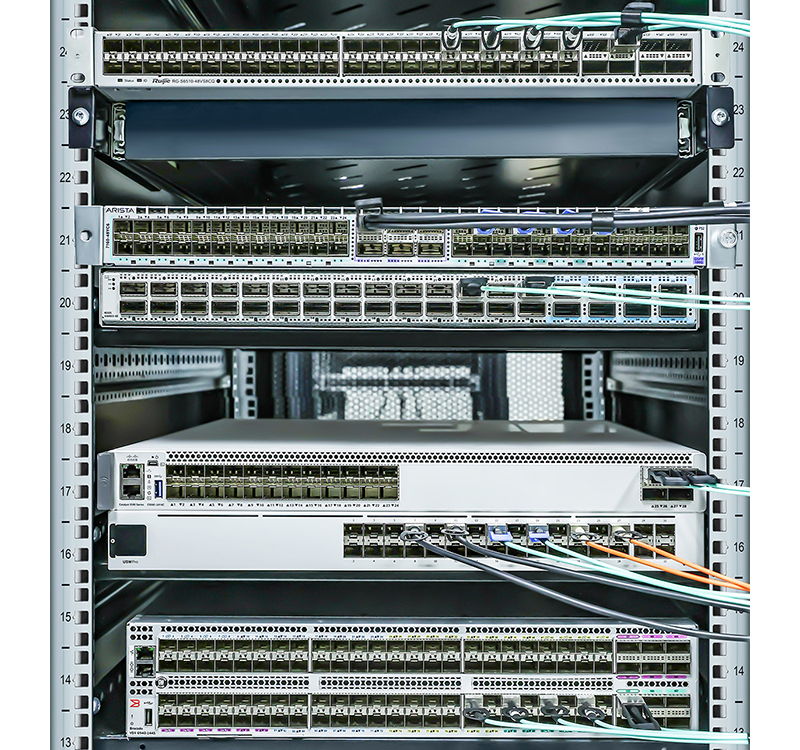
En implementaciones reales, Soluciones 800G presentan una clara división del trabajo basada en escenarios de aplicación:
Los DAC se utilizan para conexiones de distancia ultracorta entre GPU y switches ToR dentro de un rack de servidores. El cableado de cobre introduce casi ningún consumo de energía adicional y tiene la latencia de transmisión más baja, lo que lo convierte en el medio preferido para interconexiones de alta densidad dentro de racks de servidores.
Los AOC son adecuados para conexiones de corta a media distancia entre racks de servidores. Los AOC integran módulos ópticos y cables, simplificando el proceso de despliegue in situ al tiempo que garantizan la integridad de la señal y reducen los requisitos de limpieza y mantenimiento de las interfaces de fibra óptica.
Los módulos ópticos se utilizan en la capa troncal principal de las redes estructuradas, y admiten interconexiones de larga distancia en arquitecturas Spine-Leaf. Los módulos ópticos, junto con los sistemas de cableado de fibra óptica, permiten la expansión de la red entre POD y regiones.
Este enfoque de implementación por capas refleja las necesidades reales de ingeniería de los clústeres de IA a gran escala. Tomando QSFPTEK como ejemplo, su línea de productos 800G cubre toda la gama de DAC, AOC y módulos ópticos. Su valor principal reside en garantizar que los usuarios obtengan un rendimiento de compatibilidad uniforme en una arquitectura de red de tres capas. En entornos de clústeres de IA de alta densidad y alto rendimiento, la interoperabilidad estable en distintos escenarios suele ser más significativa que un único indicador de rendimiento.
Las limitaciones de 800G en la era Rubin
Aunque las soluciones 800G han sido ampliamente probadas en los clústeres de IA actuales, sus limitaciones se vuelven cada vez más evidentes al enfrentarse a la densidad de computación de próxima generación representada por la arquitectura NVIDIA Rubin.
Las principales fuentes de presión son los siguientes tres aspectos:
Densidad de GPU en rápido aumento: El número de GPU por rack está evolucionando desde el estándar actual de 8 a 16 o 32, y la demanda de ancho de banda agregado dentro del rack está saltando del nivel de Tbps a decenas de Tbps, lo que plantea un serio desafío a la relación de convergencia de los puertos de los switches ToR.
Expansión del tamaño del clúster: Los nodos de clúster se están expandiendo de miles a decenas de miles o incluso cientos de miles de nodos, y el patrón de congestión de la red está evolucionando de puntos críticos locales a congestión distribuida globalmente. Simplemente aumentar el número de enlaces conducirá a un aumento superlineal de la complejidad del cableado, el consumo de energía y los costes de mantenimiento;
Evolución de los modos de comunicación: Las nuevas estrategias de paralelismo de modelos, representadas por Expert Parallelism (MoE), aumentan significativamente la frecuencia de sincronización entre GPU en comparación con la arquitectura Transformer tradicional, lo que requiere que el sistema de red cumpla simultáneamente los requisitos combinados de gran ancho de banda y baja latencia.
Desde la perspectiva de la relación de correspondencia entre computación y red, se espera que el rendimiento de computación de una sola tarjeta de la plataforma Rubin sea más del doble que el de la arquitectura Blackwell. Si el ancho de banda de la red permanece sin cambios, la proporción de tiempo inactivo de los recursos de computación esperando datos aumentará significativamente, lo que limitará directamente la utilización efectiva de la potencia de computación de la GPU.
Por qué se necesitan módulos 1.6T
El avance de la interconexión 1.6T está impulsado en gran medida por la demanda rígida de ancho de banda de red de las arquitecturas GPU de próxima generación. Su importancia radica no solo en duplicar las velocidades de los puertos, sino también en proporcionar una vía técnica viable para abordar los cuellos de botella estructurales mencionados anteriormente.
El valor principal de 1.6T se refleja en las siguientes dimensiones:
Mayor densidad de ancho de banda: Un solo puerto proporciona 200GB/s de rendimiento de datos. Por ejemplo, un switch de 48 puertos puede proporcionar casi 10Tbps de ancho de banda agregado, reduciendo el número de puertos y el espacio de rack ocupado aproximadamente a la mitad en comparación con las soluciones 800G;
Topología simplificada: Con el mismo tamaño de clúster, 1.6T admite una topología de red más plana, como simplificar una arquitectura Clos de tres niveles a una arquitectura de dos niveles, reducir el número de dispositivos de la capa Spine y, al mismo tiempo, reducir la acumulación de latencia causada por el reenvío entre capas.
Complejidad operativa reducida: La reducción en el número de enlaces conduce directamente a una disminución simultánea en el número de núcleos de fibra, módulos ópticos y puntos de fallo. En clústeres a gran escala, este efecto puede traducirse en una mejora considerable de la eficiencia operativa.
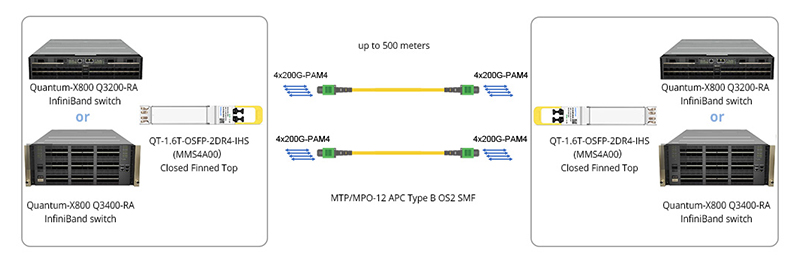
QSFPTEK ya ha comenzado su implementación tecnológica en la línea de productos 1.6T, ofreciendo varios módulos 1.6T para centros de datos de IA. Esto significa que pueden planificar proactivamente la integración de redes de próxima generación en la infraestructura 800G existente, en lugar de enfrentarse a la presión de actualizaciones reactivas durante el despliegue completo de la arquitectura Rubin.
Ruta de actualización real recomendada
La evolución de 800G a 1.6T en entornos reales de centros de datos suele seguir una trayectoria gradual, en lugar de una sustitución completa de una sola vez.
Puede consultar la siguiente ruta de actualización:
Capa de acceso e interconexiones de corto alcance: continúe utilizando las soluciones 800G DAC y AOC. Las ventajas del cableado de cobre y los cables ópticos activos en términos de consumo de energía y costo siguen siendo difíciles de reemplazar a corto plazo para escenarios de corto alcance dentro de los racks y entre ellos;
Capa Spine y backbone principal: Introducir primero módulos ópticos y switches 1.6T para transportar el tráfico agregado entre PODs, reservando un margen de ancho de banda suficiente para que la capa principal satisfaga las necesidades de expansión futuras;
Transición de arquitectura híbrida: Logre el funcionamiento híbrido de equipos 800G y 1.6T mediante agregación de enlaces o mecanismos de negociación de velocidad, completando gradualmente el reemplazo generacional desde la capa de acceso hasta la capa de núcleo, evitando gastos de capital únicos y riesgos de interrupción del servicio.
Para los centros de datos que ya han implementado infraestructura 800G, normalmente se adopta un período de transición fluido de 2-3 años. Durante este período, es necesario prestar atención simultáneamente a la compatibilidad con versiones anteriores de los módulos ópticos, la capacidad reservada del sistema de cableado y las capacidades de coordinación multivelocidad del sistema operativo de red.
Conclusión
El cambio de módulos ópticos 800G a 1.6T es esencial para respaldar la arquitectura Rubin de NVIDIA’s. 1.6T ofrece mayor densidad de ancho de banda, una estructura de red más sencilla y menor latencia para satisfacer las demandas de los centros de datos de próxima generación. Con un enfoque de actualización por fases, los usuarios pueden realizar una transición fluida de su infraestructura mientras aprovechan al máximo las soluciones ópticas 1.6T de QSFPTEK’s para una conectividad de clúster estable y de alto rendimiento.


compartir
