


Choisir des interconnexions 200G : InfiniBand HDR ou Ethernet
Auteur Leslie
Date 11/13/2026

Lors de l’examen des architectures de centres de données modernes et de clusters d’entraînement d’IA, les ingénieurs réseau sont fréquemment confrontés à un choix crucial : choisir entre InfiniBand HDR et Ethernet 200GbE. Un débit commun de 200G ne signifie pas que les deux technologies fonctionnent de la même manière. InfiniBand HDR et Ethernet 200GbE prennent tous deux en charge la connectivité 200G QSFP56 au moyen de quatre voies 50G PAM4. Selon la plateforme et les spécifications des câbles, ces systèmes peuvent utiliser des câbles DAC passifs ou des câbles optiques actifs pour les connexions à courte et moyenne portée. Cependant, la compatibilité physique des connecteurs ne garantit pas automatiquement la compatibilité des protocoles.
Architecture de transport et contrôle de flux
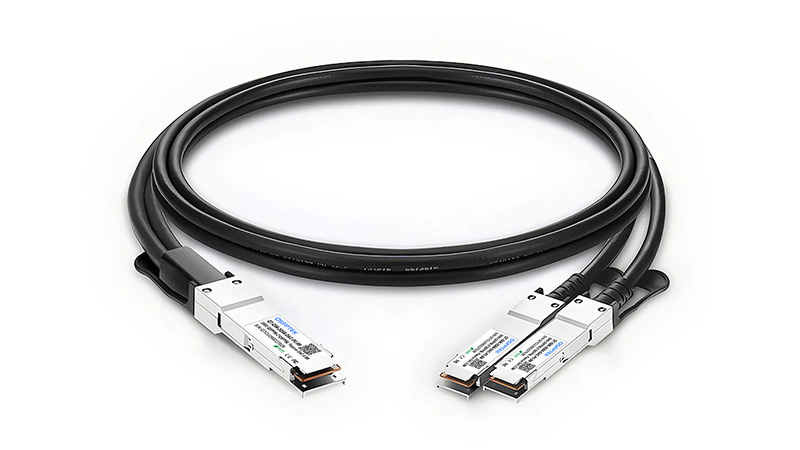
Pour comprendre pourquoi une liaison 200G se comporte différemment selon le protocole qu’elle transporte, nous devons examiner leurs mécanismes de transport et de contrôle de flux. Quel que soit le protocole choisi, la mise en service réussie de toute liaison 200G à haute densité repose sur des supports physiques robustes, comme le déploiement de câbles DAC 200G pour les connexions à courte portée en haut de baie.
Ethernet avec RoCEv2 : Ethernet est fondamentalement une technologie de commutation de paquets à usage général. RoCEv2 achemine le trafic de transport RDMA sur Ethernet au moyen d’une encapsulation UDP/IP. Cela permet aux applications RDMA de fonctionner sur des réseaux IP routés tout en conservant une grande partie du modèle de transport RDMA. Toutefois, cela introduit également des considérations supplémentaires au niveau de la couche réseau, notamment le routage IP, la gestion de la congestion et le comportement de livraison des paquets. Ethernet classique ne fournit pas le même contrôle de flux par crédits au niveau de la liaison qu’InfiniBand. Pour les déploiements RoCEv2 sensibles à la latence, les opérateurs réseau combinent généralement des mécanismes tels que le contrôle de flux fondé sur les priorités et la notification explicite de congestion avec des algorithmes de contrôle de congestion comme DCQCN. Ces fonctionnalités peuvent contribuer à réduire les pertes de paquets en cas de congestion, mais leur efficacité dépend fortement d’une configuration adéquate, de la gestion des tampons et de l’ingénierie du trafic.
InfiniBand HDR : InfiniBand a été spécialement conçu comme une infrastructure commutée native pour le calcul en cluster à faible latence et à haut débit. Il utilise un contrôle de flux par crédits pour réguler le trafic au niveau de la liaison : un émetteur doit disposer de crédits suffisants, indiquant l’espace tampon disponible côté récepteur, avant de transmettre des données. Parallèlement, un Subnet Manager centralisé assure la découverte de l’infrastructure, sa configuration et la gestion des chemins. Cette architecture contribue à prévenir les débordements des tampons de réception causés par la congestion et réduit la dépendance à la configuration PFC propre à Ethernet. Toutefois, elle ne garantit pas l’élimination de toutes les formes d’erreurs de paquets, de congestion ou de retransmissions sur l’ensemble de l’infrastructure.
RDMA et performances des clusters d’IA
L’entraînement moderne de l’IA, en particulier celui des grands modèles de langage, repose largement sur des opérations de communication collective telles que All-Reduce, All-Gather et Reduce-Scatter. Ces opérations permettent aux GPU répartis sur plusieurs serveurs d’échanger des données et de synchroniser les paramètres du modèle ou les gradients pendant l’entraînement. Lors des opérations collectives, les délais de communication de certains nœuds peuvent prolonger le temps nécessaire pour terminer une itération d’entraînement. Lorsque la synchronisation devient un goulot d’étranglement, les nœuds les plus rapides peuvent devoir attendre les participants plus lents, ce qui réduit l’utilisation globale des GPU.
RDMA est au cœur des deux architectures. InfiniBand et RoCEv2 prennent tous deux en charge RDMA, permettant à une carte réseau de transférer directement des données entre des régions mémoire enregistrées sur des systèmes distants avec une intervention minimale du CPU hôte. En réduisant les copies de données et le traitement par le noyau dans le chemin de données, RDMA contribue à réduire la charge du CPU et à améliorer l’efficacité des communications pour les charges de travail à hautes performances.
InfiniBand natif fournit une architecture de transport et d’infrastructure réseau spécialement conçue pour le calcul haute performance. RoCEv2 peut également offrir des performances RDMA élevées sur Ethernet, mais l’obtention de résultats constants à grande échelle nécessite une attention particulière au contrôle de congestion, à la gestion des files d’attente et à la configuration du réseau.
Comparaison entre InfiniBand HDR 200G et RoCEv2 200GbE
Choisir la bonne interconnexion 200G
Le choix entre ces deux technologies nécessite une évaluation approfondie de vos charges de travail applicatives, de votre infrastructure existante, ainsi que de l’expertise opérationnelle et de la maturité technique de votre équipe.
Pour les clusters d’IA et de HPC à grande échelle :
Si votre charge de travail principale consiste à entraîner de grands réseaux neuronaux sur des clusters massifs de GPU, où la latence de synchronisation entre les nœuds influe directement sur le temps d’entraînement, InfiniBand offre une architecture réseau spécialement conçue pour de tels scénarios. Son mécanisme de contrôle de flux fondé sur des crédits régule la transmission des données au niveau de la couche liaison, tandis qu’un gestionnaire de sous-réseau centralisé facilite la gestion unifiée des configurations réseau et des chemins de données. Dans les environnements à grande échelle reposant sur une extension horizontale, la gestion centralisée des sous-réseaux d’InfiniBand et son contrôle de flux fondé sur des crédits au niveau des liaisons contribuent à simplifier l’administration réseau, en réduisant le besoin de configurations PFC complexes et de réglages de congestion typiques d’Ethernet. Toutefois, avant le déploiement, vous devez évaluer la maîtrise de votre équipe en matière de gestion d’un gestionnaire de sous-réseau, examiner votre infrastructure de commutation existante et prendre en compte les besoins futurs d’extension de votre cluster.
Pour les environ de centres de données convergésnements :
Si votre infrastructure doit prendre en charge un large éventail de charges de travail, telles que la virtualisation généraliste, les microservices conteneurisés et le stockage en mode bloc à hautes performances, une solution Ethernet 200GbE utilisant RoCEv2 offre une plus grande flexibilité. Elle s’intègre parfaitement aux technologies existantes de routage et de virtualisation réseau d’entreprise, telles que BGP et EVPN-VXLAN. Cela dit, le déploiement de RoCEv2 nécessite une planification minutieuse de la QoS et de la gestion de la congestion. Vous devez vous assurer que les commutateurs de votre centre de données prennent en charge le marquage ECN et PFC, et vérifier que vos cartes d’interface réseau et l’ensemble de votre infrastructure réseau sont correctement configurés pour les mécanismes de contrôle de la congestion tels que DCQCN. De plus, votre équipe d’exploitation doit établir des normes claires de configuration et de validation, en mettant l’accent sur la hiérarchisation du trafic, les seuils des mémoires tampons et le comportement du réseau en cas de congestion.
 Considérations relatives au câblage DAC et AOC
 Considérations relatives au câblage DAC et AOC
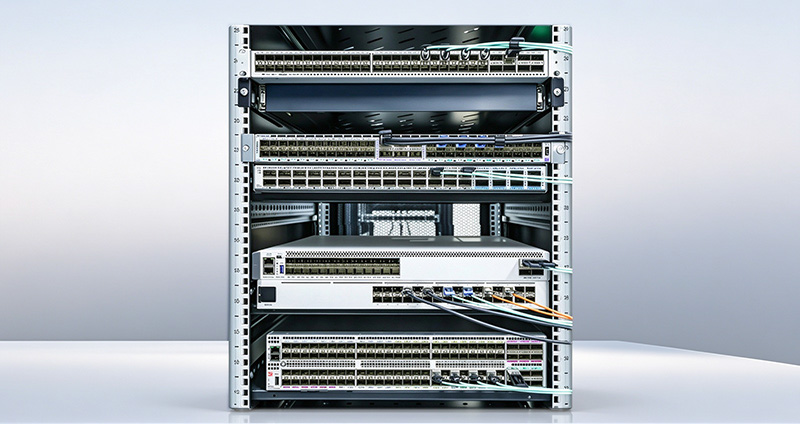
Dans un réseau de centre de données 200G, le choix entre DAC et AOC dépend principalement de la distance de liaison, des exigences d’acheminement des câbles et de la compatibilité des plateformes. La connectivité de la couche physique joue un rôle essentiel dans le maintien de l’intégrité du signal sur les liaisons 200G.
Câbles DAC QSFP56 passifs : Comme les câbles DAC passifs utilisent des connexions électriques directes plutôt que des émetteurs-récepteurs optiques et des liaisons en fibre optique, ils constituent une option simple et économique pour les interconnexions 200G à courte portée. Toutefois, la longueur du câble, la perte d’insertion, l’intégrité du signal et les exigences FEC propres à chaque plateforme doivent toujours être prises en compte lors de la conception des liaisons 200G. Dans les configurations prises en charge, un port 200G QSFP56 peut être divisé en deux liaisons 100G à l’aide d’un câble de dérivation compatible. Cela nécessite que le port source, les interfaces en aval et les équipements réseau prennent en charge le même mode de dérivation et la même affectation des voies.
Câbles optiques actifs (AOC) : Pour les connexions plus longues, lorsque la longueur des câbles en cuivre passifs ou les contraintes d’acheminement deviennent limitantes, les câbles optiques actifs peuvent constituer une solution de remplacement pratique. Pour les déploiements InfiniBand HDR, AOC sont également disponibles dans différentes longueurs et configurations de dérivation, notamment des options de 200G vers deux liaisons 100G (notez que ces options de dérivation dépendent de la prise en charge par les protocoles et les équipements concernés). Ces assemblages peuvent simplifier la connectivité lorsque le câblage en cuivre est inadapté ou que des parcours de câbles plus longs sont nécessaires. Les ingénieurs doivent néanmoins vérifier le protocole pris en charge, la portée et la compatibilité des équipements aux extrémités.
Conclusion
L’adaptation de l’architecture réseau aux exigences des charges de travail ne constitue qu’une partie du processus de conception. Les ingénieurs doivent également vérifier la compatibilité des câbles, les configurations de dérivation, la portée des liaisons et la prise en charge par les équipements aux extrémités. En évaluant à la fois le protocole réseau et l’interconnexion physique, les équipes des centres de données peuvent construire des infrastructures 200G capables d’évoluer de manière fiable pour les charges de travail d’IA, de HPC et d’entreprise.


Partager
