


Des charges de travail massives d’IA arrivent : quels changements l’infrastructure des centres de données connaît-elle ?
Auteur Moore
Date 09/18/2026

À mesure que les charges de travail d'IA s'étendent à travers les serveurs et les racks, les performances finales de l'ensemble du système dépendent de plus en plus du fonctionnement coordonné d'éléments tels que la puissance de calcul, le réseau, le stockage, l'alimentation électrique et le refroidissement. Bien que les paramètres de pointe sur le papier soient importants, ils ne représentent plus entièrement le débit effectif, l'évolutivité ou les coûts d'exploitation globaux d'un cluster.
Cela oblige chacun à élargir sa perspective au niveau de la baie et de l'ensemble du cluster lors de la planification et de l'évaluation de l'infrastructure d'IA. Ce changement de perspective transforme la conception, l'extension et le déploiement des architectures sous-jacentes des centres de données, rendant plus essentiels que jamais la planification globale, la vérification au niveau du système et la préparation au déploiement. Cet article examinera ces changements ainsi que les défis pratiques qu'ils posent pour les infrastructures d'IA à grande échelle.
Transformation de l'infrastructure des centres de données pilotée par l'IA
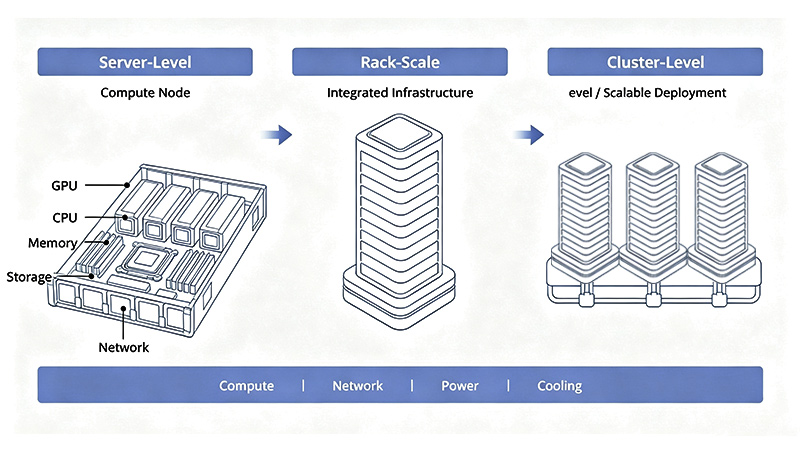
Pour l’entraînement distribué ou l’inférence à grande échelle, les accélérateurs doivent échanger constamment des données. La connectivité réseau, l’accès au stockage, l’alimentation électrique et les capacités de refroidissement sont donc essentiels à la stabilité de l’ensemble du système. C’est pourquoi la planification des infrastructures actuelles ne se limite plus depuis longtemps aux déploiements sur serveur unique et s’étend aux racks haute densité, voire aux clusters comportant plusieurs racks. Si les serveurs restent les nœuds de calcul les plus élémentaires, les racks et les clusters deviennent des unités de conception architecturale de plus en plus centrales.
Le GB300 NVL72 de NVIDIA est un excellent exemple de cette approche « au niveau du rack ». Dans leur architecture de référence d’entreprise, un rack GB300 NVL72 refroidi par liquide est traité comme une unité d’extension indépendante standard, intégrant 18 tiroirs de calcul et 72 GPU. Pour créer un pool de calcul plus vaste, plusieurs unités de ce type au niveau du rack peuvent être connectées et étendues horizontalement via des réseaux de calcul dédiés, des réseaux convergés et des réseaux de gestion.
Cette architecture ne peut pas être exploitée efficacement en assemblant simplement un grand nombre de serveurs hautes performances. Pour assurer une communication rapide entre les nœuds et faciliter l'expansion future, le câblage réseau, les interconnexions, la distribution électrique et les solutions de refroidissement liquide doivent être intégrés dès le départ à la conception globale de l'infrastructure.
Les racks de serveurs haute densité imposent non seulement d’énormes exigences aux capacités d’alimentation électrique et de refroidissement liquide du centre de données, mais l’important trafic est-ouest entre les GPU et les serveurs représente également un défi accru pour la bande passante, la topologie et l’évolutivité du réseau.
Par conséquent, lors de la planification des clusters de calcul aujourd'hui, les questions essentielles ne sont plus aussi simples :
Performances de la puissance de calcul de l'IA : les seules mises à niveau matérielles ne suffisent pas
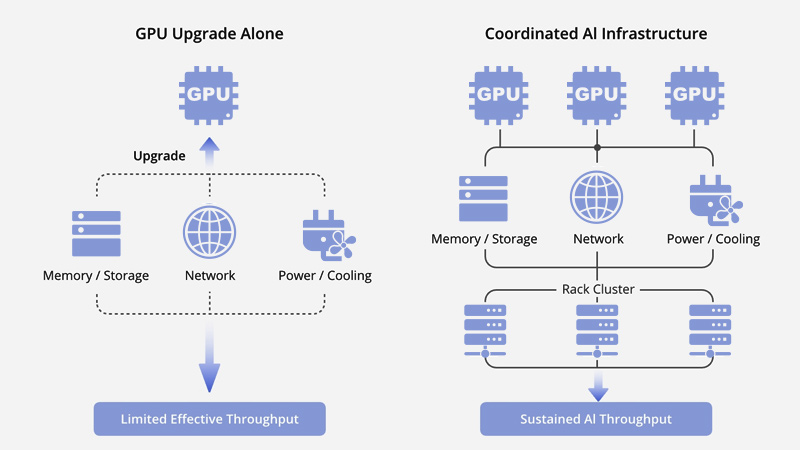
L’ajout de matériel plus performant peut effectivement améliorer les systèmes d’IA, mais la mesure dans laquelle cette valeur se concrétise dépend de la capacité de l’infrastructure sous-jacente à convertir réellement les capacités théoriques de ces appareils en résultats concrets dans les opérations de l’entreprise.
Efficacité du chemin de données
Le débit de stockage, la bande passante mémoire, ainsi que le prétraitement des données et les canaux d'entrée, déterminent collectivement si l'accélérateur peut recevoir les données à temps. Si la transmission des données est ne serait-ce que légèrement ralentie, la puissance de calcul théorique séduisante du GPU sera gaspillée. En outre, les performances du stockage ont un impact direct sur la sauvegarde des points de contrôle du modèle, la récupération après panne, l'extraction des caractéristiques et le traitement des données intermédiaires. Par conséquent, la norme utilisée pour mesurer cette capacité ne consiste pas à se concentrer sur les paramètres d'un seul disque dur ou module mémoire, mais à évaluer si l'ensemble du chemin de données peut prendre en charge la charge de travail réelle de l'entreprise.
Avantages réels de la communication réseau
La bande passante annoncée par les fabricants pour cartes réseau et les commutateurs ne représentent généralement que la capacité physique disponible et ne correspondent pas à la vitesse réellement atteinte lors de l'exécution des applications. De la topologie du réseau, de la surcapacité et de la congestion du réseau aux liaisons optiques, au câblage, à la configuration logicielle et même aux performances du terminal lui-même, tout affecte le taux réel d'utilisation du réseau par le cluster informatique. Souvent, même si des interfaces plus rapides sont utilisées pour augmenter la limite de communication, l'amélioration des performances côté application peut ne pas être proportionnelle.
L’effet d’échelle de l’expansion des clusters
L’ajout de GPU peut effectivement augmenter la puissance de calcul totale, mais les performances métier n’augmenteront pas nécessairement dans les mêmes proportions. La surcharge supplémentaire liée à la synchronisation des nœuds, à la planification des tâches, à la collaboration entre plusieurs machines et aux communications finira progressivement par réduire les avantages du matériel nouvellement ajouté.
Par conséquent, lors de la conception de l'infrastructure, les paramètres de pointe constituent certes un indicateur incontournable, mais ils doivent être pris en compte de manière globale avec le taux d'utilisation réel de l'accélérateur, le débit effectif, l'efficacité de l'extension et le temps final d'achèvement de la tâche.
À mesure que l'infrastructure d'IA évolue : plusieurs défis à relever
Le développement de l'infrastructure d'IA ne constitue pas seulement un défi technique, il nécessite également une analyse commerciale rigoureuse. Les entreprises doivent considérer non seulement la capacité supplémentaire qu'elles peuvent ajouter, mais aussi le temps nécessaire au déploiement réel de cette puissance de calcul et l'efficacité de sa conversion.
Les limites de l'infrastructure physique
Une fois arrivé au niveau du rack et du cluster, l'expansion du réseau ne consiste pas simplement à augmenter la vitesse du réseau. La densité des ports, l'emplacement des commutateurs, le câblage, la distance de transmission des modules optiques, les modèles de trafic et les taux de surdimensionnement doivent tous être repensés. Un réseau performant dans les déploiements à petite échelle peut nécessiter une refonte complète de l'architecture à mesure que le cluster s'agrandit.
L’alimentation électrique et le refroidissement imposent également de sévères limitations. Une puissance insuffisante ou un refroidissement inadéquat ne limiteront pas seulement la densité des racks et ne réduiront pas seulement le nombre de cartes accélératrices installées, mais ralentiront également le processus d’extension. Une marge de refroidissement insuffisante peut également entraîner une réduction de fréquence ou des limitations de fonctionnement des machines sous forte charge.
Par conséquent, les déploiements inter-racks ont souvent des conséquences considérables, nécessitant des ajustements de la topologie du réseau, de l'architecture de stockage, de l'alimentation et de la distribution électriques, du refroidissement, ainsi que des processus ultérieurs d'accès aux services et de gestion. Comment augmenter la capacité sans entraîner de coûts d'intégration déséquilibrés ni de dégradation des performances constitue un défi majeur.
Investissement en capital et calendrier de mise en œuvre
L'ampleur de l'investissement va bien au-delà des GPU et des serveurs. La mise en réseau, le stockage, les racks, les interconnexions de communication optique, les différents câbles, ainsi que l'alimentation électrique et l'infrastructure de refroidissement, la rénovation des centres de données et les outils de maintenance—chaque poste représente une dépense importante.
De plus, de l’approvisionnement au déploiement effectif de la puissance de calcul, plusieurs étapes sont nécessaires : préparation du centre de données, câblage des racks, configuration logicielle, tests d’interopérabilité, validation métier et transfert final. Tout goulot d’étranglement à l’une de ces étapes retardera la livraison et la disponibilité de l’ensemble du cluster.
Utilisation des équipements et anxiété liée à la mise à niveau technologique
La valeur d’un cluster d’IA ne peut pas être mesurée uniquement par sa puissance de calcul. L’utilisation des équipements, la consommation d’énergie, la maintenance quotidienne, les coûts de gestion et les machines sous-utilisées contribuent tous à l’augmentation des coûts d’exploitation globaux.
Le rythme rapide des itérations matérielles, avec les évolutions rapides des accélérateurs, des réseaux, de la consommation électrique par point unique et de la technologie de refroidissement liquide, raccourcit constamment le cycle de vie de la planification de l’infrastructure. Les entreprises doivent trouver un équilibre entre leurs besoins actuels en puissance de calcul et les risques potentiels liés à la capacité d’évolution future et aux difficultés de modification.
Interopérabilité multivendeur
L’infrastructure d’IA se compose généralement d’un ensemble d’équipements provenant de plusieurs fournisseurs. Cartes réseau, commutateurs, les modules optiques, les câbles, les serveurs ainsi qu’une grande variété de micrologiciels et de logiciels doivent tous faire l’objet d’une vérification rigoureuse de leur compatibilité avant leur déploiement en production.
Pour minimiser les risques liés à l’intégration et au dépannage, les spécifications doivent être définies tôt, les combinaisons certifiées doivent être testées et les responsabilités de support de chaque partie doivent être clarifiées.
En définitive, il s'agit d'un jeu d'équilibre commercial complet : trouver le meilleur compromis entre l'investissement en capital, la disponibilité de la puissance de calcul, l'utilisation des équipements, les coûts d'exploitation quotidiens et la flexibilité à long terme de l'architecture.
Infrastructure d’IA à grande échelle : planification et validation
Les exigences en matière d’infrastructure pour l’IA moderne augmentent. Bien plus que la sélection de composants individuels, le choix du matériel doit être considéré de manière globale dans le contexte de l’architecture complète du système et de la charge de travail.
Planification mondiale
La puissance de calcul, le réseau, le stockage, ainsi que l'alimentation électrique et le refroidissement—ces composants essentiels doivent être planifiés de manière globale en fonction de vos besoins métier, de l'échelle du déploiement, de la densité des racks et de vos plans d'expansion futurs.
Plus précisément, la topologie du réseau, l'adéquation des distances de transmission des modules optiques, les chemins de câblage, la distribution électrique, les méthodes de refroidissement, l'accès au stockage, l'agencement physique du centre de données et les futurs plans d'expansion—doivent tous être clairement définis à l'avance. Cela permet d'économiser beaucoup de difficultés et d'éviter des reprises extrêmement coûteuses dues à l'incompatibilité des appareils lors du déploiement réel.
Validation au niveau du système
Examiner uniquement les spécifications matérielles sur le papier ne suffit pas à déterminer l'utilisation possible d'une infrastructure d'IA. Pour avoir une confiance totale, une vérification complète au niveau du système est nécessaire, comprenant principalement :
Compatibilité entre différents composants matériels ;
Interopérabilité fluide entre les modules de communication réseau et optique ;
Performances durables du stockage et de l'ensemble du chemin de données ;
Communication normale pendant les opérations commerciales réelles ;
Fonctionnement stable à pleine charge pendant des périodes prolongées ;
Alimentation électrique stable et performances de refroidissement;
Dégradation de l’efficacité lors de l’expansion inter-nœuds et inter-racks.
Ce n’est qu’en achevant l’ensemble de ce processus que vous pouvez être certain que votre infrastructure est absolument fiable dans des conditions de charge réelles, au lieu de simplement obtenir des scores impressionnants lors de tests de composants individuels.
Préparation au déploiement
La préparation au déploiement ne consiste pas simplement à acheter tout le matériel. Des modèles de configuration standardisés, des nomenclatures validées (BOM), des rapports de tests de compatibilité, une documentation appropriée, des procédures d'installation et une définition claire des responsabilités en matière de dépannage— toute cette préparation immatérielle est nécessaire pour mettre votre cluster en ligne et le déployer aussi rapidement que possible.
À l'avenir, la construction de l'infrastructure d'IA ne dépendra plus uniquement de ceux qui disposent des machines les plus puissantes, mais plutôt de la manière dont ces appareils sont planifiés, connectés et testés afin de pouvoir fonctionner ensemble comme un tout pleinement opérationnel.
Conclusion
Les centres de données modernes dédiés à l’IA ont depuis longtemps dépassé l’ère de l’« optimisation des appareils pris individuellement », pour passer entièrement à des opérations collaboratives au niveau du système. Bien que les paramètres impressionnants de performance de pointe conservent leur valeur, l’utilisation réelle de la puissance de calcul dédiée à l’IA dépend de plus en plus de la coordination de la puissance de calcul, du réseau, du stockage, de l’alimentation et de la distribution électrique, du refroidissement et de l’ensemble du processus de déploiement. Pour les entreprises, le besoin réel est une architecture sous-jacente qui transforme les capacités théoriques du matériel en une capacité métier réelle hautement flexible, fiable et rentable.
Pour les besoins en réseau et en interconnexion, QSFPTEK fournit une solution complète, comprenant des commutateurs haut débit et des cartes d’interface réseau (NIC), modules optiques, ainsi que le câblage structuré. En tant que composants essentiels de l’architecture au niveau du système, ces composants améliorent efficacement la compatibilité globale du réseau, la bande passante totale, l’évolutivité et la préparation au déploiement, tout en gérant sans effort des charges de travail d’IA extrêmement exigeantes. Nous vous invitons à découvrir plus en détail les solutions d’IA de QSFPTEK et à bâtir une infrastructure d’interconnexion hautement flexible et rigoureusement éprouvée pour vos clusters de calcul.


Partager
