


Évolution de l’architecture de calcul IA : Scale-Up vs. Scale-Out et le choix des modules optiques
Auteur Moore
Date 04/02/2026

À mesure que les modèles à grande échelle atteignent des milliers de milliards de paramètres et que la taille des clusters d’IA approche des centaines de milliers de GPU, l’infrastructure informatique sous-jacente connaît une évolution architecturale majeure. Les deux modèles de réseau dominants pour le calcul d’IA—Scale-Up et Scale-Out—progressent selon des voies techniques différentes, mais dans la pratique, ils convergent progressivement sur des points clés.
Ce changement est essentiellement le résultat de compromis répétés entre « faible latence et haute évolutivité » et « haute fiabilité et maîtrise des coûts ». Parallèlement, l’évolution continue des technologies de modules optiques (telles que LPO, NPO et CPO) façonne de plus en plus la conception des systèmes.
Scale-Up vs. Scale-Out : différenciation et compromis entre deux voies
Dans la conception des clusters de calcul IA, Scale-Up et Scale-Out ont des objectifs différents dès le départ, et leurs critères d’évaluation ne sont pas alignés sur la même dimension. Ils peuvent être compris comme deux approches divergentes.
Scale-Up : architecture étroitement couplée mettant l’accent sur une faible latence et une forte cohérence
Le scale-up se rapproche de l’extension de la puissance de calcul d’un nœud unique ; il s’agit essentiellement d’une « intégration horizontale » au sein de l’architecture GPU existante. En construisant des unités de calcul fortement couplées, la mémoire locale de plusieurs GPU est abstraite en un espace logique unifié, permettant au cœur de calcul de bénéficier d’une HBM quasi locale lors de l’accès à la mémoire distante. Cette approche de sémantique proche de la mémoire vise non seulement à accroître l’échelle, mais aussi à minimiser la distance entre le calcul et les données, réduisant la latence à moins de quelques microsecondes tout en maintenant une cohérence et une stabilité élevées.
Scale-Out : modèle informatique distribué orienté vers l’évolutivité
En revanche, le Scale-Out consiste davantage à assembler une puissance de calcul dispersée en organisant un grand nombre de nœuds en un ensemble cohérent via un réseau. Les mises en œuvre typiques reposent sur une architecture Clos à deux ou trois couches, reliant des dizaines de milliers de GPU, voire davantage, au même cluster d’entraînement afin de prendre en charge le parallélisme des données, le parallélisme en pipeline et d’autres modes d’entraînement. Cette approche est axée sur l’évolutivité et la maîtrise des coûts, en garantissant que le système reste toujours disponible et puisse évoluer pour répondre à vos besoins tout en fonctionnant avec votre matériel et vos logiciels actuels.
En général, le Scale-Up consiste à améliorer les « capacités individuelles » afin d'atteindre des performances maximales et une faible latence. En revanche, le Scale-Out concerne « l'efficacité d'échelle », qui permet aux clusters à grande échelle de fonctionner sans heurts. Le premier se concentre sur les unités centrales du calcul haute performance, tandis que le second forme le réseau fondamental pour l'entraînement et l'inférence à grande échelle. Ces deux modes coexistent souvent et se complètent dans les infrastructures d'IA réelles.
Évolution actuelle : changements d’architecture Scale-Up et tendances à la simplification Scale-Out
Ces dernières années, le Scale-Up et le Scale-Out ont évolué rapidement, et les principaux fabricants ont trouvé comment les mettre en œuvre dans la pratique. L’objectif est d’améliorer les performances tout en simplifiant la complexité.
Montée en échelle : de la coexistence basée sur châssis à la coexistence multiforme, l’interconnexion 224G devient un nœud clé
Les premières solutions destinées aux entreprises en croissance se concentraient principalement sur les « chassis SuperNodes », qui rassemblaient les ressources informatiques dans un seul système et les connectaient via des liaisons à haut débit. Ces solutions mettaient l’accent sur la stabilité et la cohérence, en utilisant généralement une combinaison de « fond de panier câblé + commutation L1/L2 » : les interconnexions internes au châssis reposaient principalement sur des connexions électriques afin de garantir une forte densité de bande passante ; l’extension entre châssis reposait sur des interconnexions optiques.
Les interconnexions optiques 224G deviennent progressivement le choix dominant pour les scénarios de scale-up. Du point de vue du modèle de coût, le prix de modules optiques 1.6T restera probablement environ 1,2 à 1,4 fois celui du 800G au cours des trois à cinq prochaines années. Cette différence est assez facile à gérer, qu’elle soit basée sur une architecture LPO ou DSP traditionnelle. Mais l’utilisation de la technologie 112G implique souvent d’utiliser davantage de fibres pour la même bande passante, ce qui finit par coûter plus cher. Lorsque l’on prend en compte des facteurs tels que la bande passante, la consommation d’énergie et la complexité du câblage, la solution 224G est meilleure à long terme.
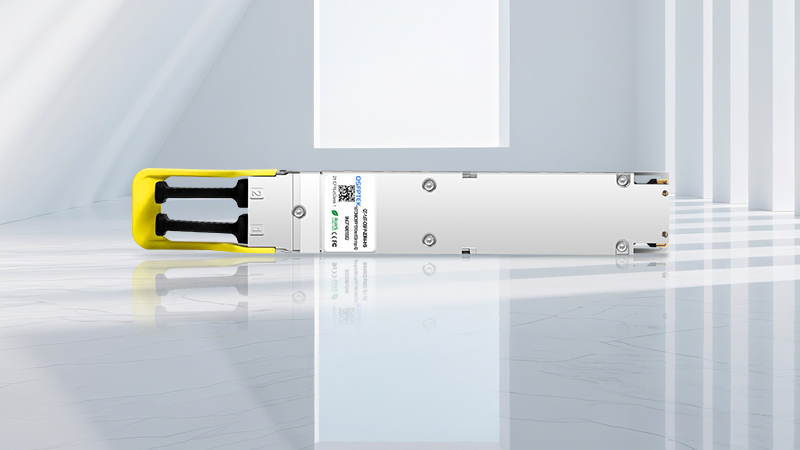
Module optique QSFPTEK 1.6T
Le secteur suit cette tendance et a commencé à développer des produits connexes, tels que les modules de la série OSFP de QSFPTEK qui prennent en charge des débits de 1.6T (par exemple, les spécifications 2×DR4 et 2×FR4). Ceux-ci visent principalement à répondre aux exigences de bande passante élevée et de faible latence des futures architectures de supernœuds. Ces produits préparent également les centres de données à la prochaine étape de leur croissance.
Scale-Out : de trois couches à deux couches, la structure du réseau s’aplatit progressivement
Un changement important dans les architectures scale-out est l’accent croissant mis sur la simplification de la conception globale. Le réseau Clos à trois couches auparavant courant est progressivement remplacé par une architecture Clos à deux couches. En réduisant le nombre de couches intermédiaires, le chemin réseau devient plus direct, ce qui réduit la complexité du système. Dans cette conception, même les clusters d’entraînement ciblant des centaines de milliers de GPU peuvent conserver une grande évolutivité tout en maîtrisant les coûts réseau.
Ce changement est largement dû aux améliorations des capacités des puces de commutation. À mesure que les tailles de ports continuent d'augmenter, par exemple avec Radix atteignant 512 ports, un réseau Clos à deux couches peut directement prendre en charge des échelles de nœuds supérieures à 100 000 et, dans certains modèles de conception, couvrir même environ 130 000 cartes accélératrices, sans nécessiter de couche de commutation centrale supplémentaire. Cela signifie que les grands clusters d'IA peuvent maintenir la densité de bande passante tout en conservant une topologie réseau plus claire lors de la mise à l'échelle.
Réseaux multi-plans : réduire la pression sur la bande passante grâce à une conception multi-plans
Sur cette base, certains fabricants ont commencé à explorer de nouvelles méthodes d’organisation des réseaux. Par exemple, l’architecture Multi-Plane proposée dans des recherches connexes constitue une approche typique. Dans ce schéma, l’AI-NIC accède simultanément à différents plans de réseau Clos via plusieurs ports à haut débit ; par exemple, elle utilise quatre interfaces 200G pour connecter quatre plans de réseau indépendants et, côté émission, elle répartit le même flux de données entre les plans selon une méthode round-robin.
À l'extrémité de réception, un mécanisme de traitement des données qui prend en charge les écritures dans le désordre réassemble les données provenant de différents chemins, afin qu'une liaison unique ne devienne pas un goulet d'étranglement. Cette approche améliore l'utilisation de la bande passante sur un seul GPU dans les scénarios Scale-Out, atteignant un taux d'utilisation global de plus de 95 % dans certains modèles de test.
Du point de vue des tendances, l’accent mis sur le Scale-Out ne porte pas seulement sur l’augmentation de l’échelle, mais sur l’obtention d’un équilibre plus raisonnable entre bande passante, efficacité et coût dans les clusters d’IA à très grande échelle grâce à l’optimisation structurelle et à l’innovation en matière de conception réseau.
Tendances de sélection des modules optiques : LPO/NPO gagne en popularité, CPO décline progressivement
Dans les architectures Scale-Up et Scale-Out, les modules optiques ne sont pas seulement le support de connexion, mais affectent également directement la latence, la consommation d'énergie et la stabilité des liaisons. Par conséquent, les différentes approches technologiques divergent de plus en plus dans leurs choix concernant les formats de modules optiques. Les différences entre les solutions LPO, NPO et les solutions traditionnelles avec DSP deviennent plus claires, tandis que la popularité du CPO a relativement diminué.
Scale-Up : les solutions à latence plus faible préfèrent LPO/NPO
Dans les scénarios où le système est mis à l’échelle, l’objectif est de réduire la latence et la consommation d’énergie. Cela rend les solutions LPO ou NPO sans DSP plus populaires. Ces modules optiques simplifient le chemin de traitement du signal, ce qui réduit considérablement la quantité d’énergie qu’ils consomment. Par exemple, un module 800G avec une solution LPO consomme environ 6W, soit une amélioration significative par rapport aux produits traditionnels équipés de DSP, qui consomment généralement environ 15W.
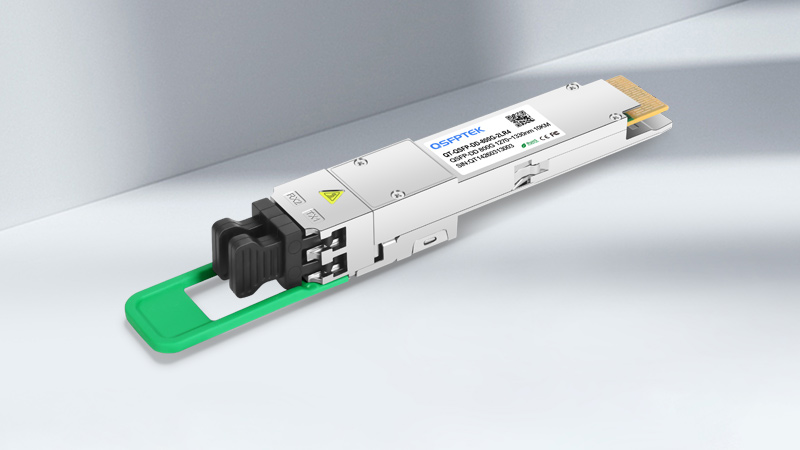
Module optique QSFPTEK 800G
Parallèlement, la participation réduite du DSP au traitement des données réduit également la latence de la liaison. La latence unidirectionnelle peut être raccourcie de plusieurs dizaines de nanosecondes, avec une réduction encore plus marquée de la latence aller-retour. Ces caractéristiques les rendent mieux adaptés aux exigences de scale-up de « courte portée, grande cohérence », et certains produits LPO optimisés pour les centres de données d'IA sont conçus autour de ces métriques.
Scale-Out : l’architecture DSP reste le choix dominant
Cependant, dans les environnements où les systèmes sont déployés à grande échelle, c’est une tout autre affaire. Les modules optiques dotés de processeurs de signal numérique (DSP) sont plus adaptés à la gestion de grandes connexions réseau et de longues distances de transmission. Pour cette raison, ils restent le choix privilégié.
D’une part, en matière de contrôle des erreurs, les DSP peuvent prendre en charge des mécanismes de correction d’erreurs directe plus complexes, permettant à la liaison d’atteindre un taux d’erreur plus faible après correction, ce qui les rend adaptés aux scénarios de transmission longue distance. Les modules LPO/NPO, en revanche, ont des capacités relativement limitées à cet égard, ne parvenant souvent pas à répondre aux exigences de stabilité pour les liaisons entre centres de données ou de l’ordre de 10 km.
D’autre part, les clusters à grande échelle impliquent généralement le déploiement mixte d’équipements provenant de plusieurs fournisseurs, ce qui impose des exigences plus élevées en matière d’interopérabilité. Les modules optiques DSP basés sur des protocoles standard (tels que IEEE 802.3) sont plus matures en matière de compatibilité multifournisseur, tandis que les normes LPO/NPO évoluent encore et que l’écosystème n’est pas encore entièrement unifié.
Dans l’ensemble, les deux voies techniques sont devenues claires : Scale-Up utilise généralement LPO/NPO pour obtenir une latence et une consommation d’énergie plus faibles. Scale-Out continue de s’appuyer sur l’architecture DSP afin d’assurer une transmission longue distance et la compatibilité du système. Malgré leurs méthodes de mise en œuvre différentes, toutes deux partagent le même objectif dans l’évolution de la bande passante—évoluer vers des débits de 224G par canal.
Les véritables défis de l’intégration et de la mise en œuvre : opportunités et limites coexistent
Lorsque la haute fiabilité du scale-up et l’évolutivité à grande échelle du scale-out commencent à se croiser, l’orientation vers les « réseaux convergés » semble naturelle. Cependant, plusieurs obstacles incontournables subsistent entre l’expérimentation et le déploiement à grande échelle.
Différences architecturales : difficulté à unifier la sémantique de la mémoire et la sémantique des messages
Les deux systèmes fonctionnent à des niveaux différents. Le Scale-Up s’apparente à des « sémantiques de mémoire », qui permettent aux GPU d’accéder à des ressources distantes. Cela permet à tous les appareils de communiquer rapidement entre eux. Le Scale-Out, quant à lui, repose sur des « sémantiques de message », en utilisant des mécanismes comme RDMA pour l’envoi et la réception de données. Il s’agit essentiellement d’un modèle de communication explicite. Les principales différences dans la manière dont ils conçoivent et construisent leurs systèmes signifient que leur intégration est plus compliquée que le simple fait de s’assurer qu’ils peuvent tous communiquer entre eux.
Chemins de fiabilité incohérents : comment introduire des liens stables
Pour garantir la fiabilité d'une conception, Scale-Up utilise généralement une « dorsale câblée + structure de commutation » afin de réduire le risque de défaillances de liaison et de maintenir le chemin critique dans une plage de haute stabilité. En revanche, les systèmes Scale-Out utilisent généralement des modules optiques pour l'interconnexion. Pour parvenir à la convergence, une partie du trafic Scale-Out doit être détournée vers les liaisons hautement fiables de Scale-Up, ce qui nécessite la reconstruction de la topologie réseau existante. Pour les clusters comptant des dizaines de milliers, voire des centaines de milliers de cartes, de tels ajustements sont par nature des projets d'ingénierie complexes.
Collaboration entre fournisseurs : les normes et les écosystèmes restent fragmentés
Les réseaux convergés ne sont pas seulement une question d’architecture ; ils impliquent également une collaboration au sein de l’industrie. Un alignement plus étroit des normes est nécessaire entre les puces de commutation, les GPU et les modules optiques. Par exemple, les solutions liées au LPO reposent encore sur l’affinement de spécifications unifiées pour l’interopérabilité multifournisseur. Parallèlement, les structures de commutation basées sur la mémoire doivent s’adapter aux implémentations d’interfaces des différents fournisseurs de GPU. Actuellement, les principaux fournisseurs se concentrent principalement sur leurs propres écosystèmes, et les protocoles ainsi que les voies de mise en œuvre ne sont pas entièrement unifiés, ce qui a ralenti dans une certaine mesure le rythme de la convergence.
Autour de ces questions, certaines interrogations clés émergent : LPO a-t-il la possibilité de réaliser une percée en matière d’interopérabilité et de devenir une solution d’interconnexion optique plus universelle ? Les sémantiques de mémoire et de message peuvent-elles être intégrées au niveau logiciel afin de permettre au système d’atteindre à la fois une faible latence et une grande évolutivité ?
Ce qui est certain, c’est que la concurrence pour l’infrastructure de calcul est entrée dans une phase plus profonde. Chaque ajustement apporté à la technologie des modules optiques, à la structure du réseau et aux méthodes de collaboration industrielle aura une incidence sur le résultat. Plutôt que de simplement choisir entre deux voies, une orientation plus réaliste pourrait consister à permettre à différents systèmes de fonctionner de manière collaborative au sein de la même infrastructure. Conformément à cette tendance, des idées similaires à "Scale-Across" ont également été proposées comme forme de transition reliant les deux modes.


Partager
