


Qu’est-ce qu’une usine d’IA ? Et pourquoi les optiques 800G/1.6T en sont l’épine dorsale
Auteur Moore
Date 03/20/2026

Le passage des centres de données aux usines d’IA
Quelque chose a discrètement changé dans la manière dont l’infrastructure est construite. Il n’y a pas si longtemps, un centre de données concernait principalement le stockage, la virtualisation et le traitement des requêtes des utilisateurs. Aujourd’hui, l’impression est différente. Les charges de travail sont plus lourdes, plus continues et, dans de nombreux cas, même pas liées à des actions directes des utilisateurs. Les systèmes d’IA fonctionnent en arrière-plan, générant, raisonnant, itérant, parfois enchaînant des tâches qui ne « se terminent » jamais vraiment au sens traditionnel.
Le concept d’“usine d’IA” n’est plus seulement un mot à la mode ; il devient de plus en plus une réalité. Les données sont saisies dans de grands modèles pour le traitement et la génération continue de résultats. Ce système ressemble davantage à un système industriel qu’à une architecture informatique. Tout comme NVIDIA l’avait prévu lors du lancement de la plateforme Rubin, l’objectif est de mener à bien cette révolution architecturale. Les défis auxquels nous sommes confrontés aujourd’hui vont au-delà des capacités du matériel. Au niveau de l’infrastructure, nous devons réfléchir à la manière de construire un système capable de soutenir une production d’IA à grande échelle tout en réduisant les coûts d’inférence et en améliorant la prévisibilité du déploiement.
Une fois que l’infrastructure commence à se comporter comme une usine, la pression se propage à l’ensemble de la pile. Le calcul n’en est qu’une partie. Le stockage, la mémoire, la planification, l’orchestration et, surtout, la mise en réseau commencent tous à compter de différentes manières. Vous n’avez pas seulement besoin de performances—vous avez besoin de constance sous charge, et de la capacité à évoluer sans que tout devienne fragile.
À l'intérieur de la plateforme Rubin : une conception de système d'un genre différent
En examinant Rubin de plus près, il ne suit pas vraiment l’ancien modèle de mise à niveau incrémentielle. Cela ressemble davantage à une réinitialisation. Au lieu d’améliorer des composants isolés, la plateforme rassemble plusieurs couches et les optimise dans leur ensemble. Le CPU Vera, le GPU Rubin, NVLink 6, ConnectX-9 SuperNIC, BlueField-4 DPU et Spectrum-6 Ethernet font tous partie de cette conception.
Ce type de coordination modifie le comportement des systèmes. Par exemple, les charges de travail d’entraînement MoE nécessitent désormais beaucoup moins de GPU que les générations précédentes, mais cela ne réduit pas l’activité globale. Cela ne fait que la redistribuer. L’inférence devient plus fréquente, les modèles deviennent plus complexes et les charges de travail s’étendent sur des séquences plus longues. Au final, le système déplace davantage de données, et non moins.
Le système NVL72 à l’échelle d’un rack en est une bonne illustration. Regrouper des dizaines de GPU dans une unité étroitement intégrée semble efficace—et ça l’est—, mais cela crée également des schémas de communication denses à l’intérieur du rack. Les données ne circulent plus seulement de haut en bas. Elles se déplacent constamment latéralement entre les GPU, les pools de mémoire et les accélérateurs. Cette pression interne finit par se répercuter sur le réseau plus large.
Pourquoi les usines d'IA sollicitent le réseau d'une manière différente
Le réseau au sein d’une AI Factory est suffisamment différent pour que les anciennes hypothèses commencent à s’effondrer. Il ne s’agit pas seulement d’une demande plus élevée en bande passante. Le schéma de trafic change. Le trafic est-ouest est l’élément principal, et il reste généralement élevé plutôt que de fluctuer. Les GPU échangent constamment des données, en particulier dans les scénarios d’entraînement distribué et d’inférence en plusieurs étapes. La latence devient plus visible, non pas en théorie, mais dans les performances réelles.
Dans le même temps, les technologies sous-jacentes évoluent rapidement. NVLink 6, par exemple, pousse la bande passante GPU à GPU à un niveau où chaque appareil peut gérer plusieurs téraoctets par seconde. À l’intérieur d’un seul rack, la bande passante agrégée grimpe à des centaines de téraoctets par seconde. Ce n’est pas une petite avancée—c’est une échelle entièrement différente.
Dans le domaine de l’Ethernet, NVIDIA Spectrum-X transforme la manière dont les réseaux d’IA sont construits. Au lieu de traiter l’Ethernet comme une infrastructure polyvalente, il est optimisé spécifiquement pour les charges de travail d’IA. Les améliorations d’efficacité sont évidentes, mais ce qui ressort davantage est la stabilité sous charge soutenue. Les clusters d’IA ne restent pas beaucoup inactifs, de sorte que la disponibilité et la constance commencent à compter autant que les performances de pointe.
BlueField-4 fait également partie de l’ensemble, ce qui déplace certaines fonctions de traitement des données et de sécurité hors du CPU. Il ne reçoit pas toujours autant d’attention, mais dans les déploiements à grande échelle, il aide à garder les choses gérables. Et avec l’évolution vers un stockage natif pour l’IA, où le contexte d’inférence peut être réutilisé d’une session à l’autre, le système global commence à ressembler moins à un ensemble de serveurs qu’à un pipeline coordonné.
Tout cela mène à une observation simple. De nos jours, le réseau est bien plus qu’un simple connecteur entre des nœuds informatiques. Il devient partie intégrante du processus de calcul lui-même. Et une fois que cela se produit, les limites des conceptions plus anciennes—en particulier celles fondées sur des hypothèses 400G—deviennent plus apparentes.
400G vs 800G vs 1.6T : ce qui change réellement et pourquoi c’est important
Passage de 400G passer à 800G, voire à 1.6T, peut sembler être une simple mise à niveau de vitesse. En réalité, les différences vont plus loin que les chiffres de bande passante.
400G a toujours sa place. Il est largement déployé, relativement mature et fonctionne bien dans les environnements où les schémas de trafic sont prévisibles ou lorsque le trafic n’est pas constamment saturé. Pour les charges de travail cloud traditionnelles, voire les clusters d’IA plus petits, il peut encore offrir un équilibre raisonnable entre coût et performance. Le problème est que les AI Factories ne se comportent plus ainsi. Le trafic est plus dense, plus continu et moins tolérant lorsque des goulots d’étranglement apparaissent.
Le 800G commence à prendre davantage de sens lorsque les architectures de commutateurs évoluent vers des SerDes 200G. Au lieu de combiner de nombreux liens plus lents, vous obtenez une connexion plus claire entre la capacité du commutateur et les interfaces optiques. Cela peut simplifier les choses dans certaines situations, mais surtout, cela augmente la productivité globale sans nécessiter plus d’espace. Dans les grands clusters GPU, ce type d’efficacité s’accumule rapidement.
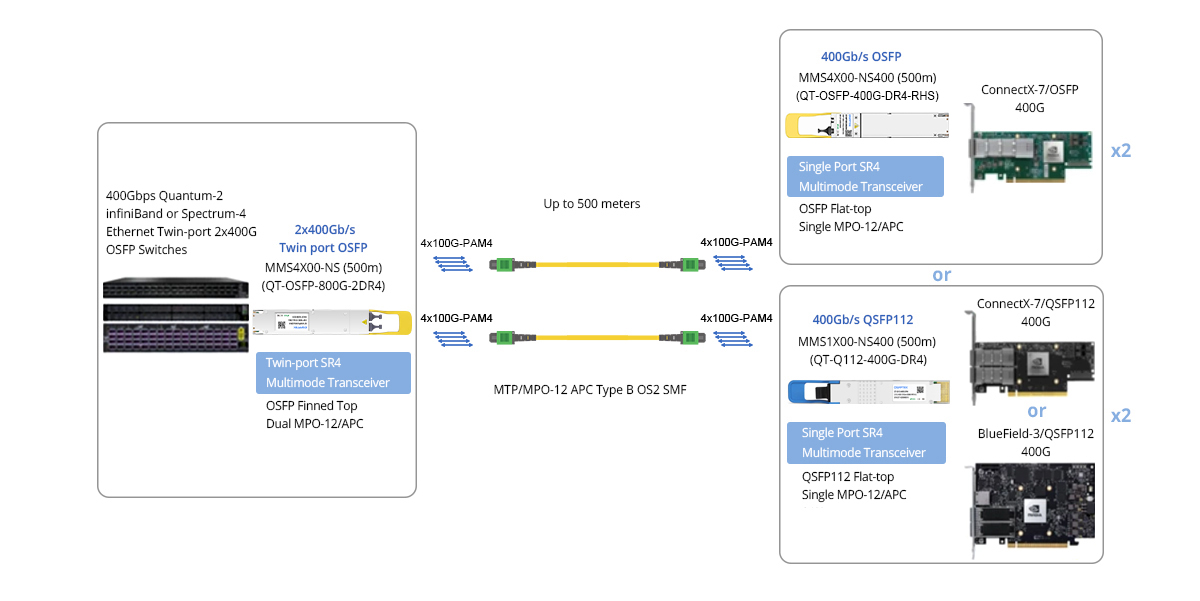
Le 800G NVIDIA/Mellanox MMS4X00-NS est compatible avec les commutateurs Quantum-2 et Spectrum-4 refroidis par air, les systèmes refroidis par liquide et DGX-H100, ainsi que les DPU ConnectX-7 et BlueField-3.
Ensuite, il y a le 1.6T, qui ne donne pas vraiment l’impression d’être une mise à niveau, mais plutôt qu’ils se préparent à l’étape suivante. Il permet une densité de ports plus élevée, ce qui signifie qu’il faut moins de commutateurs pour atteindre la même échelle. L’efficacité énergétique par bit s’améliore également, ce qui est important à mesure que la consommation d’énergie commence à limiter l’expansion. Dans les très grands déploiements d’IA—pensez à des dizaines ou des centaines de milliers de GPU—la différence entre une montée en charge avec 800G et le passage à 1.6T n’est pas seulement technique ; elle affecte aussi les modèles de coûts et l’agencement physique.
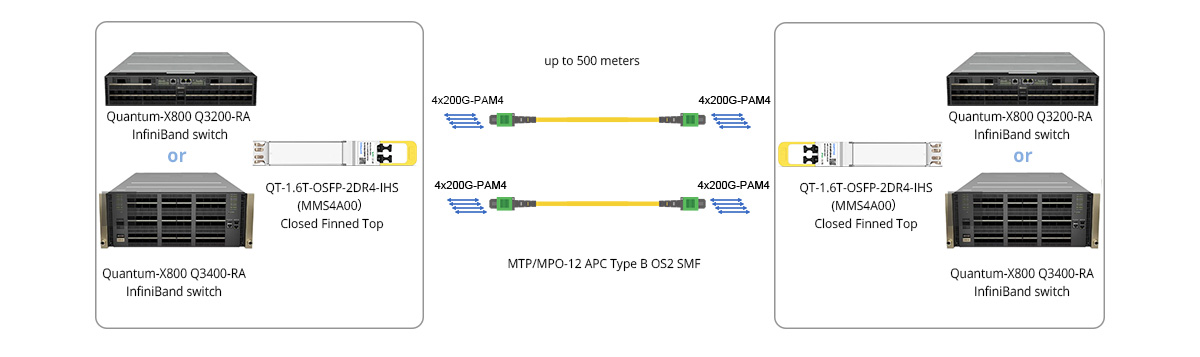
Le 1.6T NVIDIA/Mellanox MMS4A00 est compatible avec les commutateurs Quantum-3 refroidis par air et par liquide.
En pratique, ces options ne se remplacent pas du jour au lendemain. Elles coexistent généralement. Le 400G peut encore être utilisé en périphérie ou dans des segments moins exigeants. Le 800G devient la structure principale des clusters d’IA actuels. Le 1.6T commence à apparaître dans les nouvelles installations ou dans les parties du réseau où la densité et l’efficacité comptent le plus. Le « meilleur » choix dépend moins de la fiche technique que de la manière dont le système est censé évoluer au fil du temps.
C’est également là que les fournisseurs de solutions peuvent aider. QSFPTEK, par exemple, propose du 800G et modules optiques 1.6T, ainsi que les moyens de les configurer pour qu’ils fonctionnent bien dans les centres de données d’IA. L’accent est mis sur la façon dont ces niveaux s’intègrent dans des architectures réelles, et pas seulement sur les niveaux de vitesse. Dans certains cas, mélanger des générations au sein du même réseau peut donner de meilleurs résultats que d’imposer une mise à niveau complète en une seule fois.
Perspectives : pourquoi le 1.6T est plus proche qu’il n’y paraît
Bien que le 800G devienne plus courant, il ne donne pas l’impression d’être la version finale. Les charges de travail liées à l’IA augmentent, mais pas toujours de la même manière. Les modèles deviennent plus grands, mais ils deviennent aussi plus interactifs. L’inférence n’est plus un simple cycle requête-réponse. Elle peut impliquer plusieurs étapes, des outils externes et des fenêtres de contexte plus longues. Tout cela augmente la quantité de données circulant dans le système.
Il y a aussi la question de l’échelle au-delà d’un seul emplacement. Certaines des architectures les plus récentes sont conçues pour connecter plusieurs centres de données en un seul environnement logique. Cela ajoute la distance à l’équation, ainsi que de nouveaux défis de latence et de synchronisation.
Les modules optiques 1.6T s’intègrent assez naturellement dans ce contexte. Ils ne résolvent pas tout, mais ils lèvent certaines des contraintes immédiates liées à la bande passante et à la densité. Au lieu de devoir constamment composer avec des limites, la conception du réseau redevient un peu plus flexible. Cela seul peut simplifier les grands déploiements.
Conclusion
QSFPTEK se prépare à ce type de scénario avec son portefeuille 1.6T, ainsi qu’avec d’autres solutions d’infrastructure IA. Il ne s’agit pas toujours d’aller aussi vite que possible. Il s’agit plutôt de disposer de l’option prête lorsque le réseau atteint un point où les mises à niveau incrémentielles ne suffisent plus.
Au final, l’idée d’une AI Factory ramène tout à la circulation—la manière dont les données se déplacent, la vitesse à laquelle elles se déplacent et la fiabilité avec laquelle elles passent d’un endroit à un autre. Les modules optiques n’attirent généralement pas beaucoup l’attention, mais ils se trouvent directement sur ce trajet. Et à mesure que le reste du système continue de monter en échelle, leur rôle devient plus difficile à ignorer.


Partager
