


Présentation de l’émetteur-récepteur XPO : Quelle est la différence avec CPO ?
Auteur Moore
Date 05/18/2026

À mesure que les modules optiques ont évolué de 100G à 400G, 800G, et même vers 1.6T, la capacité de bande passante des centres de données a continuellement augmenté. Pendant longtemps, l’idée selon laquelle « accélérer résout le problème » a fonctionné. Cependant, à mesure que les charges de travail d’entraînement de l’IA se développent rapidement, le simple fait de s’appuyer uniquement sur des augmentations de vitesse est insuffisant.
Le goulot d’étranglement actuel ne se limite plus à savoir si la bande passante d’un seul port est suffisante; il s’est étendu à l’ensemble du système—densité de ports, maîtrise de la consommation d’énergie, espace de dissipation thermique et problèmes de maintenance ultérieure apparaissent simultanément et se limitent mutuellement.
Dans ce contexte, l’industrie explore de nouvelles voies d’interconnexion optique. D’une part, il existe des solutions hautement intégrées comme CPO ; d’autre part, de nouveaux ajustements sont apportés aux architectures enfichables. XPO (eXtra-dense Pluggable Optics) est une orientation qui a progressivement émergé dans le cadre de cette approche.
L’infrastructure d’IA entre dans une nouvelle phase de contraintes
À mesure que les centres de données s’éloignent progressivement des configurations cloud traditionnelles et adoptent des systèmes informatiques massifs axés sur l’IA, le rôle du réseau évolue également. Il ne s’agit plus seulement d’un moyen de déplacer les données — c’est un élément essentiel de l’infrastructure qui influe directement sur la qualité de l’entraînement et sur l’efficacité de l’utilisation des ressources.
En général, augmenter les débits des ports de 400G à 800G, puis à 1,6T, ne suffit pas à répondre aux besoins des systèmes réels. Le principal problème est de passer de la « bande passante par port unique » à des enjeux plus complexes au niveau du système.
La pression sur la bande passante passe d'un point unique à une portée mondiale
Lors de l’entraînement de grands modèles, de nombreux GPU ou cartes accélératrices doivent synchroniser en continu les paramètres et les gradients, ce qui entraîne des fréquences d’échange de données extrêmement élevées entre les nœuds. À mesure que la taille du modèle augmente, le trafic réseau croît nettement plus vite que l’augmentation du débit d’un seul port.
Même si les vitesses d’interface continuent d’augmenter, la densité de bande passante réseau peut encore facilement limiter l’efficacité de l’entraînement, en particulier dans les scénarios d’entraînement parallèle multi-nœuds.
Les problèmes de fiabilité sont amplifiés dans les déploiements à grande échelle
Dans les clusters d’IA, le nombre de liaisons de modules optiques peut facilement atteindre des dizaines de milliers, voire davantage. Si l’échelle augmente, même si chaque liaison ne tombe pas souvent en panne, il y aura probablement certains problèmes. Il sera difficile d’éviter complètement ces problèmes.
Dans ce type d'environnement, si une liaison tombe en panne, cela affecte bien plus qu'une simple zone locale. Vous pouvez mettre en pause, reprogrammer ou annuler des tâches d'entraînement utilisant toutes les ressources de calcul. La fiabilité du réseau est bien plus qu'une simple fonctionnalité visuelle. L'activité doit fonctionner sans heurts.
Les systèmes de refroidissement évoluent vers des architectures de refroidissement liquide.
Alors que la consommation d’énergie des puces de calcul pour l’IA continue d’augmenter, les solutions traditionnelles de refroidissement par air approchent de leurs limites, et le refroidissement liquide devient l’approche dominante pour les centres de données à haute densité.
Cela impose également de nouvelles contraintes aux dispositifs d’interconnexion optique : non seulement les performances du signal doivent être garanties, mais la conception structurelle, le choix des matériaux et la conception thermique doivent également être adaptés aux environnements de refroidissement liquide afin de prendre en charge des déploiements au niveau de la baie à plus forte densité.
L’efficacité énergétique est devenue l’un des indicateurs clés de la conception des réseaux
Dans les clusters d’IA à haute densité, les ressources électriques doivent être redistribuées entre le calcul et le réseau. À mesure que l’échelle du système augmente, la consommation d’énergie côté réseau ne peut pas être ignorée.
Par conséquent, la « puissance par bit » s’est imposée comme une métrique essentielle pour évaluer les solutions d’interconnexion optique, avec un impact direct sur les coûts d’exploitation globaux et la limite supérieure de l’efficacité énergétique du système.
Densité des ports physiques proche des limites de l’ingénierie
Les facteurs de forme des modules optiques enfichables actuellement courants (tels que OSFP) approchent des limites de densité physique à mesure que la bande passante augmente. Lorsque la bande passante des puces continue de croître tandis que la densité des ports ne peut pas augmenter simultanément, l’architecture réseau doit ajouter des couches, ce qui entraîne une latence plus élevée et des conceptions plus complexes.
Qu’est-ce que XPO (eXtra-dense Pluggable Optics) ?
À l’approche de l’OFC 2026, Arista Networks, en collaboration avec plusieurs fabricants de modules optiques, a proposé le concept de XPO (eXtra-dense Pluggable Optics). XPO peut être compris comme une solution d’interconnexion optique enfichable haute densité pour les centres de données IA de nouvelle génération. Son objectif principal est d’améliorer encore la densité de bande passante et les capacités de dissipation thermique sans sacrifier les avantages opérationnels des modules enfichables, afin de s’adapter aux environnements de calcul haute puissance.
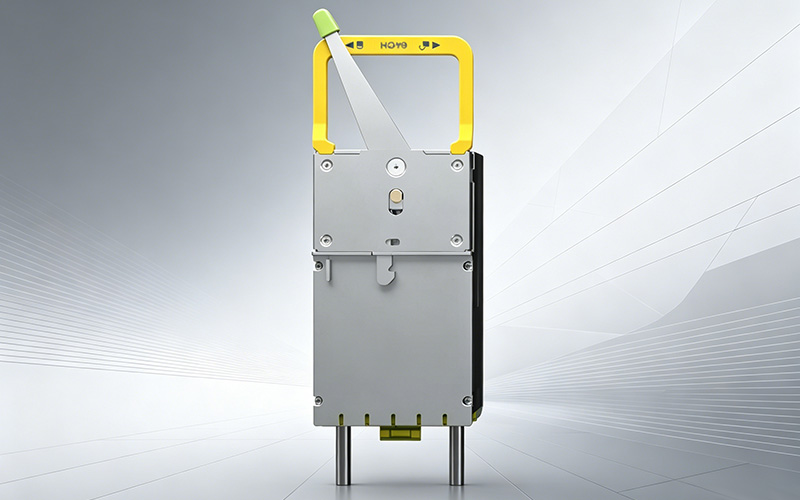
XPO est plus qu’une simple « mise à niveau de vitesse ». C’est une reconstruction complète de la structure, de l’alimentation électrique et des méthodes de dissipation thermique, entièrement axée sur la satisfaction des besoins du déploiement de l’IA au niveau des racks.
Spécifications et capacités clés de XPO
Du point de vue de la conception, XPO s’est clairement écarté de la voie d’évolution traditionnelle de l’OSFP, en s’orientant davantage vers une « unité d’interconnexion optique au niveau système » :
Tous ces facteurs renvoient à la même réalité : XPO est plus qu’un simple module optique ; c’est un composant d’interconnexion informatique haute densité.
Le changement par rapport à OSFP est bien plus qu’un simple « doublement »
Si nous utilisons des solutions traditionnelles solutions OSFP À titre de référence, XPO représente une avancée significative dans plusieurs dimensions : la bande passante d’un module unique est multipliée par environ 8, la densité du panneau est multipliée par environ 4, et c’est la première fois qu’une solution complète de refroidissement liquide est introduite dans un format enfichable standard.
Le changement le plus crucial ne réside pas dans les chiffres eux-mêmes, mais dans l’évolution de la logique de conception—passant de « l’augmentation de la vitesse d’un port unique » à « la redéfinition du format des interconnexions optiques autour de la consommation électrique et de la densité au niveau du rack ». Selon cette approche, XPO ressemble davantage à une unité d’interconnexion fondamentale, repensée pour les scénarios de très forte consommation électrique de l’IA.
Conception innovante principale de XPO :
Architecture d’empilage double PCB "Belly-to-Belly"
Le changement le plus significatif dans la structure matérielle de XPO est le remplacement de la conception traditionnelle à circuit imprimé unique par un « empilement à deux circuits imprimés ». Deux circuits imprimés à 32 canaux sont disposés de manière serrée dos à dos, redéfinissant les zones chaudes et fonctionnelles au niveau du système.
Cette structure place les composants générant beaucoup de chaleur (comme les circuits émetteurs et les modules de pilotage laser) dans la « zone chaude » intérieure, et place les composants à faible consommation (comme les récepteurs et la logique de contrôle) dans la « zone froide » extérieure. L’idée principale de cette méthode est de réduire le trajet que la chaleur doit parcourir, ce qui permet à la chaleur d’entrer plus rapidement dans le système de refroidissement et améliore l’efficacité de son évacuation.
À mesure que davantage de canaux sont intégrés dans un seul module, l’aspect mécanique devient plus exigeant. Il y a de nombreux endroits où poser les doigts, il faut donc plus d’effort pour brancher et débrancher. Avec le temps, cela peut rendre la maintenance courante un peu plus fastidieuse, surtout dans les configurations complexes.
Refroidissement liquide au niveau du module : intégré directement dans le module optique
XPO inclut désormais le refroidissement liquide dans le module. La plaque froide est prise en sandwich entre deux PCB. Cela permet d’évacuer ensemble la chaleur des deux couches par un chemin plus court et plus direct. Cela signifie que vous n’avez pas besoin d’utiliser de l’air extérieur ni de conduits pour déplacer l’air, ce qui vous permet d’éliminer la chaleur directement à l’endroit où elle est générée.
En pratique, cette conception peut gérer des TDP de 400W ou plus. Lorsque la température du liquide de refroidissement est d’environ 40–45°C, la température globale est généralement inférieure de 20 à 25°C à celle des solutions traditionnelles de refroidissement par air.
Les connecteurs sont des raccords rapides à branchement aveugle avec une conception étanche, capables de résister à environ 500 insertions et retraits répétés. L'intérieur de la plaque froide n'est pas qu'un simple morceau de métal ; il intègre des canaux d'écoulement qui longent les zones de chaleur concentrée. La structure est simple, avec une seule entrée et une seule sortie. L'approche globale s'apparente davantage à une solution de plaque froide pour GPU qu'à un système de refroidissement par module « externe » traditionnel, et elle ressemble à une conception au niveau système.
Architecture électrique et alimentation 50V
Aux niveaux du signal et de l’alimentation électrique, XPO a également été repensé. Son architecture électrique prend en charge 64 canaux électriques haut débit, chacun à 200Gbps PAM4, atteignant une bande passante totale de 12.8Tbps, et il est prévu qu’elle évolue vers des canaux à 400Gbps afin d’atteindre une capacité de 25.6Tbps.
Plusieurs caractéristiques clés de la conception électrique sont :
Premièrement, une disposition optimisée des canaux : les signaux Tx et Rx sont positionnés sur des côtés opposés de la carte paddle afin de réduire la diaphonie et d'améliorer l'intégrité du signal, ce qui la rend mieux adaptée aux scénarios d'architecture à pilotage linéaire (LPO).
Deuxièmement, les sections d’alimentation et de contrôle sont conçues séparément. Les signaux de contrôle basse vitesse (comme I2C/I3C, les signaux de réinitialisation et d’alarme) utilisent un connecteur central distinct. Ce connecteur est physiquement séparé du canal de données à haut débit. Cela réduit les interférences électriques, améliore la stabilité des signaux de contrôle et empêche les liaisons à haut débit de les affecter.
Plus important encore, l’architecture d’alimentation a été améliorée. XPO utilise une entrée CC de 46–53V (généralement autour de 48V/50V), directement depuis l’alimentation par bus au niveau du rack. Par rapport aux modules 3.3V traditionnels, cela réduit considérablement les besoins en courant, réduisant ainsi les pertes en ligne et la taille des connecteurs, tout en améliorant l’efficacité globale de l’alimentation. Cette conception s’inscrit également mieux dans la tendance future de l’alimentation CC haute tension dans les centres de données.
L’impact réel de XPO sur l’architecture des centres de données
L’importance de XPO va au-delà de la fabrication individuelle modules optiques ou les dispositifs de commutation. Il affecte directement la conception de l’ensemble du centre de données. Lorsqu’un seul module apporte de grandes améliorations en matière de bande passante, de consommation d’énergie et de dissipation thermique, ce changement s’accumule couche après couche le long de la hiérarchie du réseau. Au final, cela affecte la capacité globale du système, son utilisation et la structure globale des coûts.
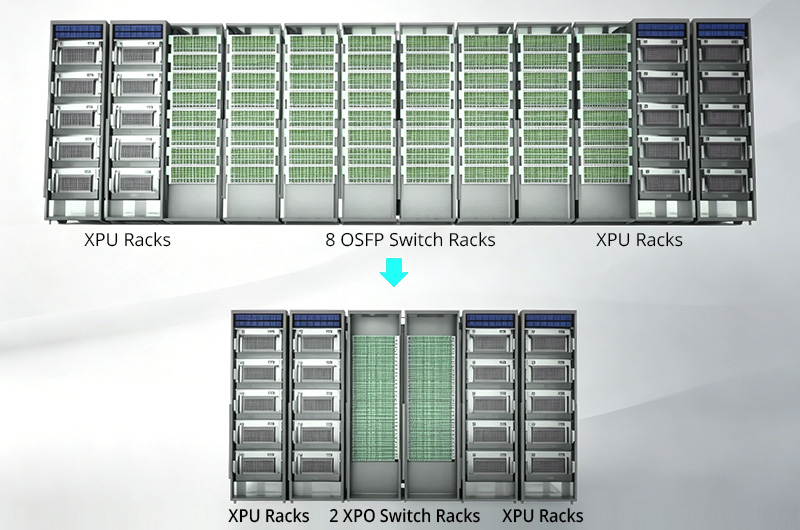
Du point de vue de la conception du système, par exemple, pour construire un réseau avec une capacité de commutation totale de 204.8 Tbps, l’espace en rack requis par la solution XPO ne représente qu’environ un quart de celui de la solution OSFP traditionnelle, ce qui correspond à une augmentation d’environ quatre fois de la densité de bande passante. Cela signifie que, dans le même espace physique, les équipements réseau peuvent prendre en charge un débit plus élevé, fournissant ainsi une infrastructure plus compacte pour l’entraînement de l’IA et le calcul haute performance.
Dans un environnement typique de rack refroidi par liquide ORv3 (HPR), la différence entre les deux solutions est également très significative. La consommation électrique d’un seul rack dans une architecture OSFP traditionnelle est d’environ 32 kW. En comparaison, la solution XPO peut porter cette valeur à environ 128 kW, ce qui est plus proche de la plage de densité de puissance de 120 kW et plus généralement prévue pour les systèmes refroidis par liquide. Dans les déploiements pratiques, la solution OSFP ne parvient souvent pas à exploiter pleinement les capacités de l’infrastructure refroidie par liquide. En revanche, XPO permet une meilleure adéquation entre la consommation électrique et la capacité de dissipation thermique, favorisant une utilisation plus complète des ressources énergétiques et de refroidissement, et améliorant ainsi les performances globales du TCO.
En bref, XPO peut fournir environ quatre fois plus de capacité réseau dans le même espace. Cette amélioration ne se limite pas à un gain de place ; elle influe également sur le coût de mise en place d’un centre de données, le délai de déploiement et la complexité de son exploitation.
Dans les scénarios d’IA hyperscale, cet avantage est encore plus marqué. Par exemple, un centre de données d’IA de niveau 400MW avec environ 128,000 XPU utilisant une topologie Clos à trois couches nécessite environ 12.8Tbps de bande passante scale-up et 1.6Tbps de bande passante scale-out. Dans une architecture OSFP traditionnelle, la capacité de commutation par rack est d’environ 1.64 Pbps. Cependant, l’architecture XPO peut atteindre environ 6.55 Pbps, réduisant le nombre de racks d’environ 75 %.
Cette réduction du nombre de racks réduit la demande en infrastructure, comme l’alimentation électrique, le refroidissement et le câblage. Les coûts globaux de construction sont ainsi considérablement réduits. XPO peut également être utilisé dans les environnements de centres de données existants pour augmenter la densité de déploiement des accélérateurs sans nécessiter d’espace physique supplémentaire, améliorant ainsi l’utilisation des ressources existantes.
La différence fondamentale entre XPO et CPO
Aujourd’hui, il existe deux principales façons de connecter des dispositifs optiques : XPO et CPO. XPO se concentre sur l’« intégration profonde », ce qui signifie que les dispositifs sont entièrement connectés. En revanche, CPO vise à exploiter au mieux l’espace disponible, ce qui est important pour les dispositifs enfichables.
CPO : intégration extrême pour des performances maximales
La Co-packaged Optics intègre directement le moteur optique et la puce de commutation. Cela se traduit par un chemin de signal plus court, des pertes plus faibles et une meilleure efficacité énergétique. En théorie, cette conception peut offrir une densité de bande passante plus élevée et une consommation d’énergie plus faible, indiquant une voie d’évolution à plus long terme.
Mais il y a aussi certains problèmes à prendre en compte. Les composants optiques et la puce de commutation sont étroitement connectés. Si le module optique ou ses pièces ne fonctionnent pas correctement, la tâche peut devenir assez compliquée. Souvent, cela signifie apporter des modifications à l’ensemble de l’appareil, voire à l’ensemble du système. Cela peut entraîner des coûts plus élevés et une maintenance et un remplacement plus compliqués.
Le CPO exige également des niveaux extrêmement élevés de maturité des processus de fabrication et de la chaîne d’approvisionnement. Pour le moment, il n’est pas clair s’il est prêt pour une utilisation commerciale à grande échelle, il est donc difficile de dire à quelle vitesse il sera adopté.
XPO : optimisation de l’ingénierie au sein d’une architecture enfichable
XPO diffère de CPO parce qu’il ne cesse pas d’utiliser l’architecture enfichable. Au lieu de cela, il apporte des améliorations au système actuel. XPO se rapproche des performances de CPO en augmentant la densité des canaux, en ajoutant le refroidissement liquide et en améliorant l’alimentation électrique. Il conserve également la même remplaçabilité modulaire.
Cette conception permet d’atteindre un équilibre plus réaliste entre la maintenabilité, la flexibilité de mise à niveau et les coûts de déploiement, ce qui la rend plus adaptée aux besoins de mise en œuvre technique des centres de données à grande échelle actuels.
Différences dans le choix du point de vue de l’ingénierie
Le CPO se concentre davantage sur des objectifs techniques à long terme, tels que des performances extrêmes et les évolutions futures. Mais il reste difficile à utiliser à court terme. Le XPO, en revanche, est un choix plus pratique. Il établit un équilibre entre l’amélioration des performances et le maintien de la simplicité, ce qui facilite son utilisation à grande échelle par les fournisseurs de cloud.
Pour cette raison, dans les environnements de centres de données cloud qui privilégient la stabilité et la maintenabilité, les solutions enfichables restent très attractives.
Résumé
Dans l’ensemble, XPO et CPO ne sont pas de simples substituts ; ils sont plutôt susceptibles de coexister dans différents scénarios d’application sur le long terme. CPO représente la limite supérieure à long terme de l’architecture, tandis que XPO représente une voie d’évolution plus rapide au sein de l’écosystème industriel existant. La forme future des réseaux de centres de données dépendra largement de l’arbitrage continu entre les « limites de performance » et la « faisabilité technique ».


Partager
