


Addestramento dell’IA e inferenza dell’IA: perché richiedono architetture di rete diverse
Autore Moore
Data 08/03/2026

Con l'accelerazione dell'adozione dell'AI da parte delle aziende, il training AI e l'inferenza AI compaiono sempre più spesso nella stessa strategia infrastrutturale. Tuttavia, trattarli come carichi di lavoro simili può facilmente portare a insidie nella pianificazione della rete. In realtà, la differenza tra training e inferenza va ben oltre il livello applicativo; corrispondono a obiettivi prestazionali, caratteristiche del traffico e priorità operative completamente diversi. Ciò impone che un'architettura di rete non possa fare affidamento su un unico modello di pianificazione del traffico per gestire simultaneamente entrambe le estremità.
Che cos'è l'addestramento dell'IA?
L'addestramento dell'IA consiste nel costruire e migliorare continuamente un modello fin dall'inizio, utilizzando una grande quantità di dati e calcoli ripetuti. L'obiettivo è semplice: in un ambiente distribuito di grandi dimensioni, puntare a migliorare la precisione del modello riducendo al minimo il tempo di addestramento.
Nella maggior parte dei casi, l'addestramento dell'IA genera molto traffico di rete tra GPU, server e cluster. Questo tipo di carico dipende molto dalla disponibilità di larghezza di banda sufficiente, da buoni meccanismi di sincronizzazione e da un throughput prevedibile. Pertanto, quando progettano reti per gli ambienti di addestramento, di solito si concentrano sul mantenimento delle pipeline di dati alla massima capacità, sull'eliminazione dei colli di bottiglia nella comunicazione e sul supporto al calcolo parallelo su larga scala all'interno dell'infrastruttura complessiva dell'IA.
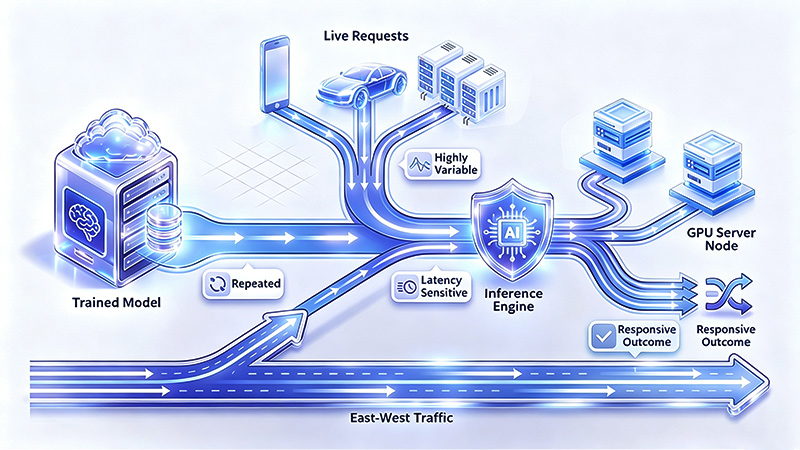
Che cos'è l'inferenza AI?
In parole semplici, l'inferenza IA consiste nel distribuire un modello addestrato in scenari reali—ricevendo ed elaborando richieste immediate e fornendo risultati in tempo reale o quasi in tempo reale. In questa fase, l'obiettivo non è più rendere il modello stesso più intelligente, ma fornire agli utenti o alle applicazioni di livello superiore servizi di risposta rapidi, stabili e facilmente scalabili.
Rispetto alla fase di addestramento, l'inferenza gestisce un traffico di rete molto più dinamico e a raffiche. Il traffico può essere stabile per un secondo e poi aumentare drasticamente quello successivo, determinando un'elevata pressione dovuta alla concorrenza e un'estrema sensibilità alla latenza. In questo contesto, gli standard per la misurazione delle prestazioni di rete sono cambiati: invece di perseguire semplicemente un throughput costantemente elevato, si considerano la velocità di risposta del sistema, la stabilità della qualità del servizio e la capacità di gestire vari picchi di traffico in un ambiente distribuito data center sono diventati indicatori più critici.
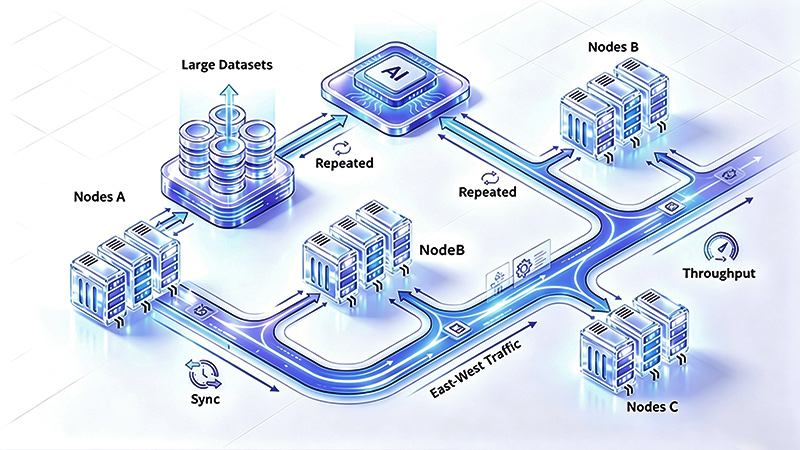
Addestramento AI vs. inferenza AI: quali sono le differenze nei requisiti di rete?
Prima di discutere la progettazione di un'architettura di rete specifica, confrontiamo l'addestramento dell'IA e l'inferenza dell'IA sotto diverse dimensioni fondamentali. Sebbene entrambi rientrino nella stessa infrastruttura IA, i loro obiettivi prestazionali, le caratteristiche del traffico e le priorità operative sono completamente diversi. Comprendere queste differenze spiega perché è improbabile che un'unica strategia di pianificazione della rete riesca a gestire efficacemente entrambi gli aspetti contemporaneamente.
Perché carichi di lavoro diversi richiedono priorità di pianificazione diverse?
Capire la differenza tra addestramento e inferenza dell'IA non significa semplicemente etichettarli. La contraddizione più importante è che queste due attività spingono la rete in direzioni di ottimizzazione completamente diverse.
Diamo innanzitutto un'occhiata al training dell'IA. La rete deve essere in grado di gestire comunicazioni a lungo termine e ad alto volume tra le risorse di calcolo. Se la pianificazione del traffico è inefficiente, la conseguenza più diretta è che la potenza di calcolo delle GPU non viene sfruttata appieno, i cicli di training si prolungano e l'infrastruttura costruita con tanta fatica viene sprecata. Pertanto, i requisiti fondamentali della rete di training sono molto chiari—: perseguire un throughput elevato, l'equità nella pianificazione dei volumi elevati e un'efficienza di trasmissione costantemente stabile.
Ma con l'inferenza AI, la situazione cambia molto. Qui, il traffico si connette direttamente agli utenti o alle applicazioni, e la latenza e le variazioni diventano i principali punti critici. Non è possibile applicare semplicemente all'inferenza la stessa logica di scheduling utilizzata per l'addestramento su larga scala. Se la rete tratta tutto il traffico allo stesso modo, i tempi di risposta diventeranno imprevedibili in presenza di traffico intenso o di picchi improvvisi.
Per questo la differenza tra training e inferenza deve essere elevata al livello della progettazione di rete, invece di essere trattata come una categoria aziendale. Quando gli obiettivi prestazionali cambiano, naturalmente deve cambiare anche la logica di scheduling sottostante.
Come può la pianificazione di rete adattarsi con precisione alle esigenze dei carichi di lavoro IA?
Diverse caratteristiche del carico determinano direttamente diverse strategie di pianificazione del traffico.
Negli scenari di addestramento dell'AI, le strategie di scheduling devono enfatizzare l'elaborazione prevedibile dei flussi, un bilanciamento efficiente del carico e un'utilizzazione della rete estremamente elevata. In breve, si tratta di trasferire continuamente enormi quantità di dati tra nodi di calcolo distribuiti senza causare congestione. Questo tipo di traffico non è sensibile alla microlatenza di una singola richiesta, ma è estremamente esigente in termini di efficienza complessiva delle comunicazioni per lunghi periodi.
L'inferenza AI è tutta un'altra storia. La sua pianificazione del traffico deve essere flessibile e reattiva. La rete deve gestire rapidamente grandi volumi di traffico e rimanere stabile anche quando le richieste sono numerose. Ciò significa non solo una trasmissione veloce, ma anche la riduzione al minimo della latenza e della variabilità delle prestazioni.
In definitiva, le differenze nella logica di pianificazione tra training e inferenza possono essere riassunte in due direzioni fondamentali:
Addestramento dell'IA: L'obiettivo è massimizzare il throughput della rete attraverso flussi di dati stabili e una trasmissione efficiente.
Inferenza AI: L'attenzione è rivolta a ridurre al minimo la latenza di trasmissione attraverso una risposta rapida e l'adattamento ai picchi improvvisi del traffico.
Per gli architetti che progettano infrastrutture AI, definire chiaramente questo confine è un'attività essenziale e fondamentale che non può essere elusa.
A cosa dovrebbe essere data priorità nella progettazione dell'infrastruttura per l'IA?
Dopo aver chiarito le differenze tra addestramento e inferenza, il passo successivo consiste nel tradurre queste caratteristiche in specifiche priorità di progettazione architetturale. In breve, l'attenzione non è più sulla ripetizione delle differenze tra i due, ma su come l'architettura di rete dovrebbe essere implementata nelle distribuzioni pratiche.
Diverse considerazioni chiave includono:
Strettamente allineato alle caratteristiche aziendali: La progettazione della rete deve innanzitutto identificare il tipo di carico dominante; evita di cercare di applicare una singola architettura a tutti Attività commerciale di IA.
Corrispondenza precisa della programmazione: Le strategie di pianificazione del traffico devono allinearsi ai modelli di comportamento del carico per garantire che le strategie di rete supportino realmente gli obiettivi di prestazioni delle applicazioni.
Coordinamento complessivo delle risorse: Quando si pianifica la rete, la potenza di calcolo, il traffico e il comportamento della trasmissione devono essere considerati in modo olistico all'interno dell'infrastruttura complessiva di intelligenza artificiale, esaminando il modo in cui interagiscono.
Mantenere la flessibilità operativa: Con la crescente diffusione di training e inferenza misti, il sistema di rete deve essere in grado di adattare in modo flessibile strategie e prestazioni in ambienti con carichi misti.
Per topologie di rete orientate all'addestramento, la progettazione di reti RoCE lossless offre un riferimento altamente pratico per la trasmissione consapevole della congestione.
Conclusione
Considerare l'addestramento dell'IA e l'inferenza dell'IA come due carichi di lavoro di rete distinti è un prerequisito fondamentale per una pianificazione efficace dell'architettura. Le differenze vanno ben oltre la fase del modello nel suo ciclo di vita; influiscono direttamente sulle priorità delle prestazioni, sulle caratteristiche del traffico e sui requisiti specifici di pianificazione.
In fin dei conti, le discussioni su training e inferenza ci ricordano che la progettazione della rete deve adattarsi al mondo aziendale. Il training dipende dal throughput, mentre l'inferenza è molto sensibile alla latenza. Pertanto, le strategie di pianificazione del traffico devono essere personalizzate per rispondere a queste esigenze specifiche. Se sei un'azienda che desidera realizzare un'infrastruttura AI scalabile, questo è fondamentale per prendere decisioni di rete accurate ed efficaci.


Condividi
