


Sfruttare al massimo XDR 1.6T: la nuova pietra miliare del supercalcolo AI di prossima generazione
Autore Moore
Data 08/28/2026

Con l'affermarsi dell'addestramento IA su larga scala e dei modelli con migliaia di miliardi di parametri, i colli di bottiglia prestazionali nell'infrastruttura IA si stanno spostando—dalla pura potenza di calcolo all'interconnettività di rete. Mentre le GPU evolvono a ritmo rapido, il massiccio traffico est-ovest generato dall'addestramento distribuito cresce ancora più velocemente. Di conseguenza, la larghezza di banda, la latenza e la scalabilità della rete sono diventate i fattori chiave che determinano l'utilizzo complessivo delle risorse di calcolo dell'intero cluster.
La tecnologia di rete si è evoluta da HDR 200G a NDR 400G e 800G e oggi i contorni dell'evoluzione di prossima generazione sono già piuttosto chiari: un'architettura di interconnessione da 1.6T basata sulla tecnologia di segnale a canale singolo da 200G sta assumendo un ruolo centrale. Combinando la fotonica al silicio, DSP avanzati e una tecnologia di interconnessione ottica ad alta densità, InfiniBand XDR da 1.6T è destinato a svolgere un ruolo centrale nel supporto dei futuri cluster di supercalcolo per l'IA.
I cluster di IA stanno guidando l'evoluzione delle reti da 800G NDR a 1.6T XDR
Sfide di rete affrontate dai cluster AI hyperscale
L'addestramento AI distribuito di oggi’s richiede spesso migliaia o addirittura decine di migliaia di GPU che lavorano in tandem. La sincronizzazione dei parametri su vasta scala, l'aggregazione dei gradienti e le frequenti comunicazioni tra cluster generano un'enorme quantità di traffico di rete east-west all'interno dei data center.
Con la continua espansione delle dimensioni dei cluster, le reti HDR e NDR esistenti iniziano a mostrare colli di bottiglia, principalmente nelle seguenti aree:
Limiti di larghezza di banda: di fronte alle esigenze di comunicazione ad alta velocità dei grandi array di GPU, i collegamenti 400G stanno già faticando a tenere il passo, il che può portare a risorse di calcolo inattive e a un minore utilizzo complessivo.
Limitazioni della distanza di trasmissione: le soluzioni ottiche SR multimodali tradizionali hanno distanze di copertura relativamente brevi, il che limita direttamente la flessibilità dei data center hyperscale nella disposizione dei rack e nella pianificazione degli spazi.
Le due sfide del consumo energetico e dell'integrità del segnale: aumentare la velocità del segnale elettrico per incrementare la velocità di trasmissione comporta un forte aumento del consumo energetico e sottopone la gestione termica a notevoli sollecitazioni, oltre a porre gravi difficoltà al controllo del tasso di errore dei bit (BER).
Le reti InfiniBand sono migliorate e diventate più veloci negli ultimi 20 anni per affrontare questo tipo di problemi. A ogni passaggio generazionale hanno compiuto grandi progressi in termini di throughput, introducendo continuamente tecnologie SerDes più veloci e architetture di interconnessione sottostanti dalle prestazioni superiori.
Parametri di riferimento della tecnologia core standard del settore 1.6T
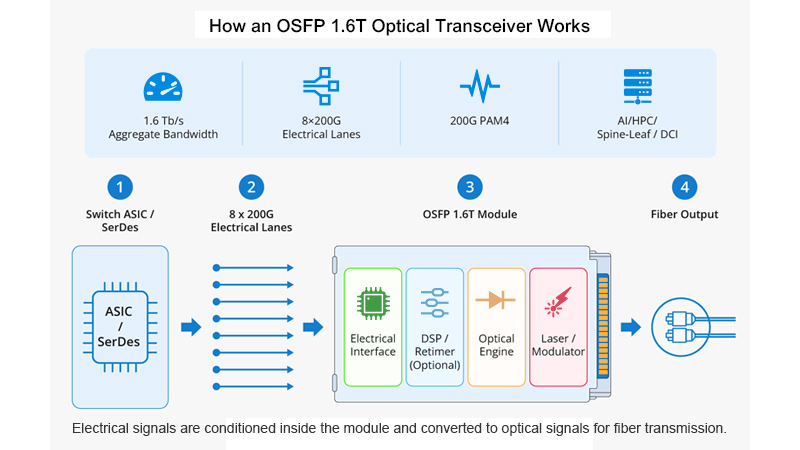
Il fulcro di questo salto generazionale risiede nell'aggiornamento completo dei segnali elettrici da 100G SerDes a 200G. Raddoppiando la larghezza di banda per canale—combinata con tecnologia DSP avanzata e un'architettura di packaging migliorata—la piattaforma XDR di nuova generazione può aumentare significativamente il limite massimo complessivo del throughput di rete senza aumentare significativamente la complessità del sistema.
Tecnologie sottostanti chiave a supporto dell'1.6T XDR
Aumentare semplicemente la larghezza di banda non è sufficiente. Per interconnessioni da 1.6T per funzionare davvero, devono evolversi insieme in diverse aree, come il packaging ottico, l'elaborazione del segnale DSP, la progettazione della gestione termica e i chip switch di basso livello, per citarne alcune.
Analisi approfondita dell'architettura hardware full-stack: 1.6T XDR vs. 800G NDR
Per costruire una rete AI ad alte prestazioni, il semplice aggiornamento dei chip degli switch è ben lungi dall'essere sufficiente. L'intera infrastruttura di interconnessione deve basarsi sul lavoro coordinato di moduli ottici, cavi in rame DAC direct-attach, cavi ottici attivi AOC e componenti di interconnessione ramificati per soddisfare i severi requisiti su diverse distanze di trasmissione.
Dalle GPU all'interno del rack alle interconnessioni degli switch, fino ai collegamenti backbone a lunga distanza che connettono diversi data center, ogni componente svolge un ruolo indispensabile nel supportare una rete altamente scalabile.
Matrice dei prodotti per moduli ottici: da 800G NDR a Silicon Photonics da 1.6T
Per i collegamenti a media e lunga distanza nei data center di intelligenza artificiale, i moduli ottici sono ancora la soluzione preferita. A seconda della distanza che il segnale deve percorrere e del tipo di fibra, il settore li suddivide generalmente in tre categorie: soluzioni multimodali SR (a breve portata), soluzioni monomodali DR (di classe data center) e soluzioni monomodali FR (a lunga portata).
Con l'avvicinarsi delle velocità dati a 1.6T, la tecnologia della fotonica del silicio (SiPh) sta diventando sempre più importante. Portare le funzioni ottiche direttamente su una piattaforma basata sul silicio rappresenta una vera svolta per la fotonica del silicio. Offre numerosi vantaggi.
Maggiore densità di integrazione
Consumo energetico inferiore
Maggiore scalabilità per la produzione di massa
Maggiore flessibilità per la gestione termica
Grazie a queste caratteristiche, la tecnologia della fotonica al silicio è diventata una delle principali strade per la futura implementazione su larga scala di reti 1.6T.
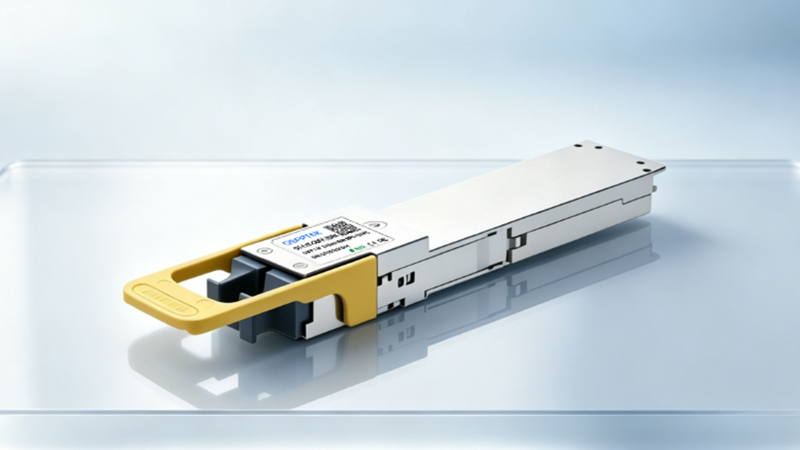
1.6T XDR OSFP DR8 (soluzione fotonica al silicio monomodale da 1310 nm)
La lunghezza d'onda operativa è di 1310 nm e utilizza la trasmissione su fibra monomodale.
La distanza di trasmissione tipica è fino a 500 metri.
Presenta un design con doppia interfaccia MPO
Architettura parallela a 8 canali, con una velocità dati di circa 200G per canale
Applicazioni tipiche: interconnessioni backbone tra switch IA di nuova generazione e implementazione di reti fabric per cluster IA hyperscale.
Serie 800G NDR OSFP
SR8 (multimodale 850 nm): utilizza fibre OM3 e OM4 per realizzare connessioni ad alta velocità su brevi distanze all'interno dei data center.
FR8 (single-mode a 1310 nm): può trasmettere su lunghe distanze, anche per diversi chilometri, consentendo di realizzare connessioni a lunga distanza tra edifici e campus.
Serie OSFP / QSFP56 400G NDR
Offre architetture collaudate come SR4, DR4 e FR4
Consente un'evoluzione e una transizione fluide dalle reti HDR
Ampiamente utilizzato sul lato di accesso dei server e nelle reti del livello di accesso.
Matrici di cavi ad alta velocità: soluzioni di interconnessione DAC e AOC
Questi cavi vengono utilizzati principalmente per collegare server GPU e switch nello stesso rack. Tra i tipi più comuni figurano i cavi in rame passivi (DAC), i cavi ottici attivi (AOC) e i cavi splitter (da 1 a 2 o da 1 a 4). Questi cavi sono diffusi per le connessioni a breve distanza nei cluster AI perché sono convenienti e consentono un cablaggio ad alta densità.
Cavi in rame passivi DAC Direct-Attach (interfacce OSFP / QSFP56): questi cavi non contengono chip di elaborazione del segnale a nessuna delle due estremità e si affidano interamente al mezzo in rame per la pura trasmissione del segnale elettrico, offrendo i vantaggi di un consumo energetico ultra-basso e di un costo ridotto. Le lunghezze più comuni sono principalmente 1 metro e 3 metri e sono progettati specificamente per le interconnessioni interne agli armadi da 1 a 3 metri. Le forme dei prodotti includono cavi standard passanti, splitter di tipo Y da 1 a 2 e splitter da 1 a 4, che consentono un'espansione flessibile ed economicamente conveniente dei nodi multi-GPU suddividendo la larghezza di banda di una singola porta.
Cavi AOC attivi: questi cavi integrano chip di conversione optoelettronica a entrambe le estremità e utilizzano fibra ottica per la trasmissione nella parte centrale, superando completamente i limiti fisici della distanza di trasmissione dei cavi in rame. Tra questi, l'AOC HDR 200G supporta distanze di trasmissione fino a 100 metri, mentre l'AOC NDR 400G può coprire distanze di diverse decine di metri; sono utilizzati principalmente per interconnessioni ad alta velocità tra rack adiacenti.
Cavi breakout: supportano specifiche di conversione, come da OSFP a 2×QSFP56 o da OSFP a 4×OSFP, consentendo di suddividere una singola porta da 800G in più downlink da 200G/400G. Sono perfetti per il networking flessibile in diversi cluster di IA e possono ridurre notevolmente le porte degli switch inattive e sprecate.
Attraverso tre generazioni: l'evoluzione dell'hardware di rete
Da HDR a NDR, e ora a XDR, il salto tecnologico coinvolto va ben oltre il semplice raddoppio dei valori di larghezza di banda. A ogni generazione evolutiva, la modulazione del segnale sottostante, l'architettura DSP, i design degli alloggiamenti ottici e il consumo energetico complessivo sono stati sottoposti a una revisione completa.
Le differenze principali tra queste tre generazioni di architetture hardware si riflettono principalmente in queste metriche fondamentali.
Il valore pratico delle reti 1.6T XDR nei cluster di supercalcolo AI
Aumenta significativamente l'utilizzo della potenza di calcolo delle GPU
Grazie all'architettura a latenza ultra-bassa che combina RDMA a 1.6T e InfiniBand, la latenza di comunicazione tra le GPU è stata ridotta all'ordine dei microsecondi. Nell'addestramento distribuito di modelli di grandi dimensioni, l'utilizzo effettivo della potenza di calcolo dei cluster GPU può passare direttamente da circa il 40% al 75%–80%, riducendo sostanzialmente il ciclo di addestramento per modelli con trilioni di parametri. Se i cluster NDR esistenti da 800G vengono aggiornati e sostituiti con una rete backbone XDR, si prevede che l'efficienza complessiva di addestramento dell'intero cluster aumenti di oltre il 40%.
Ottimizzazione dei costi del cablaggio e dell'infrastruttura del data center
Riduzione del numero totale di porte degli switch: con il doppio della larghezza di banda per porta, il numero di porte richieste da uno switch si riduce del 50% mantenendo la stessa capacità di calcolo, riducendo così significativamente lo spazio occupato nei rack, i carichi sulla distribuzione dell'alimentazione e i costi di raffreddamento.
Distanza di trasmissione estesa: i moduli della serie DR/FR monomodale da 1310nm supportano distanze di trasmissione comprese tra 500 metri e 2 chilometri. Ciò è migliore rispetto ai limiti di distanza imposti dalla fibra multimodale da 850nm nelle configurazioni fisiche dei data center. Questo facilita la suddivisione dei rack e l'aggiunta di maggiore capacità nei centri di calcolo intelligenti.
Efficienza energetica superiore su tutto il collegamento: l'integrazione della fotonica al silicio con una soluzione DSP di nuova generazione a 3 nm riduce di circa il 25% il consumo energetico per Gbps di larghezza di banda rispetto ai normali componenti discreti. Questo riduce notevolmente i costi dell'elettricità per i cluster di supercalcolo che utilizzano 10.000 schede e operano a carico elevato tutto l'anno.
Compatibile con le risorse di rete esistenti
Il protocollo XDR 1.6T funziona con NDR 800G e HDR 200G. Non è necessario ricostruire completamente i cluster 200G/400G. Basta sostituire gli switch core e i moduli ottici backbone per passare gradualmente a 1.6T. Questo ridurrà davvero i costi degli aggiornamenti iniziali.
Raccomandazioni per la selezione negli scenari comuni
Scenari aziendali diversi comportano requisiti di interconnessione diversi. Quando si sceglie l'hardware, in genere si considerano fattori come la distanza di trasmissione del segnale, la quantità di cablaggio necessaria, il budget disponibile e la necessità di espansioni future.
Sulla base delle esigenze effettive degli ambienti aziendali tradizionali, le soluzioni hardware di rete consigliate per i diversi scenari sono riepilogate come segue:
In conclusione
Osservando le tendenze tecnologiche complessive del settore, l'adozione della fotonica al silicio continua ad accelerare. Con il superamento della soglia degli 800G da parte delle velocità di rete, il valore della fotonica al silicio nel ridurre il consumo energetico e aumentare l'integrazione diventa insostituibile; allo stesso tempo, le reti 1.6T stanno passando dalla pianificazione lungimirante alla concreta implementazione commerciale e diventeranno il pilastro principale per il training AI ad alta larghezza di banda nei prossimi anni. Per quanto riguarda soluzioni a più lungo termine come la Co-Packaged Optics (CPO), l'entusiasmo per la R&D rimane alto. Sia oggi sia nel prossimo futuro, i moduli ottici plug-in maturi rimarranno assolutamente lo standard principale nel settore delle implementazioni.
Ciò significa anche che 1.6T rappresenta il passo chiave più chiaro e pragmatico nell'attuale aggiornamento dell'infrastruttura AI. Tuttavia, per rendere davvero operativa l'architettura 1.6T, il semplice aggiornamento dell'hardware degli switch è tutt'altro che sufficiente: occorre il contributo coordinato di un intero ecosistema di interconnessione, che comprenda moduli ottici, cavi ad alta velocità e architettura di rete.
Sfruttando un portafoglio prodotti completo che copre 400G, 800G e l'emergente 1.6T—inclusi moduli transceiver basati su fotonica del silicio, assemblaggi di cavi DAC/AOC ad alta densità e soluzioni di rete incentrate sull'AI— QSFPTEK si impegna ad aiutare gli utenti a costruire un'infrastruttura di calcolo altamente scalabile e ad alte prestazioni, garantendo una transizione più stabile e fluida dall'architettura NDR esistente al Fabric AI 1.6T di nuova generazione.


Condividi
