


Evoluzione dell'architettura di calcolo AI: Scale-Up vs. Scale-Out e la scelta dei moduli ottici
Autore Moore
Data 04/02/2026

Man mano che i modelli su larga scala raggiungono trilioni di parametri e le dimensioni dei cluster AI si avvicinano a centinaia di migliaia di GPU, l'infrastruttura di calcolo sottostante sta attraversando un significativo cambiamento architetturale. I due modelli di rete principali per il calcolo AI—Scale-Up e Scale-Out—stanno avanzando lungo percorsi tecnici diversi, ma nella pratica stanno gradualmente convergendo in punti chiave.
Questo cambiamento è essenzialmente il risultato di ripetuti compromessi tra "bassa latenza e alta scalabilità" e "alta affidabilità e controllo dei costi". Allo stesso tempo, la continua evoluzione delle tecnologie dei moduli ottici (come LPO, NPO e CPO) sta influenzando sempre più la progettazione dei sistemi.
Scale-up vs. Scale-out: differenziazione e compromessi tra due percorsi
Nella progettazione dei cluster di calcolo per l'AI, Scale-Up e Scale-Out hanno obiettivi diversi fin dall'inizio, e i loro criteri di valutazione non sono allineati lungo la stessa dimensione. Possono essere intesi come due approcci divergenti.
Scale-Up: architettura strettamente accoppiata che enfatizza bassa latenza e forte coerenza
Lo scale-up è più simile all'estensione della potenza di calcolo di un singolo nodo; in sostanza, riguarda l'"integrazione orizzontale" all'interno dell'architettura GPU esistente. Costruendo unità di calcolo strettamente accoppiate, la memoria locale di più GPU viene astratta in uno spazio logico unificato, consentendo al core di calcolo di sperimentare una HBM quasi locale quando accede alla memoria remota. Questo approccio basato sulla semantica near-memory mira non solo ad ampliare la scala, ma anche a minimizzare la distanza tra calcolo e dati, riducendo la latenza al di sotto dei microsecondi mantenendo al contempo elevata coerenza e stabilità.
Scale-Out: modello di calcolo distribuito orientato alla scalabilità
Al contrario, Scale-Out è più simile all'assemblaggio di potenza di calcolo distribuita, organizzando un gran numero di nodi in un insieme coeso tramite una rete. Le implementazioni tipiche si basano su un'architettura Clos a due o tre livelli, collegando decine di migliaia o persino un numero maggiore di GPU allo stesso cluster di addestramento per supportare il parallelismo dei dati, il parallelismo pipeline e altre modalità di addestramento. Questo approccio riguarda soprattutto la scalabilità e il controllo dei costi, garantendo che il sistema sia sempre disponibile e possa crescere per soddisfare le tue esigenze, lavorando al contempo con l'hardware e il software attuali.
In generale, Scale-Up riguarda il miglioramento delle "capacità individuali" per ottenere prestazioni massime e bassa latenza. D'altra parte, Scale-Out riguarda l'"efficienza di scala", che consente ai cluster su larga scala di funzionare senza problemi. Il primo si concentra sulle unità centrali nel calcolo ad alte prestazioni, mentre il secondo costituisce la rete di base per l'addestramento e l'inferenza su larga scala. Queste due modalità spesso coesistono e si completano a vicenda nelle infrastrutture AI reali.
Evoluzione attuale: cambiamenti dell'architettura Scale-Up e tendenze di semplificazione Scale-Out
Negli ultimi anni, Scale-Up e Scale-Out si sono evoluti rapidamente, e i principali produttori hanno capito come implementarli nella pratica. L'obiettivo è aumentare le prestazioni semplificando al contempo la complessità.
Scale-Up: dalla coesistenza basata su chassis alla coesistenza multi-formato, l'interconnessione 224G diventa un nodo chiave
Le prime soluzioni per le aziende in crescita si concentravano principalmente sui "chassis SuperNodes", che riunivano le risorse di calcolo in un unico sistema e le collegavano tramite link ad alta velocità. Queste soluzioni enfatizzavano stabilità e coerenza, impiegando in genere una combinazione di "backplane via cavo + switching L1/L2": le interconnessioni interne allo chassis si basavano principalmente su connessioni elettriche per garantire un'elevata densità di larghezza di banda; l'espansione tra chassis si basava su interconnessioni ottiche.
Gli interconnettori ottici 224G stanno gradualmente diventando la scelta principale per gli scenari scale-up. Dal punto di vista del modello di costo, il prezzo di moduli ottici 1.6T probabilmente rimarrà approssimativamente da 1,2 a 1,4 volte quello di 800G nei prossimi tre-cinque anni. Questa differenza è piuttosto facile da gestire, sia che si basi su LPO sia su un'architettura DSP tradizionale. Ma l'utilizzo della tecnologia 112G spesso significa usare più fibra per la stessa larghezza di banda, il che finisce per costare di più. Quando si considerano fattori come larghezza di banda, consumo energetico e complessità del cablaggio, la soluzione 224G è migliore nel lungo periodo.
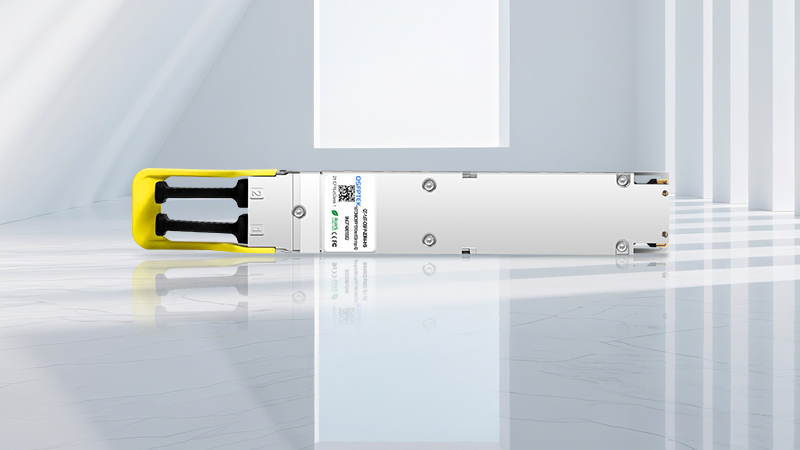
Modulo ottico QSFPTEK 1.6T
Il settore ha seguito questa tendenza e ha iniziato a sviluppare prodotti correlati, come i moduli della serie OSFP di QSFPTEK che supportano velocità di 1.6T (ad esempio, specifiche 2×DR4 e 2×FR4). Questi sono principalmente destinati a soddisfare i requisiti di elevata larghezza di banda e bassa latenza delle future architetture supernode. Questi prodotti stanno inoltre preparando i data center alla fase successiva della loro crescita.
Scale-Out: da tre livelli a due livelli, la struttura di rete si appiattisce gradualmente
Un cambiamento significativo nelle architetture scale-out è la crescente enfasi sulla semplificazione della progettazione complessiva. La rete Clos a tre livelli, precedentemente comune, viene gradualmente sostituita da un'architettura Clos a due livelli. Riducendo il numero di livelli intermedi, il percorso di rete diventa più diretto, riducendo la complessità del sistema. Con questa progettazione, anche i cluster di addestramento destinati a centinaia di migliaia di GPU possono mantenere un'elevata scalabilità mantenendo al contempo sotto controllo i costi di rete.
Questo cambiamento è dovuto in gran parte ai miglioramenti nelle capacità dei chip di switching. Man mano che le dimensioni delle porte continuano ad aumentare, ad esempio con Radix che raggiunge 512 porte, una rete Clos a due livelli può supportare direttamente scale di nodi superiori a 100.000 e, in alcuni modelli di progettazione, persino coprire circa 130.000 schede acceleratrici, senza bisogno di un ulteriore livello di switching core. Ciò significa che i grandi cluster AI possono mantenere la densità di banda mantenendo al contempo una topologia di rete più chiara durante lo scaling.
Reti multi-piano: Alleviare la pressione sulla larghezza di banda attraverso la progettazione multi-piano
Partendo da queste basi, alcuni produttori hanno iniziato a esplorare nuovi metodi di organizzazione della rete. Ad esempio, l'architettura Multi-Plane proposta in ricerche correlate è un approccio tipico. In questo schema, l'AI-NIC accede simultaneamente a diversi piani di rete Clos tramite più porte ad alta velocità; ad esempio, utilizza quattro interfacce 200G per collegare quattro piani di rete indipendenti e, sul lato di invio, distribuisce lo stesso flusso di dati tra i piani utilizzando un metodo round-robin.
Sul lato ricevente, un meccanismo di elaborazione dei dati che supporta le scritture fuori ordine riassembla i dati provenienti da percorsi diversi, in modo che un singolo link non diventi un collo di bottiglia. Questo approccio migliora l'utilizzo della larghezza di banda su una singola GPU negli scenari Scale-Out, raggiungendo in alcuni modelli di test un tasso di utilizzo complessivo superiore al 95%.
Da una prospettiva di tendenza, l'attenzione dello Scale-Out non è solo sull'aumento della scala, ma sul raggiungimento di un equilibrio più ragionevole tra larghezza di banda, efficienza e costi nei cluster AI su scala ultra-larga attraverso l'ottimizzazione strutturale e l'innovazione della progettazione di rete.
Tendenze nella selezione dei moduli ottici: LPO/NPO guadagna popolarità, CPO diminuisce gradualmente
Sia nelle architetture Scale-Up sia in quelle Scale-Out, i moduli ottici non sono solo il mezzo di connessione, ma influenzano direttamente anche la latenza, il consumo energetico e la stabilità del collegamento. Pertanto, i diversi approcci tecnologici differiscono sempre più nelle scelte relative ai fattori di forma dei moduli ottici. Le differenze tra LPO, NPO e le soluzioni tradizionali abilitate DSP stanno diventando più chiare, mentre la popolarità di CPO è relativamente diminuita.
Scale-Up: soluzioni a latenza inferiore preferiscono LPO/NPO
Negli scenari in cui il sistema viene scalato, l'obiettivo è ridurre la latenza e il consumo energetico. Ciò rende più popolari le soluzioni LPO o NPO senza DSP. Questi moduli ottici semplificano il percorso di elaborazione del segnale, riducendo notevolmente la quantità di energia che utilizzano. Ad esempio, un modulo 800G con una soluzione LPO consuma circa 6W, un miglioramento significativo rispetto ai prodotti tradizionali dotati di DSP, che in genere consumano circa 15W.
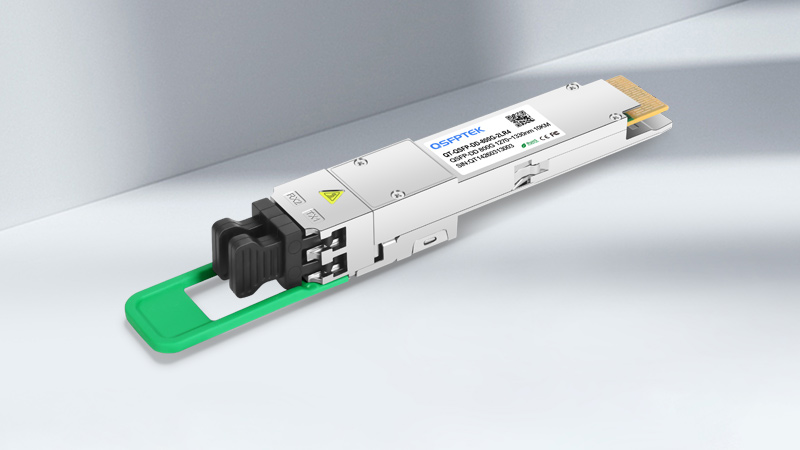
Modulo ottico QSFPTEK 800G
Allo stesso tempo, il minore coinvolgimento del DSP nell'elaborazione dei dati riduce anche la latenza del collegamento. La latenza unidirezionale può essere ridotta di decine di nanosecondi, con una riduzione ancora più marcata della latenza di andata e ritorno. Queste caratteristiche li rendono più adatti ai requisiti di scale-up di "corto raggio, elevata coerenza" e alcuni prodotti LPO ottimizzati per i data center AI sono progettati attorno a queste metriche.
Scale-Out: l'architettura DSP è ancora la scelta dominante
Negli ambienti in cui i sistemi sono scalati orizzontalmente, però, è tutta un'altra partita. I moduli ottici con processori di segnale digitali (DSP) sono più adatti a gestire grandi connessioni di rete e lunghe distanze di trasmissione. Per questo motivo, rimangono la scelta preferita.
Da un lato, in termini di controllo degli errori, i DSP possono supportare meccanismi di correzione degli errori in avanti più complessi, consentendo al collegamento di raggiungere un tasso di errore inferiore dopo la correzione, rendendoli adatti a scenari di trasmissione a lunga distanza. I moduli LPO/NPO, dall'altro lato, hanno capacità relativamente limitate in questo ambito, spesso non riuscendo a soddisfare i requisiti di stabilità per collegamenti tra data center o a livello di 10 km.
D'altra parte, i cluster su larga scala comportano in genere l'implementazione mista di apparecchiature di più fornitori, ponendo maggiori requisiti in termini di interoperabilità. I moduli ottici DSP basati su protocolli standard (come IEEE 802.3) sono più maturi nella compatibilità tra fornitori, mentre gli standard LPO/NPO sono ancora in evoluzione e l'ecosistema non è ancora completamente unificato.
Nel complesso, i due percorsi tecnici sono diventati chiari: Scale-Up di solito utilizza LPO/NPO per ottenere una latenza e un consumo energetico inferiori. Scale-Out continua a fare affidamento sull'architettura DSP per garantire la trasmissione a lunga distanza e la compatibilità del sistema. Nonostante i diversi metodi di implementazione, entrambi condividono lo stesso obiettivo nell'evoluzione della larghezza di banda—muoversi verso velocità a canale singolo di 224G.
Le vere sfide dell'integrazione e dell'implementazione: opportunità e limitazioni coesistono
Quando l'elevata affidabilità dello scale-up e la scalabilità su larga scala dello scale-out iniziano a intersecarsi, la direzione delle "reti convergenti" sembra naturale. Tuttavia, ci sono ancora diversi ostacoli inevitabili tra la sperimentazione e l'implementazione su larga scala.
Differenze architetturali: difficoltà nell'unificare la semantica della memoria e la semantica dei messaggi
I due sistemi operano a livelli diversi. Scale-Up è come la "semantica della memoria", ovvero un modo per le GPU di accedere a risorse remote. Questo consente a tutti i dispositivi di comunicare rapidamente tra loro. Scale-Out, invece, si basa sulla "semantica dei messaggi", utilizzando meccanismi come RDMA per l'invio e la ricezione dei dati. È fondamentalmente un modello di comunicazione esplicito. Le principali differenze nel modo in cui progettano e costruiscono i loro sistemi fanno sì che integrarli sia più complicato che limitarsi ad assicurarsi che possano comunicare tutti tra loro.
Percorsi di affidabilità incoerenti: come introdurre collegamenti stabili
Per garantire un design affidabile, Scale-Up utilizza in genere una "cable backplane + struttura di switching" per ridurre il rischio di guasti dei link e mantenere il percorso critico entro un intervallo di elevata stabilità. Al contrario, i sistemi Scale-Out utilizzano solitamente moduli ottici per l'interconnessione. Per ottenere la convergenza, parte del traffico Scale-Out deve essere deviata verso i link altamente affidabili di Scale-Up, richiedendo la ricostruzione della topologia di rete esistente. Per cluster con decine di migliaia o persino centinaia di migliaia di schede, tali adeguamenti sono progetti ingegneristici intrinsecamente complessi.
Collaborazione tra fornitori: standard ed ecosistemi restano frammentati
Le reti convergenti non sono solo una questione architetturale; coinvolgono anche la collaborazione del settore. È necessario un maggiore allineamento degli standard tra chip di switching, GPU e moduli ottici. Ad esempio, le soluzioni correlate a LPO dipendono ancora dal perfezionamento di specifiche unificate per l'interoperabilità tra fornitori. Allo stesso tempo, le strutture di switching basate sulla memoria devono adattarsi alle implementazioni delle interfacce dei diversi fornitori di GPU. Attualmente, i fornitori leader si concentrano principalmente sui propri ecosistemi, e i protocolli e i percorsi di implementazione non sono del tutto unificati, il che ha rallentato in una certa misura il ritmo della convergenza.
Attorno a questi temi, stanno emergendo alcune domande chiave: LPO ha l’opportunità di ottenere una svolta nell’interoperabilità e diventare una soluzione di interconnessione ottica più universale? La semantica della memoria e la semantica dei messaggi possono essere integrate a livello software per consentire al sistema di ottenere sia bassa latenza sia elevata scalabilità?
Ciò che è certo è che la competizione per l'infrastruttura di calcolo è entrata in una fase più profonda. Ogni adeguamento alla tecnologia dei moduli ottici, alla struttura di rete e ai metodi di collaborazione del settore influenzerà l'esito. Piuttosto che scegliere semplicemente tra due percorsi, una direzione più realistica potrebbe essere consentire a sistemi diversi di operare in modo collaborativo all'interno della stessa infrastruttura. In linea con questa tendenza, idee simili a "Scale-Across" sono state proposte anche come forma transitoria che collega le due modalità.


Condividi
