


Verso l'architettura Rubin: il salto delle reti dei data center AI da 800G a 1.6T
Autore Leslie
Data 04/02/2026

La piattaforma GPU Rubin di nuova generazione di NVIDIA sta guidando un cambiamento fondamentale nella progettazione dell'infrastruttura IA. Man mano che i carichi di lavoro IA crescono da miliardi di parametri a migliaia di miliardi, le sfide vanno ben oltre le prestazioni computazionali. Ciò che determina realmente l'efficienza del sistema è spesso la capacità di spostare efficacemente i dati tra migliaia di GPU. In questo contesto, la rete non è più solo un livello di supporto, ma un componente centrale che determina le prestazioni IA. Questi sistemi sono intrinsecamente progettati per un parallelismo massiccio, con una comunicazione continua e intensiva tra i nodi, rimodellando così la logica di progettazione dei data center.
Che cos'è l'architettura Rubin
L'architettura Rubin di NVIDIA è un aggiornamento rispetto all'architettura Blackwell. È una piattaforma di calcolo collaborativo full-stack progettata specificamente per l'addestramento di modelli IA su scala ultra ampia e per l'inferenza a bassa latenza. Composta da molteplici nuovi chip, offre prestazioni ed efficienza energetica superiori, supportando il funzionamento efficiente di attività IA su larga scala e fungendo da infrastruttura centrale che guida lo sviluppo su larga scala dell'IA.
A differenza delle GPU precedenti, che si concentravano principalmente sul miglioramento delle prestazioni del singolo chip, Rubin è stato progettato fin dall'inizio per sistemi di AI distribuiti su larga scala. Il suo obiettivo finale è ottenere un training efficiente su cluster contenenti decine di migliaia di GPU.
In questo ambiente, le GPU devono scambiare continuamente gradienti, parametri e dati intermedi. Il carico di comunicazione è estremamente elevato e l'efficienza della trasmissione dei dati influisce direttamente sulla velocità di addestramento. Sebbene tecnologie come InfiniBand e RDMA possano ridurre la latenza e aumentare il throughput, dipendono comunque da una larghezza di banda sufficiente a livello fisico.
Il ruolo di 800G nell'infrastruttura AI
L'interconnessione 800G è gradualmente diventata lo standard de facto per le infrastrutture AI ad alte prestazioni. Rispetto alle soluzioni 400G, 800G raggiunge il doppio della larghezza di banda mantenendo, in questa fase, un equilibrio ragionevole tra consumo energetico e complessità di implementazione.
Nelle implementazioni reali, Soluzioni 800G presentano una chiara divisione del lavoro in base agli scenari applicativi:
I DAC vengono utilizzati per connessioni a distanza ultra-breve tra GPU e switch ToR all'interno di un rack server. Il cablaggio in rame introduce quasi nessun consumo energetico aggiuntivo e ha la latenza di trasmissione più bassa, rendendolo il mezzo preferito per interconnessioni ad alta densità all'interno dei rack server.
Gli AOC sono adatti per connessioni a breve e media distanza tra rack di server. Gli AOC integrano moduli ottici e cavi, semplificando il processo di implementazione in loco, garantendo al contempo l'integrità del segnale e riducendo i requisiti di pulizia e manutenzione delle interfacce in fibra ottica.
I moduli ottici sono utilizzati nel livello backbone principale delle reti strutturate, supportando interconnessioni a lunga distanza nelle architetture Spine-Leaf. I moduli ottici, insieme ai sistemi di cablaggio in fibra ottica, consentono l'espansione della rete tra POD e regioni.
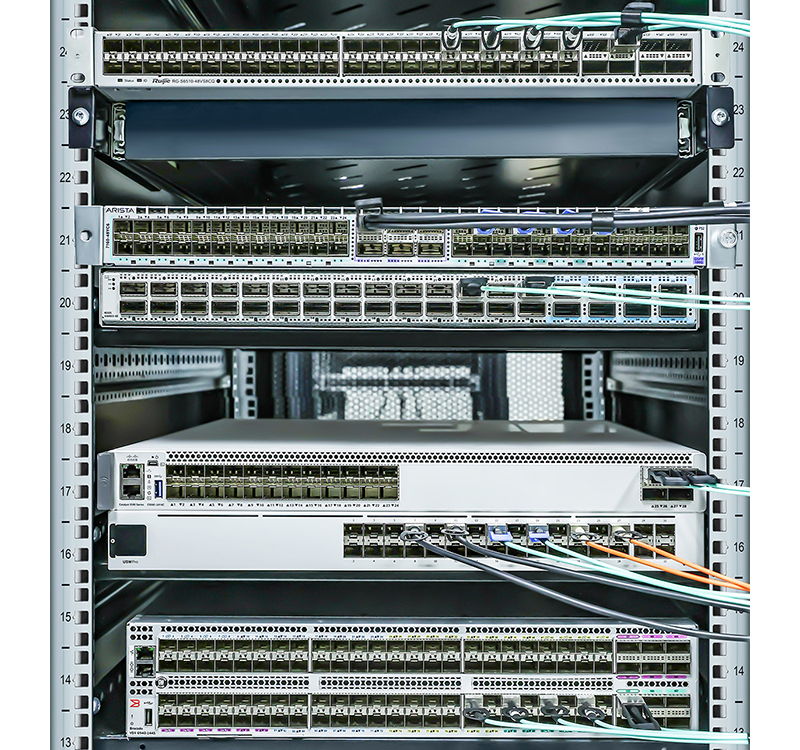
Questo approccio di implementazione a livelli riflette le reali esigenze ingegneristiche dei cluster AI su larga scala. Prendendo QSFPTEK come esempio, la sua linea di prodotti 800G copre l'intera gamma di DAC, AOC e moduli ottici. Il suo valore fondamentale consiste nel garantire che gli utenti ottengano prestazioni di compatibilità coerenti in un'architettura di rete a tre livelli. Negli ambienti di cluster AI ad alta densità e ad alto throughput, l'interoperabilità stabile tra scenari è spesso più significativa di un singolo indicatore di prestazione.
Le limitazioni dell'800G nell'era Rubin
Sebbene le soluzioni 800G siano state ampiamente collaudate negli attuali cluster AI, i loro limiti stanno diventando sempre più evidenti di fronte alla densità di calcolo di nuova generazione rappresentata dall'architettura NVIDIA Rubin.
Le principali fonti di pressione sono i seguenti tre aspetti:
Densità GPU in forte aumento: Il numero di GPU per rack si sta evolvendo dagli attuali 8 principali a 16 o 32, e la domanda di larghezza di banda aggregata all'interno del rack sta balzando dal livello Tbps a decine di Tbps, ponendo una sfida severa al rapporto di convergenza delle porte degli switch ToR.
Espansione delle dimensioni del cluster: I nodi del cluster si stanno espandendo da migliaia a decine di migliaia o persino centinaia di migliaia di nodi, e il modello di congestione della rete si sta evolvendo da hotspot locali a congestione distribuita globalmente. Il semplice aumento del numero di collegamenti porterà a un incremento superlineare della complessità del cablaggio, del consumo energetico e dei costi di manutenzione;
Evoluzione delle modalità di comunicazione: Le nuove strategie di parallelismo dei modelli, rappresentate dal parallelismo degli esperti (MoE), aumentano significativamente la frequenza di sincronizzazione tra GPU rispetto alla tradizionale architettura Transformer, richiedendo al sistema di rete di soddisfare simultaneamente i requisiti combinati di elevata larghezza di banda e bassa latenza.
Dal punto di vista della relazione di corrispondenza tra elaborazione e rete, si prevede che il throughput di elaborazione a scheda singola della piattaforma Rubin sia più del doppio di quello dell'architettura Blackwell. Se la larghezza di banda della rete rimane invariata, la proporzione di tempo di inattività delle risorse di elaborazione in attesa dei dati aumenterà significativamente, limitando direttamente l'utilizzo effettivo della potenza di calcolo delle GPU.
Perché sono necessari i moduli 1.6T
Il progresso dell'interconnessione 1.6T è guidato in gran parte dalla forte domanda di larghezza di banda di rete da parte delle architetture GPU di nuova generazione. La sua importanza risiede non solo nel raddoppio delle velocità delle porte, ma anche nel fornire un percorso tecnico praticabile per affrontare i suddetti colli di bottiglia strutturali.
Il valore fondamentale di 1.6T si riflette nelle seguenti dimensioni:
Maggiore densità di larghezza di banda: Una singola porta offre una velocità di trasmissione dati di 200GB/s. Ad esempio, uno switch a 48 porte può fornire quasi 10Tbps di larghezza di banda aggregata, riducendo di circa la metà il numero di porte e lo spazio rack occupato rispetto alle soluzioni 800G;
Topologia semplificata: A parità di dimensione del cluster, 1.6T supporta una topologia di rete più piatta, ad esempio semplificando un'architettura Clos a tre livelli in un'architettura a due livelli, riducendo il numero di dispositivi del livello Spine e, al contempo, riducendo l'accumulo di latenza causato dall'inoltro tra livelli.
Complessità operativa ridotta: La riduzione del numero di collegamenti porta direttamente a una diminuzione simultanea del numero di core in fibra, moduli ottici e punti di guasto. Nei cluster su larga scala, questo effetto può tradursi in un notevole miglioramento dell'efficienza operativa.
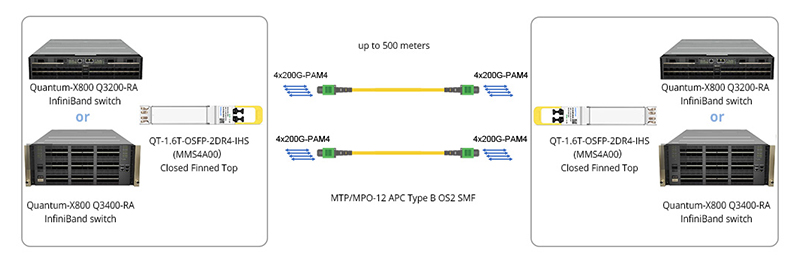
QSFPTEK ha già iniziato la sua implementazione tecnologica nella linea di prodotti 1.6T, offrendo diverse Moduli 1.6T per data center AI. Ciò significa che possono pianificare in modo proattivo l'integrazione della rete di nuova generazione sull'infrastruttura 800G esistente, anziché affrontare la pressione di aggiornamenti reattivi durante la piena implementazione dell'architettura Rubin.
Percorso di aggiornamento effettivo consigliato
L'evoluzione da 800G a 1.6T negli ambienti reali dei data center segue in genere un percorso graduale, anziché una sostituzione completa in un'unica fase.
Puoi fare riferimento al seguente percorso di aggiornamento:
Layer di accesso e interconnessioni a corto raggio: continuare a utilizzare le soluzioni 800G DAC e AOC. I vantaggi del cablaggio in rame e dei cavi ottici attivi in termini di consumo energetico e costi rimangono difficili da sostituire nel breve termine per gli scenari a corto raggio all'interno dei rack e tra rack;
Livello spine e backbone core: introdurre prima moduli ottici e switch 1.6T per trasportare il traffico aggregato tra POD, riservando un margine di larghezza di banda sufficiente per il livello core per soddisfare le esigenze di espansione future;
Transizione all'architettura ibrida: ottenere il funzionamento ibrido di apparecchiature 800G e 1.6T tramite meccanismi di aggregazione dei link o negoziazione della velocità, completando gradualmente la sostituzione generazionale dal livello di accesso al livello core, evitando spese in conto capitale una tantum e rischi di interruzione del servizio.
Per i data center che hanno già implementato un'infrastruttura 800G, viene generalmente adottato un periodo di transizione graduale di 2-3 anni. Durante questo periodo, è necessario prestare contemporaneamente attenzione alla retrocompatibilità dei moduli ottici, alla capacità riservata del sistema di cablaggio e alle capacità di coordinamento multi-rate del sistema operativo di rete.
Conclusione
Il passaggio dai moduli ottici 800G a 1.6T è essenziale per supportare l'architettura Rubin di NVIDIA’s. 1.6T offre maggiore densità di larghezza di banda, una struttura di rete più semplice e una latenza inferiore per soddisfare le esigenze dei data center di nuova generazione. Con un approccio di aggiornamento graduale, gli utenti possono far evolvere senza problemi la propria infrastruttura sfruttando al contempo appieno le soluzioni ottiche 1.6T di QSFPTEK’s per una connettività cluster stabile e ad alte prestazioni.


Condividi
