


800Gサーバー接続:AIクラスターにおけるブランチリンクとNIC導入
著者 Leslie
日付 09/15/2026

AIクラスターで800Gスイッチの導入が進む中、コアネットワークを800Gへアップグレードすることは、必ずしもサーバー側が800G単一ポート接続を必要とする—または直接サポートできる—ことを意味するわけではありません。PCIe 5.0 x16を使用するサーバーでは、単一PCIeスロットのI/O帯域幅が超高速NICの実際のスループットに制約を課します。そのため、ブレイクアウトケーブルを介して400Gまたは200G NICを800G ToRポートに接続することは、既存のサーバープラットフォームとの互換性が高い導入アプローチとなります。このトップダウンの接続チェーンでは、単なるスイッチポート仕様にとどまらず、光モジュールの消費電力、ブレイクアウトリンクでの信号損失、サーバーNICの実際のインターフェース能力といった要因も、最終的にクラスター性能を制限する変数となり得る点に注目する必要があります。
高密度ToRスイッチ導入における熱制約の管理
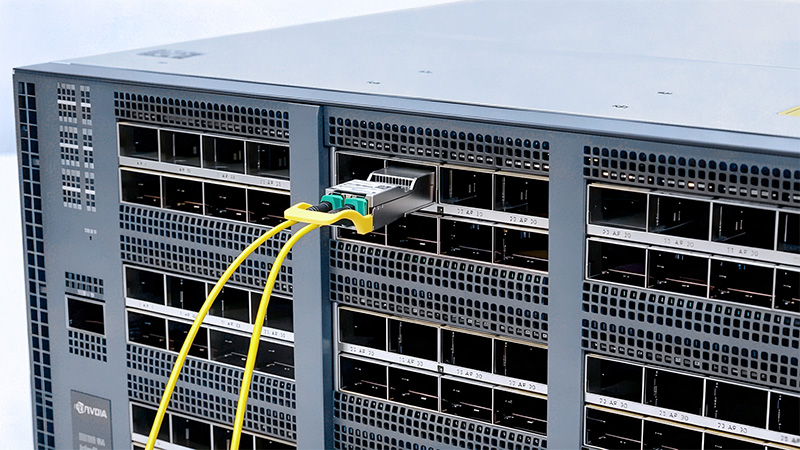
800G ポートが複数のコンピュートノードに接続するためにブレイクアウトモードで構成される場合、フロントパネルのポート密度と光モジュールの総消費電力の両方が増加します。その結果、熱管理がハードウェア選定における重要な要素となります。これは、フル実装された 1U または 2U スイッチにおいて特に当てはまり、光モジュール自体の消費電力がシステムのエアフローおよび冷却アーキテクチャに追加の熱的負荷をかけます。
シリコンフォトニクス技術は、この点で明確なアーキテクチャ上の利点を提供します。QSFPTEK’sを例にとると 800Gシリコンフォトニックモジュール 一例として、変調器—などの主要な光学部品—をシリコンベースのチップ上に高度に統合することで、モジュールはビットあたりの優れた電力効率を維持しながら8x100G PAM4信号を出力できます。この高度に統合された設計はモジュールの消費電力を抑制するのに役立ち、それにより複数のブレイクアウトリンクを介して多数の200Gまたは400Gサーバーノードを接続する際に、スイッチのフロントパネル全体の熱負荷を軽減します。
112G PAM4信号の物理リンク損失を制御
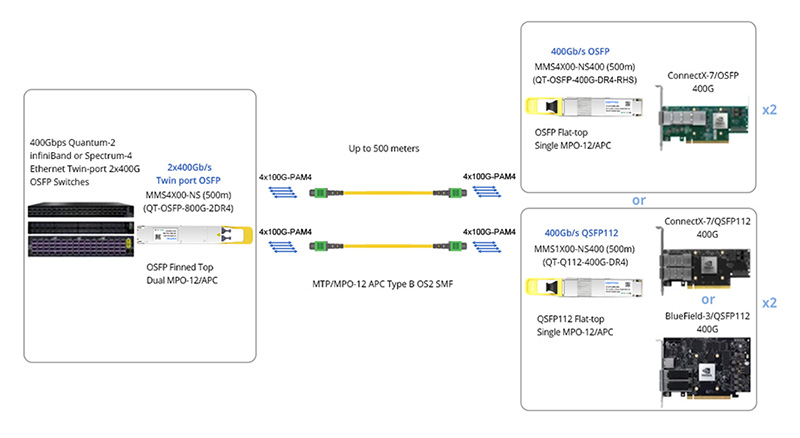
800GスイッチポートからサーバーNICへのファンアウト接続では、ラック内の垂直配線に高密度MPO-to-MPO光ファイバーパッチコードが利用されます。112Gのレーンあたり速度では、PAM4信号はリンク損失と接続品質に対してますます敏感になります。
データセンターキャビネット背面の狭く複雑なケーブル配線環境では、パッチコードは圧縮や小さな曲げ半径にさらされることが避けられません。リンク損失がシステムの光パワーバジェットを超えると、受信側のビット誤り率(BER)が上昇し、リンクの安定性が損なわれる可能性があります。高速ネットワークにおいて個々のコネクタやパッチコードによって生じる減衰は一見小さいように思えるかもしれませんが、全体のリンクバジェットが厳しい場合には厳密に管理する必要があります。このような高密度環境では、優れた曲げ性能と信頼性の高い端面品質を備えたファンアウトパッチコードを選択することで、配線に起因する追加損失を最小限に抑えることができます。QSFPTEK offers ケーブル配線ソリューション これらの高密度要件に合わせて最適化されています。AIトレーニングトラフィック—RDMA/RoCEv2—thatなどは、パケット損失と遅延に非常に敏感であるため、物理層の損失を制御することが、上位層プロトコルの安定性を確保するうえで不可欠です。
サーバーエンドポイントにおけるハードウェアオフロードとホスト側シナジーの実現
光信号がパッチケーブル経由でサーバーパネルに到達し、光電変換を受けると、トラフィック処理の責任はネットワークインターフェイスカード(NIC)に移ります。200Gや400G—などの高速ネットワークスループット—を効果的なプロトコルオフロード機構なしで処理すると、ホストCPUはネットワーク割り込みとデータ移動の管理に大量のリソースを消費せざるを得なくなります。
これに対処するため、QSFPTEK’s 200Gおよび 400G NIC ハードウェアオフロード機能を優先します。AIトレーニングクラスターでは、NIC’s RDMA機能により、データ転送に伴うCPUオーバーヘッドを効果的に最小限に抑え、通信経路上の処理負荷を軽減します。効率的なハードウェアオフロードは、貴重なホスト側の計算リソースを解放するだけでなく、エンドツーエンドの通信テールレイテンシの制御にも役立ちます—これは、パラメータ同期に依存する分散コンピューティングワークロードにとって重要な要素です。
結論
800Gネットワークがサーバー側へ拡張するにつれて、スイッチ、光モジュール、ブレークアウトパッチコード、NICは完全なエンドツーエンドリンクとして評価する必要があります。実際の導入では、単にスイッチの800Gポート速度を見るのではなく、ポートブレークアウト構成、モジュール消費電力、リンク損失、サーバーPCIe/NIC仕様の検証に重点を置くべきです。


共有
