


AIトレーニングとAI推論:異なるネットワークアーキテクチャが必要な理由
著者 Moore
日付 08/03/2026

企業が AI の導入を加速するにつれ、AI トレーニングと AI 推論は同じインフラ戦略の中でますます登場するようになっています。しかし、それらを類似したワークロードとして扱うと、ネットワーク計画において落とし穴に陥りやすくなります。実際には、トレーニングと推論の違いはアプリケーションレベルをはるかに超えており、まったく異なる性能目標、トラフィック特性、運用上の優先事項に対応しています。これは、ネットワークアーキテクチャが単一のトラフィックスケジューリングモデルに依存して両端を同時に処理することはできないことを意味します。
AIトレーニングとは?
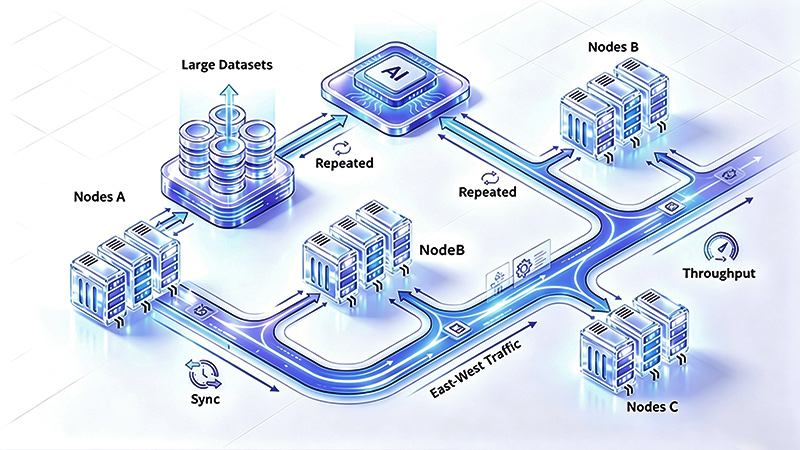
AIのトレーニングでは、大量のデータと反復計算を用いて、モデルを最初から構築し継続的に改善します。目標はシンプルです。大規模な分散環境では、トレーニング時間を最小限に抑えながらモデルの精度を向上させることを目指します。
ほとんどの場合、AIのトレーニングでは、GPU、サーバー、クラスター間で大量のネットワークトラフィックが発生します。この種のワークロードは、十分な帯域幅、優れた同期メカニズム、予測可能なスループットに大きく依存します。そのため、トレーニング環境向けのネットワークを設計する際には、通常、データパイプラインをフル稼働に保つこと、通信のボトルネックを排除すること、そしてAIインフラ全体の中で大規模な並列コンピューティングをサポートすることに重点を置きます。
AI推論とは何ですか?
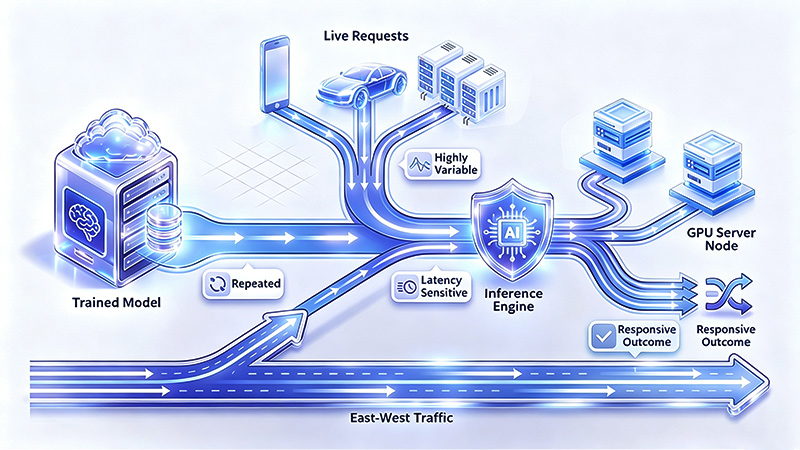
簡単に言えば、AI推論とは、トレーニング済みモデルを実環境のシナリオに導入し—即時リクエストを受信・処理して、リアルタイムまたはほぼリアルタイムで結果を提供することです。この段階での目標は、もはやモデル自体をより賢くすることではなく、ユーザーや上位レイヤーのアプリケーションに対して、高速で安定し、容易にスケール可能な応答サービスを提供することです。
トレーニング段階と比較して、推論でははるかに動的でバースト性の高いネットワークトラフィックを扱います。トラフィックはある瞬間には安定していても、次の瞬間には急激にスパイクすることがあり、高い同時実行圧力と遅延への極めて高い感度をもたらします。この文脈では、ネットワーク性能を測定する基準が変化しています。一貫して高いスループットを単に追求するのではなく、システム応答の速度、サービス品質の安定性、および分散環境でさまざまなトラフィックバーストを処理する能力が データセンター より重要な指標となっています。
AIトレーニングとAI推論:ネットワーク要件にはどのような違いがあるのか?
具体的なネットワークアーキテクチャ設計について説明する前に、いくつかの主要な観点からAIトレーニングとAI推論を比較してみましょう。どちらも同じAIインフラストラクチャの枠組みに属していますが、性能目標、トラフィック特性、運用上の優先事項はまったく異なります。これらの違いを理解することで、単一のネットワークスケジューリング戦略では両方の側面を同時に効果的に管理することが難しい理由がわかります。
なぜ異なるワークロードには異なるスケジューリング優先度が必要なのですか?
AIトレーニングと推論の違いを理解することは、単にそれらにラベルを付けるだけの問題ではありません。より重要な矛盾は、これら2つのタスクがネットワークをまったく異なる最適化方向へ引っ張ることです。
まず AI トレーニングについて見てみましょう。ネットワークは、コンピューティングリソース間の長期的かつ大容量の通信を処理できなければなりません。トラフィックスケジューリングが不十分な場合、最も直接的な影響は、GPU の計算能力が十分に活用されず、トレーニングサイクルが長引き、苦労して整備したインフラが無駄になることです。したがって、トレーニングネットワークの中核要件は非常に明確です—高スループット、大容量スケジューリングにおける公平性、そして一貫して安定した伝送効率を追求することです。
しかしAI推論では、状況が大きく変わります。ここでは、トラフィックはユーザーやアプリケーションに直接接続され、レイテンシと変動が最大の課題になります。大規模トレーニングに使われるものと同じスケジューリングロジックを、そのまま推論に適用することはできません。ネットワークがすべてのトラフィックを同じように扱うと、トラフィックが多い場合や急激なスパイクが発生した場合に、応答時間が予測不能になります。
これが、トレーニングと推論の違いをビジネスカテゴリとして扱うのではなく、ネットワーク設計レベルに引き上げる必要がある理由です。性能目標が変わると、基盤となるスケジューリングロジックも当然変更する必要があります。
ネットワークスケジューリングはAI負荷の需要にどのように正確に適合できますか?
異なる負荷特性によって、異なるトラフィックスケジューリング戦略が直接決まります。
AIトレーニングのシナリオでは、スケジューリング戦略は予測可能なストリーム処理、効率的な負荷分散、そして極めて高いネットワーク使用率を重視する必要があります。要するに、輻輳を引き起こすことなく、分散コンピューティングノード間で大量のデータを継続的に移動させることが重要です。この種のトラフィックは、単一リクエストのマイクロレイテンシには敏感ではありませんが、長時間にわたる全体的な通信効率には極めて高い要求があります。
AI推論はまったく別物です。そのトラフィックスケジューリングには柔軟性と応答性が求められます。ネットワークは大量のトラフィックを迅速に処理し、多数のリクエストがある場合でも安定性を維持する必要があります。これは高速伝送だけでなく、レイテンシとパフォーマンスの変動を最小限に抑えることも意味します。
最終的に、トレーニングと推論のスケジューリングロジックの違いは、2つの基本的な方向性に要約できます:
AIトレーニング: 安定したデータフローと効率的な伝送により、ネットワークスループットを最大化することに重点を置いています。
AI 推論: 急激なトラフィック急増に対する迅速な応答と適応により、伝送遅延を最小限に抑えることに重点を置いています。
AIインフラストラクチャを設計するアーキテクトにとって、この境界を明確にすることは、回避できない不可欠かつ基本的なタスクです。
AIインフラストラクチャの設計では何を優先すべきですか?
トレーニングと推論の違いを明確にした後、次のステップは、これらの特性を具体的なアーキテクチャ設計の優先事項に落とし込むことです。要するに、焦点はもはや両者の違いを繰り返すことではなく、実際の導入においてネットワークアーキテクチャをどのように実装すべきかにあります。
主な考慮事項には以下が含まれます:
ビジネス特性と緊密に整合: ネットワーク設計では、まず主要な負荷タイプを特定する必要があります。すべてに単一のアーキテクチャを適用しようとすることは避けてください AIビジネス.
正確なスケジューリングマッチング: トラフィックスケジューリング戦略は、ネットワーク戦略が実際のアプリケーション性能目標に真に貢献するよう、負荷の挙動パターンと整合していなければなりません。
全体的なリソース調整: ネットワークを計画する際には、AI インフラストラクチャ全体の中で、ネットワーク、計算能力、トラフィック、伝送動作を総合的に考慮し、それらがどのように相互作用するかを検討する必要があります。
運用上の柔軟性の維持: 混合トレーニングと推論の普及が進む中、ネットワークシステムは混合負荷環境で戦略と性能を柔軟に調整できる必要があります。
トレーニングに重点を置いたネットワークトポロジーでは、RoCEロスレスネットワーク設計が、輻輳を考慮した伝送のための非常に実用的な参考になります。
結論
AIトレーニングとAI推論を2つの異なるネットワークワークロードとして扱うことは、効果的なアーキテクチャ計画のための重要な前提条件です。その違いは、モデルのライフサイクルにおける段階をはるかに超え、パフォーマンスの優先順位、トラフィック特性、特定のスケジューリング要件に直接影響します。
結局のところ、トレーニングと推論に関する議論は、ネットワーク設計がビジネスの世界に適合しなければならないことを思い出させます。トレーニングはスループットに依存し、推論はレイテンシに非常に敏感です。そのため、トラフィック スケジューリング戦略は、これらの特定のニーズに対応するようカスタマイズする必要があります。スケーラブルな AI インフラストラクチャの構築を目指す企業にとって、これは正確で効果的なネットワーク上の意思決定を行うための鍵です。


共有
