


1.6T XDR の解放:次世代 AI スーパーコンピューティングの新たな礎
著者 Moore
日付 08/28/2026

大規模AIトレーニングや数兆パラメータ規模のモデルが標準となるにつれ、AIインフラにおける性能ボトルネックは、純粋な計算能力からネットワーク相互接続性へと移行しています—。GPUは急速に進化している一方で、分散トレーニングによって生成される大規模な東西トラフィックはさらに速いペースで拡大しています。その結果、ネットワーク帯域幅、レイテンシー、スケーラビリティが、クラスター全体の総合的な計算利用率を決定する重要な要因となっています。
ネットワーク技術はHDR 200GからNDR 400Gおよび800Gへと進化しており、現在では次世代進化の輪郭はすでにかなり明確です。単一チャネル200G信号技術を基盤とした1.6T相互接続アーキテクチャが中心的な役割を担いつつあります。シリコンフォトニクス、高度なDSP、高密度光相互接続技術を組み合わせた1.6T InfiniBand XDRは、将来のAIスーパーコンピューティングクラスターのサポートにおいて中心的な役割を果たすことが期待されています。
AIクラスターがネットワークの800G NDRから1.6T XDRへの進化を推進
Hyperscale AI Clusters が直面するネットワーク課題
今日の’分散AIトレーニングでは、多くの場合、数千、さらには数万のGPUが連携して動作する必要があります。パラメータの大規模な同期、勾配集約、および頻繁なクラスター間通信により、データセンター内で膨大な量の東西ネットワークトラフィックが発生します。
クラスター規模が拡大し続けるにつれて、既存の HDR および NDR ネットワークでは、主に以下の領域でボトルネックが現れ始めています:
帯域幅の制約: 大規模 GPU アレイの高速通信需要に直面し、400G リンクはすでに追いつくのに苦戦しており、計算リソースのアイドル化や全体的な利用率の低下につながる可能性があります。
伝送距離の制限: 従来のマルチモードSR光ソリューションは対応距離が比較的短く、ラックレイアウトや空間計画におけるハイパースケールデータセンターの柔軟性を直接制限します。
消費電力と信号完全性という二重の課題:スループットを向上させるために電気信号レートを高めると、消費電力が急増し、熱管理に大きな負担がかかるだけでなく、ビット誤り率(BER)制御にも深刻な課題が生じます。
InfiniBandネットワークは、この種の問題に対処するために、過去20年間にわたってより優れ、より高速になってきました。世代交代のたびに、より高速なSerDes技術と、より高性能な基盤となる相互接続アーキテクチャを継続的に導入しながら、スループットの大幅な飛躍を達成してきました。
1.6T XDR業界標準コア技術ベースラインパラメータ
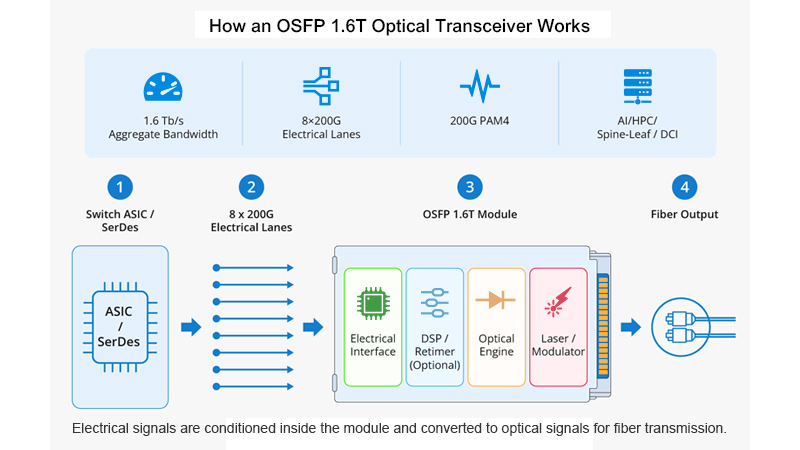
この世代的飛躍の核心は、電気信号を100G SerDesから200Gへ包括的にアップグレードすることにあります。チャネルあたりの帯域幅を倍増させること—高度なDSP技術と改良されたパッケージングアーキテクチャを組み合わせること—により、新世代XDRプラットフォームは、システムの複雑性を大幅に増やすことなく、ネットワーク全体のスループット上限を大幅に引き上げることができます。
1.6T XDR を支える主要な基盤技術
帯域幅を増やすだけでは不十分です。For 1.6Tインターコネクト 真に機能するには、光パッケージング、DSP信号処理、熱管理設計、低レベルスイッチチップなど、いくつもの領域で一緒に進化する必要があります。
フルスタックハードウェアアーキテクチャの詳細分析:1.6T XDR と 800G NDR の比較
高性能AIネットワークを構築するには、スイッチチップを単にアップグレードするだけでは到底不十分です。インターコネクトインフラ全体が、光モジュール、DAC直接接続銅線ケーブル、AOCアクティブ光ケーブル、分岐インターコネクトコンポーネントの協調動作に依存し、異なる伝送距離にわたる厳しい要件を満たす必要があります。
ラック内のGPUからスイッチ相互接続、さらに異なるデータセンターを接続する長距離バックボーンリンクに至るまで、各コンポーネントは高度にスケーラブルなネットワークを支えるうえで不可欠な役割を果たします。
光モジュール製品マトリックス: 800G NDRから1.6T Silicon Photonicsまで
AIデータセンターの中距離および長距離接続では、光モジュールが依然として主流のソリューションです。信号の伝送距離とファイバーの種類に応じて、業界では通常、SR(短距離)マルチモードソリューション、DR(データセンタークラス)シングルモードソリューション、FR(長距離)シングルモードソリューションの3つに分類しています。
データレートが1.6Tに近づくにつれ、シリコンフォトニクス(SiPh)技術はますます重要になっています。光機能をシリコンベースのプラットフォーム上に直接搭載することは、シリコンフォトニクスにとって大きな変革です。多くの利点があります。
より高い統合密度
低消費電力
量産に向けた優れた拡張性
熱管理の柔軟性を向上
これらの特性により、シリコンフォトニクス技術は、将来の1.6Tネットワークの大規模展開における主要な経路の1つとなっています。
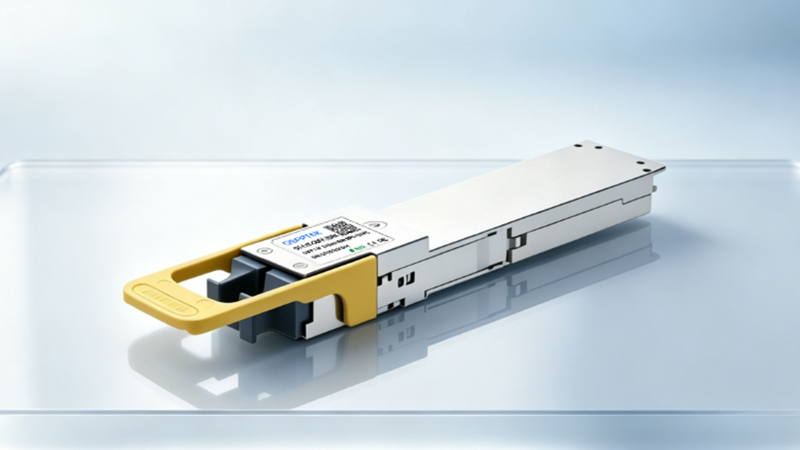
1.6T XDR OSFP DR8 (1310 nmシングルモードシリコンフォトニクスソリューション)
動作波長は 1310 nm で、シングルモードファイバー伝送を使用します。
一般的な伝送距離は最大500メートルです。
デュアルMPOインターフェース設計を採用
8チャネル並列アーキテクチャ、チャネルあたり約200Gのデータレート
代表的な用途:次世代AIスイッチ間のバックボーン相互接続、およびハイパースケールAIクラスター向けファブリックネットワークの展開。
800G NDR OSFPシリーズ
SR8 (850 nm マルチモード): OM3 および OM4 ファイバーを使用して、データセンター内で短距離・高速接続を実現します。
FR8(1310 nmシングルモード):長距離、場合によっては数キロメートルにわたって伝送できるため、建物間やキャンパス間で長距離接続を行うことができます。
400G NDR OSFP / QSFP56 シリーズ
SR4、DR4、FR4などの実証済みアーキテクチャを提供します
HDR ネットワークからの円滑な進化と移行を可能にします
サーバーアクセス側およびアクセスレイヤーネットワークで広く導入されています。
高速ケーブルマトリクス: DACおよびAOCインターコネクトソリューション
これらのケーブルは、主に同じラック内のGPUサーバーとスイッチを接続するために使用されます。一般的な種類には、パッシブ銅線ケーブル (DAC)、アクティブ光ケーブル (AOC)、およびスプリッターケーブル (1-to-2 または 1-to-4) があります。これらのケーブルは、手頃な価格で高密度配線が可能なため、AIクラスター内の短距離接続で人気があります。
パッシブDACダイレクトアタッチ銅線ケーブル(OSFP / QSFP56インターフェース):これらのケーブルには両端に信号処理チップが搭載されておらず、純粋な電気信号伝送のために銅線媒体のみに依存します。そのため、超低消費電力と低コストという利点があります。一般的な長さは主に1メートルと3メートルで、1~3メートルのラック内相互接続専用に設計されています。製品形態には、標準的なストレートケーブル、Y型1対2スプリッター、1対4スプリッターがあり、1つのポートの帯域幅を分割することで、マルチGPUノードをコスト効率よく柔軟に拡張できます。
アクティブAOCケーブル:これらのケーブルは両端に光電変換チップを統合し、中央部分の伝送に光ファイバーを使用することで、銅線ケーブルの物理的な伝送距離の制限を完全に克服します。その中でも、HDR 200G AOCは最大100メートルの伝送距離をサポートし、NDR 400G AOCは数十メートルの距離をカバーできます。主に隣接するラック間の高速クロスラック相互接続に使用されます。
ブレイクアウトケーブル: OSFP to 2×QSFP56やOSFP to 4×OSFPなどの変換仕様に対応し、単一の800Gポートを複数の200G/400Gダウンリンクに分割できます。多様なAIクラスターでの柔軟なネットワーキングに最適で、アイドル状態や無駄なスイッチポートを大幅に削減できます。
3世代にわたるネットワークハードウェアの進化
HDR から NDR、そして現在の XDR へと、関連する技術的飛躍は、単に帯域幅の数値を倍増させることをはるかに超えています。世代が進化するたびに、基盤となる信号変調、DSP アーキテクチャ、光パッケージング設計、および全体的な消費電力はすべて包括的な刷新を遂げてきました。
これら3世代のハードウェアアーキテクチャ間の主な違いは、主にこれらのコア指標に反映されています。
AIスーパーコンピューティングクラスターにおける1.6T XDRネットワークの実用的価値
GPU コンピューティング能力の利用率を大幅に向上
1.6T RDMA と InfiniBand を組み合わせた超低遅延アーキテクチャにより、GPU 間の通信遅延はマイクロ秒範囲まで低減されています。分散型大規模モデル学習では、GPU クラスターの実効計算能力利用率を約 40% から 75%–80% へ直接引き上げることができ、数兆パラメータを持つモデルの学習サイクルを大幅に短縮します。既存の 800G NDR クラスターをアップグレードし、XDR バックボーンネットワークに置き換えた場合、クラスター全体の総合的な学習効率は 40% 超向上すると見込まれます。
ケーブル配線とデータセンターインフラストラクチャのコストを最適化
スイッチポート総数の削減:ポートあたりの帯域幅が2倍になることで、同じ計算能力をサポートしながらスイッチに必要なポート数を50%削減でき、それによってラックスペース、配電負荷、冷却コストを大幅に削減します。
伝送距離の拡張: 1310nmシングルモードDR/FRシリーズモジュールは、500メートルから2キロメートルまでの伝送距離をサポートします。これは、データセンターの物理レイアウトにおいて850nmマルチモードファイバーによって課される距離制約よりも優れています。これにより、インテリジェントコンピューティングセンターでラックを分割し、容量を追加することが容易になります。
優れたフルリンクエネルギー効率:シリコンフォトニクスを次世代3nm DSPソリューションと統合することで、通常のディスクリート部品と比較して、帯域幅1Gbpsあたりのエネルギー使用量を約25%削減します。これにより、10,000枚のカードを使用し、年間を通じて高負荷で稼働するスーパーコンピューティングクラスターの電力コストを大幅に低減できます。
既存のネットワーク資産と互換性あり
XDR 1.6T プロトコルは NDR 800G および HDR 200G と連携します。200G/400G クラスターを完全に再構築する必要はありません。コアスイッチとバックボーン光モジュールを交換するだけで、1.6T へ段階的に移行できます。これにより、初期のアップグレードコストを大幅に削減できます。
一般的なシナリオの選定推奨事項
ビジネスシナリオによって相互接続の要件は異なります。ハードウェアを選ぶ際には通常、信号をどの程度遠くまで届かせる必要があるか、どれだけのケーブル配線が必要か、どれだけの費用をかけたいか、将来的に増設が必要になるかどうかといった点を考慮します。
主流のビジネス環境における実際のニーズに基づき、さまざまなシナリオに推奨されるネットワークハードウェアソリューションは以下のとおりです:
締めくくりに
業界全体の技術トレンドを見ると、シリコンフォトニクスの採用は引き続き加速しています。ネットワーク速度が 800G のしきい値を超えるにつれて、消費電力の削減と集積度の向上におけるシリコンフォトニクスの価値は代替不可能になります。同時に、1.6T ネットワークは先行的な計画から実質的な商用展開へと移行しており、今後数年間で高帯域幅 AI トレーニングの主流となるでしょう。Co-Packaged Optics (CPO) などのより長期的なソリューションについては、R&D への関心は依然として高いままです。現在も予見可能な将来においても、成熟したプラガブル光モジュールが導入分野における圧倒的な主流となるでしょう。
これはまた、1.6Tが現在のAIインフラのアップグレードにおいて、最も明確で実用的な重要ステップであることを意味します。しかし、1.6Tアーキテクチャを真に機能させるには、単にスイッチハードウェアをアップグレードするだけではまったく不十分です。光モジュール、高速ケーブル、ネットワークアーキテクチャを含む相互接続エコシステム全体の連携した取り組みが必要です。
400G、800G、そして新興の 1.6T— をカバーする完全な製品ポートフォリオ(シリコンフォトニクスベースのトランシーバーモジュール、高密度 DAC/AOC ケーブルアセンブリ、AI 向けネットワークソリューション— を含む)を活用し、QSFPTEK は、ユーザーが高い拡張性と高性能を備えたコンピューティングインフラを構築できるよう支援し、既存の NDR アーキテクチャから次世代 1.6T AI Fabric へのより安定したシームレスな移行を確保することに取り組んでいます。


共有
