


シリコンフォトニクス技術がAIネットワークアーキテクチャに与える影響
著者 Leslie
日付 01/26/2026

AIトレーニング規模の継続的な拡大と、データセンター内のネットワークアーキテクチャの大幅な変化に伴い、シリコンフォトニクスモジュールは徐々に主流の選択肢となりつつあります。従来、CPU中心のコンピューティングクラスターでは、ネットワークの安定性と互換性が重視されていました。しかし、GPU中心のAIクラスターでは、高帯域幅、低遅延、継続的なフル負荷運用というネットワークの限界が追求されます。このような状況において、シリコンフォトニクスモジュールは、その独自の利点により、AIアプリケーションで従来型モジュールを上回る優れた性能を発揮できます。
AIワークロードがネットワークをどのように変えているか
AIモデルのトレーニングと従来のビジネストラフィックの最大の違いは、通信パターンの変化にあります。大規模分散トレーニングでは、GPUがパラメータと勾配を頻繁に同期する必要があり、通信トラフィックは主にイーストウェストトラフィックで、次のような典型的な特徴があります:
リンクでは突発的なトラフィックの急増が発生するのではなく、長期間にわたって高負荷が続きます。
通信遅延はトレーニング効率に直接影響します。
ネットワーク性能の不均衡が増幅され、最も遅いリンクが全体の速度を決定します。
単一ポートの速度が400G、800G、さらには1.6Tにまで向上すると、従来の光モジュールアーキテクチャでは、性能を制限する問題が顕在化し始めます。たとえば、消費電力が大幅に増加し、電気信号経路が長くなりすぎるほか、モジュールの一貫性を制御することが難しくなります。これが、AIネットワークにシリコンフォトニクスモジュールが導入されている主な理由の一つです。
シリコンフォトニクスモジュールとは
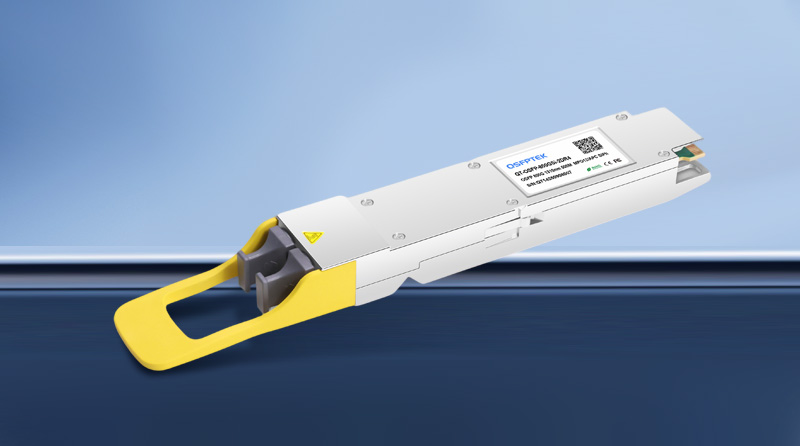
A シリコンフォトニクスモジュール シリコンフォトニクス技術に基づく光通信モジュールであり、従来の光モジュールとは異なります。従来のモジュールは個別の光学部品に依存していますが、シリコンフォトニクスモジュールは変調器、導波路、その他の光学構造をシリコンベースのチップ上に直接統合しており、CMOSプロセスとの高い互換性を備えています。このアーキテクチャは、より高度なレベルで、より高い帯域幅、より低い消費電力、より優れた拡張性を実現し、AIネットワークの需要を満たすことを目的としています。
ただし、シリコンフォトニクスモジュールは、レーザーが完全に存在しないことを意味するわけではありません。ほとんどの製品では、レーザーは依然として外付け部品またはハイブリッド集積部品として存在します。しかし、変調機能と光路制御をシリコンプラットフォーム上に集積することで、システムは集積度、一貫性、製造性を大幅に向上させています。
シリコンフォトニクスモジュールの仕組み
実際の導入環境では、 シリコンフォトニクストランシーバー QSFP-DDやOSFPなどの標準的なプラガブルモジュールであり、インターフェースとケーブル配線方法は基本的に従来のモジュールと同じです。従来のモジュールとの主な違いは、光モジュール自体の内部にあります:
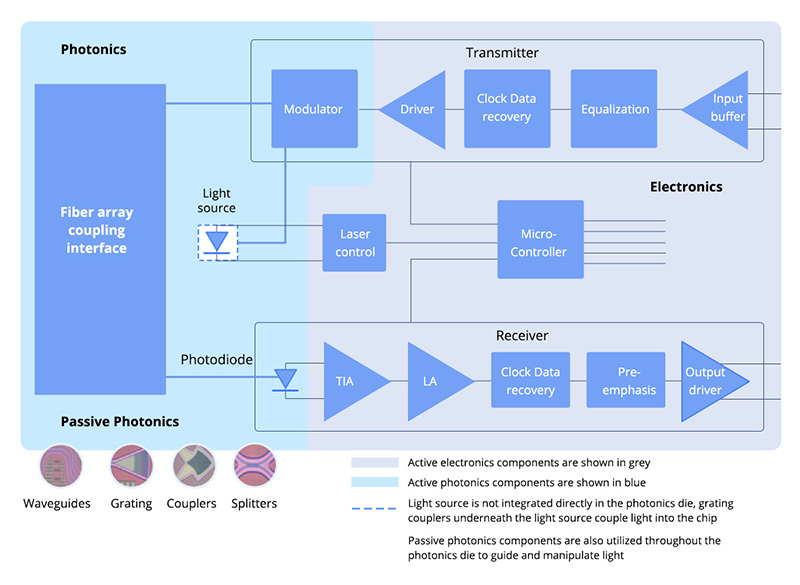
スイッチチップからの高速電気信号は、可能な限り最短の距離でシリコンベースの変調器に入力されます。シリコン導波路内の光信号の位相または振幅を変化させることで、電気信号が光搬送波に効率的にマッピングされます。フォトリソグラフィーを使用して光経路を精密にエッチングするため、モジュール間の信号は高い一貫性を維持します。
モジュール内で処理された後、変調された光信号は標準の光インターフェースを通じて光ファイバーへ出力されます。受信側では、シリコンフォトニクスデバイスが逆の処理を行い、光信号を安定して電気信号に戻し、ホストデバイスで処理できるようにします。
電気信号経路を短縮し、可能な限り早い段階で光学的な前処理を行うこの方法により、シリコンフォトニクスモジュールは高帯域幅環境での損失、クロストーク、消費電力を大幅に削減できます。
シリコンフォトニクスモジュールがAIシナリオに適している理由
まず、帯域幅密度はAIデータセンターにおけるネットワーク規模の上限を直接決定しており、これはAIネットワークが無視できない現実です。
ポートあたりのデータレートが増加する際、モジュールのサイズ、消費電力、放熱要件も比例して増加すると、最終的に機器を物理的に拡張できなくなり、ネットワーク規模が制限されます。シリコンフォトニクスモジュールは、レーンあたり100Gまたは200Gなど、より高速な電気インターフェース速度に対応しているため、同じ容積でより高い実効帯域幅を実現できます。これは、同じ数のスイッチングデバイスでより多くのGPUを接続できることを意味します。また、スパイン・リーフアーキテクチャでは、階層数や過剰集約による複雑さを軽減でき、さらに柔軟な拡張性も得られます。
次に、消費電力と放熱も、AIクラスターのネットワーク規模と運用コストに影響を与える重要な要素です。
AIクラスターでは光モジュールの大規模展開が必要なため、ポート数が数万以上に達すると、光モジュール全体の消費電力と放熱負荷がデータセンターの運用とコストに直接影響します。
シリコンフォトニクスモジュールは、電気信号経路を短縮し、集積度を高めることで、ビット当たりのエネルギー消費を効果的に削減します。単一のモジュールでは依然として消費電力が比較的高いものの、同じ帯域幅条件では、従来のモジュールよりも消費電力と発熱量が少なく、長期運用にも有利です。総コストを抑えたいユーザーにとっては、多くの場合、調達コストよりも運用コストの方が重要です。
最後に、シリコンフォトニクスモジュールは大量生産と長期的な進化にもより適しています。従来のモジュールとは異なり、シリコンフォトニクスモジュールは機能をシリコンベースのチップ上に統合し、フォトリソグラフィを用いて直接製造されるため、従来のモジュールよりも高い生産能力を実現します。成熟した半導体製造システムを活用することで、シリコンフォトニクスモジュールは製品の一貫性、拡張性、サプライチェーンの安定性において大きな優位性を持ち、これは長期的に進化する AI ネットワークにとって特に重要です。
AIネットワークにおけるシリコンフォトニクスモジュールの用途
シリコンフォトニクスモジュールだけがAIネットワークにおける唯一の正解ではありません。低~中速、短距離、またはコストが極めて重視される用途では、従来型モジュールにも依然としていくつかの利点があります。ただし、以下のシナリオでは、シリコンフォトニクスモジュールがより理想的な選択肢となります。
大規模GPUクラスター:大規模GPUクラスターでは、シリコンフォトニクスモジュールは一貫した製品性能を確保するだけでなく、個々のエッジモジュールの性能によって生じるネットワーク全体の性能低下も軽減します。
電力消費に敏感なネットワーク:電力消費に敏感なネットワークでは、シリコンフォトニクスモジュールによって全体的な消費電力と放熱を効果的に削減し、総運用コストと冷却設備への投資を抑えることができます。
1.6Tへの進化に向けたネットワーク計画:シリコンフォトニクスモジュールは、チャネルあたりの高速化を実現できます。将来的にネットワークを1.6Tへアップグレードする計画がある場合、シリコンフォトニクスモジュールは間違いなく理想的な選択肢です。シリコンフォトニクスは、CPOなどの次世代インターコネクトアーキテクチャにとっても重要な技術基盤です。
結論
シリコンフォトニクスモジュールの開発は、市場にある既存のすべてのモジュールを置き換えることではなく、高速かつ大規模な環境下でAIネットワークが直面する課題への対応を目的としています。帯域幅密度、消費電力制御、一貫性において優れた性能を備えるシリコンフォトニクスモジュールは、AIデータセンターネットワークの重要な構成要素になりつつあります。AIインフラストラクチャを計画または導入している場合、単に速度だけに注目するよりも、シリコンフォトニクスモジュールの実用的な価値を理解することのほうが重要です。


共有
