


1.6T XDR의 잠금 해제: 차세대 AI 슈퍼컴퓨팅의 새로운 초석
작성자 Moore
날짜 08/28/2026

대규모 AI 학습과 수조 개의 매개변수를 가진 모델이 표준이 되면서, AI 인프라의 성능 병목 현상은 순수 컴퓨팅 성능에서 네트워크 상호 연결성으로 이동하고 있습니다— GPU가 빠른 속도로 발전하고 있지만, 분산 학습으로 생성되는 막대한 동서 트래픽은 그보다 더 빠르게 증가하고 있습니다. 그 결과 네트워크 대역폭, 지연 시간 및 확장성이 전체 클러스터의 전반적인 컴퓨팅 활용률을 결정하는 핵심 요소가 되었습니다.
네트워크 기술은 HDR 200G에서 NDR 400G 및 800G로 발전했으며, 오늘날 차세대 진화의 윤곽은 이미 상당히 명확합니다. 단일 채널 200G 신호 기술을 기반으로 구축된 1.6T 인터커넥트 아키텍처가 중심 무대에 오르고 있습니다. 실리콘 포토닉스, 첨단 DSP 및 고밀도 광 인터커넥트 기술을 결합한 1.6T InfiniBand XDR은 미래 AI 슈퍼컴퓨팅 클러스터를 지원하는 데 핵심적인 역할을 할 준비가 되어 있습니다.
AI 클러스터가 800G NDR에서 1.6T XDR로 네트워크의 진화를 주도하다
Hyperscale AI Clusters가 직면한 네트워크 과제
오늘날’ 분산 AI 학습에는 수천 개 또는 심지어 수만 개의 GPU가 함께 작동해야 하는 경우가 많습니다. 대규모 매개변수 동기화, 그래디언트 집계 및 빈번한 클러스터 간 통신은 데이터 센터 내에서 막대한 양의 동서 방향 네트워크 트래픽을 생성합니다.
클러스터 규모가 계속 확장됨에 따라 기존 HDR 및 NDR 네트워크는 주로 다음 영역에서 병목 현상을 보이기 시작했습니다:
대역폭 제약: 대규모 GPU 어레이의 고속 통신 요구에 직면하여, 400G 링크는 이미 따라가기 어려운 상황이며, 이로 인해 컴퓨팅 리소스가 유휴 상태가 되고 전체 활용률이 낮아질 수 있습니다.
전송 거리 제한: 기존 멀티모드 SR 광 솔루션은 커버리지 거리가 비교적 짧아, 하이퍼스케일 데이터 센터의 랙 배치 및 공간 계획 유연성을 직접적으로 제한합니다.
전력 소비와 신호 무결성의 이중 과제: 처리량을 높이기 위해 전기 신호 속도를 증가시키면 전력 소비가 급격히 증가하고 열 관리에 상당한 부담을 주며, 비트 오류율(BER) 제어에도 심각한 과제를 제기합니다.
InfiniBand 네트워크는 이러한 종류의 문제를 해결하기 위해 지난 20년 동안 더 우수하고 더 빨라져 왔습니다. 각 세대 전환마다 처리량에서 큰 도약을 달성하는 동시에 더 빠른 SerDes 기술과 더 높은 성능의 기본 인터커넥트 아키텍처를 지속적으로 도입했습니다.
1.6T XDR 업계 표준 핵심 기술 기준 매개변수
이 세대 도약의 핵심은 100G SerDes에서 200G로 전기 신호를 전면적으로 업그레이드하는 데 있습니다. 채널당 대역폭을 두 배로 늘리고—고급 DSP 기술 및 개선된 패키징 아키텍처와 결합함으로써—차세대 XDR 플랫폼은 시스템 복잡성을 크게 증가시키지 않고도 전체 네트워크 처리량 한계를 크게 높일 수 있습니다.
1.6T XDR을 지원하는 핵심 기반 기술
대역폭을 늘리는 것만으로는 충분하지 않습니다. For 1.6T 상호 연결 제대로 작동하려면 광 패키징, DSP 신호 처리, 열 관리 설계, 저수준 스위치 칩 등 여러 영역에서 함께 발전해야 합니다.
풀스택 하드웨어 아키텍처 심층 분석: 1.6T XDR vs. 800G NDR
고성능 AI 네트워크를 구축하려면 스위치 칩 업그레이드만으로는 턱없이 부족합니다. 전체 상호 연결 인프라는 다양한 전송 거리에서의 엄격한 요구 사항을 충족하기 위해 광 모듈, DAC 직접 연결 구리 케이블, AOC 액티브 광 케이블 및 분기 상호 연결 구성 요소의 조율된 작동에 의존해야 합니다.
랙 내부의 GPU부터 스위치 상호 연결, 그리고 서로 다른 데이터 센터를 연결하는 장거리 백본 링크에 이르기까지, 각 구성 요소는 확장성이 뛰어난 네트워크를 지원하는 데 필수적인 역할을 합니다.
광 모듈 제품 매트릭스: 800G NDR부터 1.6T Silicon Photonics까지
AI 데이터 센터의 중거리 및 장거리 연결에서는 광 모듈이 여전히 가장 많이 선택되는 솔루션입니다. 신호가 이동해야 하는 거리와 광섬유 유형에 따라 업계에서는 일반적으로 이를 세 가지 범주로 분류합니다. SR(단거리) 멀티모드 솔루션, DR(데이터 센터급) 싱글모드 솔루션, FR(장거리) 싱글모드 솔루션입니다.
데이터 전송률이 1.6T에 가까워짐에 따라 실리콘 포토닉스(SiPh) 기술은 점점 더 중요해지고 있습니다. 광학 기능을 실리콘 기반 플랫폼에 바로 통합하는 것은 실리콘 포토닉스에 있어 완전히 판도를 바꾸는 일입니다. 많은 장점을 갖추고 있습니다.
더 높은 통합 밀도
낮은 전력 소비
대량 생산을 위한 향상된 확장성
열 관리를 위한 더 높은 유연성
이러한 특성 덕분에 실리콘 포토닉스 기술은 향후 1.6T 네트워크의 대규모 구축을 위한 주요 경로 중 하나가 되었습니다.
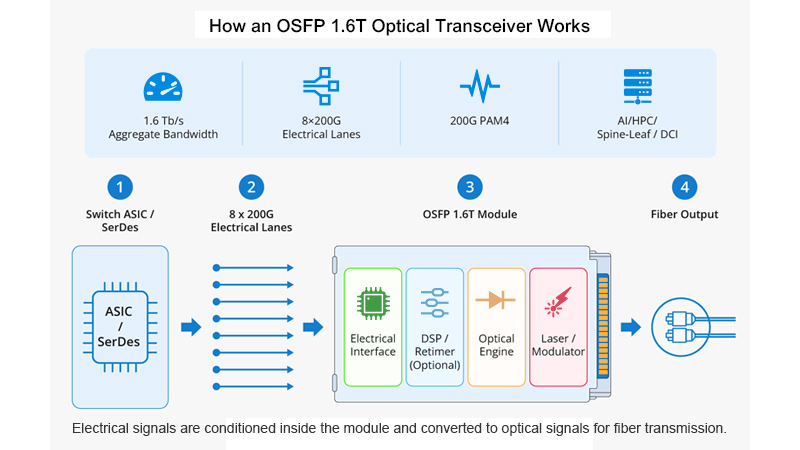
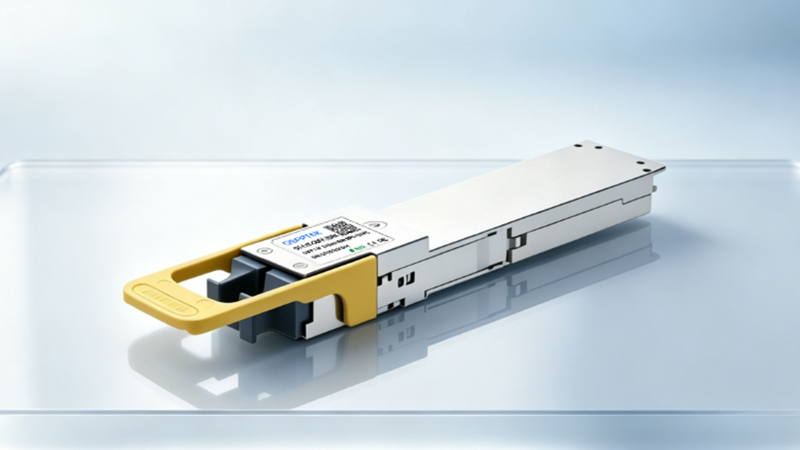
1.6T XDR OSFP DR8 (1310 nm 단일 모드 실리콘 포토닉스 솔루션)
작동 파장은 1310 nm이며, 단일 모드 광섬유 전송을 사용합니다.
일반적인 전송 거리는 최대 500미터입니다.
듀얼 MPO 인터페이스 설계 적용
채널당 약 200G의 데이터 속도를 제공하는 8채널 병렬 아키텍처
일반적인 애플리케이션: 차세대 AI 스위치 간 백본 상호 연결 및 하이퍼스케일 AI 클러스터용 패브릭 네트워크 배포.
800G NDR OSFP 시리즈
SR8 (850 nm 멀티모드): 데이터 센터 내부에서 단거리 고속 연결을 위해 OM3 및 OM4 파이버를 사용합니다.
FR8 (1310 nm single-mode): 장거리, 심지어 수 킬로미터까지 전송할 수 있어 건물과 캠퍼스 간 장거리 연결을 구성할 수 있습니다.
400G NDR OSFP / QSFP56 시리즈
SR4, DR4, FR4와 같은 검증된 아키텍처 제공
HDR 네트워크에서 원활한 발전과 전환을 지원합니다
서버 액세스 측 및 액세스 계층 네트워크에 널리 배포됩니다.
고속 케이블 매트릭스: DAC 및 AOC 인터커넥트 솔루션
이 케이블은 주로 같은 랙 내에서 GPU 서버와 스위치를 연결하는 데 사용됩니다. 일반적인 유형으로는 패시브 구리 케이블(DAC), 액티브 광 케이블(AOC), 스플리터 케이블(1-to-2 또는 1-to-4)이 있습니다. 이 케이블은 저렴하고 고밀도 케이블링이 가능하기 때문에 AI 클러스터의 단거리 연결에 널리 사용됩니다.
패시브 DAC 다이렉트 어태치 구리 케이블 (OSFP / QSFP56 인터페이스): 이 케이블은 양쪽 끝에 신호 처리 칩이 없으며 순수한 전기 신호 전송을 위해 전적으로 구리 매체에 의존하므로, 초저전력 소비와 저비용이라는 장점을 제공합니다. 일반적인 길이는 주로 1미터와 3미터이며, 1~3미터 범위의 캐비닛 내부 상호 연결용으로 특별히 설계되었습니다. 제품 형태에는 표준 직결 케이블, Y형 1-to-2 스플리터, 1-to-4 스플리터가 포함되며, 단일 포트의 대역폭을 분할하여 멀티 GPU 노드를 비용 효율적이고 유연하게 확장할 수 있습니다.
액티브 AOC 케이블: 이 케이블은 양 끝단에 광전 변환 칩을 통합하고 중간 구간에는 광섬유를 사용하여 전송함으로써 구리 케이블의 물리적 전송 거리 제한을 완전히 극복합니다. 그중 HDR 200G AOC는 최대 100미터의 전송 거리를 지원하며, NDR 400G AOC는 수십 미터의 거리를 커버할 수 있습니다. 주로 인접 캐비닛 간 고속 랙 간 상호 연결에 사용됩니다.
브레이크아웃 케이블: OSFP to 2×QSFP56 또는 OSFP to 4×OSFP와 같은 변환 사양을 지원하여 단일 800G 포트를 여러 200G/400G 다운링크로 분할할 수 있습니다. 다양한 AI 클러스터에서 유연한 네트워킹에 완벽하며 유휴 및 낭비되는 스위치 포트를 크게 줄일 수 있습니다.
3세대에 걸친 네트워크 하드웨어의 진화
HDR에서 NDR로, 그리고 이제 XDR로 이어지는 기술적 도약은 단순히 대역폭 수치를 두 배로 늘리는 것을 훨씬 넘어섭니다. 각 세대의 진화와 함께 기본 신호 변조, DSP 아키텍처, 광 패키징 설계 및 전체 전력 소비가 모두 포괄적으로 개편되었습니다.
이 세 세대의 하드웨어 아키텍처 간 주요 차이점은 주로 이러한 핵심 지표에 반영됩니다.
AI 슈퍼컴퓨팅 클러스터에서 1.6T XDR 네트워크의 실용적 가치
GPU 컴퓨팅 성능 활용도를 크게 향상
1.6T RDMA와 InfiniBand를 결합한 초저지연 아키텍처 덕분에 GPU 간 통신 지연 시간이 마이크로초 범위로 줄어들었습니다. 분산형 대형 모델 학습에서 GPU 클러스터의 유효 컴퓨팅 성능 활용률은 약 40%에서 75%–80%로 직접 상승할 수 있어, 수조 개의 파라미터를 가진 모델의 학습 주기를 크게 단축합니다. 기존 800G NDR 클러스터를 XDR 백본 네트워크로 업그레이드하고 교체하면 전체 클러스터의 전반적인 학습 효율이 40% 이상 증가할 것으로 예상됩니다.
케이블링 및 데이터 센터 인프라 비용 최적화
총 스위치 포트 수 감소: 포트당 대역폭이 두 배가 되면 동일한 컴퓨팅 용량을 지원하면서 스위치에 필요한 포트 수가 50% 감소하여 랙 공간, 전력 분배 부하 및 냉각 비용을 크게 줄입니다.
확장된 전송 거리: 1310nm 단일 모드 DR/FR 시리즈 모듈은 500미터에서 2킬로미터에 이르는 전송 거리를 지원합니다. 이는 데이터 센터 물리적 배치에서 850nm 다중 모드 광섬유가 부과하는 거리 제약보다 우수합니다. 이를 통해 지능형 컴퓨팅 센터에서 랙을 분할하고 용량을 추가하기가 더 쉬워집니다.
탁월한 전체 링크 에너지 효율: 실리콘 포토닉스와 차세대 3nm DSP 솔루션을 통합하여 일반 디스크리트 부품 대비 대역폭 Gbps당 에너지 사용량을 약 25% 줄입니다. 이는 10,000개의 카드를 사용하고 연중 높은 부하를 유지하는 슈퍼컴퓨팅 클러스터의 전기 비용을 크게 낮춰줍니다.
기존 네트워크 자산과 호환
XDR 1.6T 프로토콜은 NDR 800G 및 HDR 200G와 함께 작동합니다. 200G/400G 클러스터를 완전히 재구축할 필요가 없습니다. 코어 스위치와 백본 광 모듈만 교체하면 1.6T로 점진적으로 전환할 수 있습니다. 이렇게 하면 초기 업그레이드 비용을 크게 줄일 수 있습니다.
일반적인 시나리오에 대한 선택 권장 사항
비즈니스 시나리오마다 상호 연결 요구 사항이 다릅니다. 하드웨어를 선택할 때는 일반적으로 신호가 이동해야 하는 거리, 필요한 케이블링 양, 지출하려는 비용, 향후 추가 확장이 필요한지 여부 같은 사항을 고려합니다.
주요 비즈니스 환경의 실제 요구 사항을 기반으로, 다양한 시나리오에 권장되는 네트워크 하드웨어 솔루션은 다음과 같이 요약됩니다:
마무리하며
업계의 전반적인 기술 동향을 살펴보면, 실리콘 포토닉스의 도입은 계속 가속화되고 있습니다. 네트워크 속도가 800G 임계점을 넘어서면서 전력 소비를 줄이고 집적도를 높이는 실리콘 포토닉스의 가치는 대체 불가능해지고 있습니다; 동시에 1.6T 네트워크는 미래 지향적 계획 단계에서 본격적인 상용 구축 단계로 나아가고 있으며, 향후 수년간 고대역폭 AI 학습의 주축이 될 것입니다. 공동 패키징 광학 (CPO)과 같은 장기적인 솔루션의 경우, R&D에 대한 열기는 여전히 높습니다. 현재와 예측 가능한 미래 모두에서, 성숙한 플러거블 광 모듈은 구축 분야의 확고한 주류로 자리할 것입니다.
이는 또한 1.6T가 현재 AI 인프라 업그레이드에서 가장 명확하고 실용적인 핵심 단계임을 의미합니다. 그러나 1.6T 아키텍처를 실제로 작동하게 하려면 스위치 하드웨어를 단순히 업그레이드하는 것만으로는 충분하지 않으며, 광 모듈, 고속 케이블, 네트워크 아키텍처를 아우르는 전체 상호 연결 생태계의 조율된 노력이 필요합니다.
400G, 800G 및 새롭게 부상하는 1.6T—실리콘 포토닉스 기반 트랜시버 모듈, 고밀도 DAC/AOC 케이블 어셈블리, AI 중심 네트워크 솔루션을 포함하는 완전한 제품 포트폴리오를 활용하여— QSFPTEK은 사용자가 확장성이 뛰어나고 고성능인 컴퓨팅 인프라를 구축하도록 지원하고, 기존 NDR 아키텍처에서 차세대 1.6T AI Fabric으로 보다 안정적이고 원활하게 전환할 수 있도록 보장하는 데 전념하고 있습니다.


공유
