


InfiniBand XDR이란 무엇이며 AI 네트워크에서 중요한 이유
작성자 Leslie
날짜 06/18/2026

InfiniBand XDR은 AI 학습 클러스터의 규모가 지속적으로 확장되고 GPU 간 데이터 교환이 급속히 증가함에 따라 도입된 중요한 솔루션입니다. 수만 개의 GPU를 갖춘 대규모 학습 플랫폼에서 네트워크는 더 이상 단순한 보조 시스템이 아니라 학습 효율에 영향을 미치는 핵심 인프라입니다. 이러한 배경에서 더 높은 대역폭을 향한 InfiniBand 기술의 지속적인 진화는 하나의 추세가 되었으며, InfiniBand XDR은 바로 AI 네트워크 요구사항의 다음 단계를 해결하는 기술입니다.
InfiniBand XDR이란 무엇인가
InfiniBand XDR은 NVIDIA가 주도하는 InfiniBand 기술 로드맵의 최신 속도 등급으로, 주로 차세대 AI 컴퓨팅 플랫폼과 고성능 컴퓨팅 환경을 대상으로 합니다. 이전 세대 NDR의 400Gbps 포트 속도와 비교해 XDR은 단일 포트 대역폭을 800Gbps로 높여 네트워크 용량을 크게 증가시킵니다.
기술적 관점에서 XDR은 InfiniBand의 핵심 장점인 낮은 지연 시간, 높은 처리량 및 RDMA를 이어가면서, 차세대 고속 SerDes, 스위칭 칩 및 광 상호 연결 기술을 결합하여 초대규모 GPU 클러스터에 더 강력한 네트워크 지원 기능을 제공합니다.
간단히 말해, XDR은 단순히 속도를 두 배로 높이는 것만이 아니라, AI 클러스터의 향후 확장 요구를 충족하도록 설계된 차세대 상호 연결 플랫폼입니다.
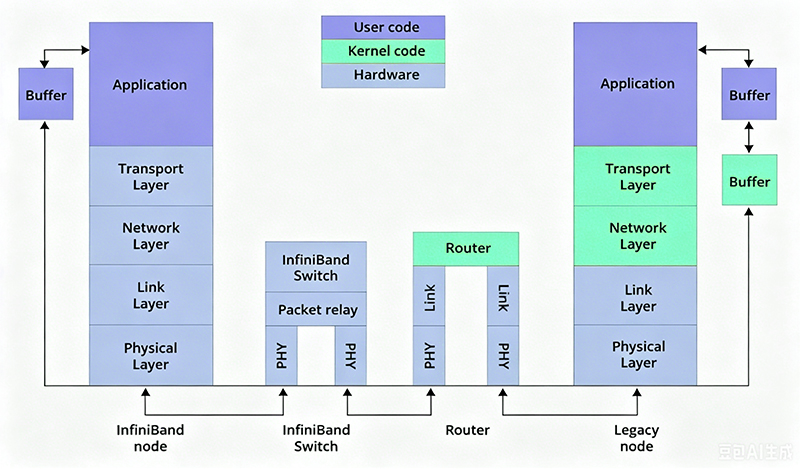
AI 학습에는 왜 800G 또는 1.6T 네트워크가 필요한가
기존 기업 네트워크에서 대부분의 트래픽은 사용자가 서버에 액세스하면서 생성되는 남북 트래픽입니다. AI 학습 환경은 완전히 다릅니다. 핵심 트래픽은 주로 서버 간, 즉 동서 트래픽에서 발생합니다.
대규모 모델 학습 중에는 수많은 GPU가 그래디언트, 모델 파라미터 및 중간 계산 결과를 빈번하게 교환해야 합니다. 예를 들어, 분산 학습에서 흔히 사용되는 All-Reduce 작업은 상당한 노드 간 통신 요구 사항을 발생시킵니다.
모델 크기가 수십억 개의 파라미터에서 수천억 개 또는 심지어 수조 개의 파라미터로 커짐에 따라 네트워크 통신량도 증가합니다. 네트워크가 데이터를 적시에 동기화할 수 없으면 GPU는 데이터 전송이 완료될 때까지 기다릴 수밖에 없으며, 그 결과 전체 활용률이 낮아집니다.
따라서 현대 AI 클러스터에서는 네트워크 성능이 GPU 성능만큼 중요합니다.
InfiniBand XDR이 AI 클러스터 효율성을 향상시키는 방법
첫째, 대역폭이 증가했습니다. A 1.6T XDR 링크는 동일한 시간 내에 더 많은 학습 데이터를 전송할 수 있어 분산 학습에서 동기화 지연 시간을 줄이고 GPU 활용률을 향상시킵니다.
둘째, 확장성이 더 뛰어납니다. AI 클러스터가 성장함에 따라 스위치 포트 수와 네트워크 계층 수도 증가합니다. 포트 속도가 높을수록 동일한 대역폭을 달성하는 데 더 적은 링크를 사용할 수 있어 네트워크 아키텍처 설계를 간소화할 수 있습니다.
또한 더 큰 대역폭은 핫스팟 트래픽과 혼잡 문제를 완화합니다. 수천 개의 GPU 노드가 동시에 데이터를 교환할 때 네트워크는 더 충분한 전송 리소스를 제공하여 성능 변동을 줄일 수 있습니다.
대규모 언어 모델, 멀티모달 모델 및 과학 컴퓨팅 작업의 학습에서 이러한 장점은 곧바로 더 높은 학습 효율로 이어집니다.
InfiniBand XDR 및 Ethernet AI 네트워크
최근 몇 년 동안 RoCEv2 기반 Ethernet 솔루션은 빠르게 발전했으며, AI 데이터 센터 시장에서 400G 및 800G Ethernet이 널리 채택되었습니다. 그러나 InfiniBand는 여전히 초대규모 훈련 시나리오에서 상당한 이점을 보유하고 있습니다.
첫째, InfiniBand는 처음부터 고성능 컴퓨팅 환경을 위해 설계되었으며, RDMA 메커니즘, 혼잡 제어 및 집계 통신 기능은 오랜 기간에 걸쳐 검증되었습니다.
둘째, NVIDIA는 Quantum 스위치, ConnectX 네트워크 카드, CUDA 소프트웨어 스택을 포함한 완전한 InfiniBand 생태계를 구축했습니다. 이러한 구성 요소들은 함께 작동하여 AI 훈련 성능을 최적화합니다.
최고의 성능과 최소한의 통신 지연 시간을 추구하는 AI 플랫폼의 경우, InfiniBand는 여전히 많은 슈퍼컴퓨팅 센터와 대규모 AI 학습 클러스터에서 선호되는 솔루션입니다.
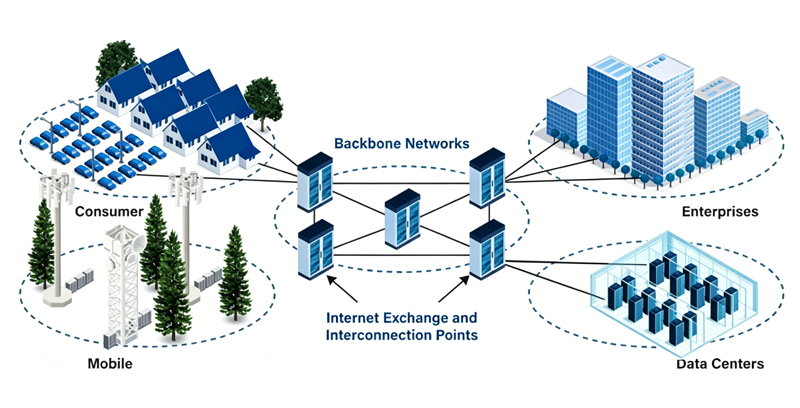
InfiniBand XDR, 고속 광 인터커넥트 업그레이드를 촉진
XDR 네트워크가 점진적으로 구축됨에 따라 데이터 센터 광 상호 연결 아키텍처도 그에 맞춰 업그레이드될 것입니다. 800Gbps 링크에는 더 높은 성능의 스위치와 광 모듈이 필요합니다. 현재 이용 가능한 고속 광 모듈, 예를 들면 800G OSFP, 800G OSFP SR8, 800G DR8, 및 800G 2x FR4는 XDR networks 구축에서 점차 중요한 구성 요소가 되고 있습니다.
동시에 광섬유 케이블링, 랙 설계 및 냉각 시스템도 더 높은 밀도와 더 높은 대역폭의 배포 요구 사항에 맞게 조정되어야 합니다. 향후 몇 년 동안 AI 데이터 센터의 네트워크 업그레이드는 800G 상호 연결 생태계를 중심으로 크게 전개될 것으로 예상됩니다.
결론
AI 모델 크기가 계속 커짐에 따라 네트워크는 학습 효율성을 결정하는 중요한 요소가 되었습니다. 최신 세대의 InfiniBand 기술인 XDR은 800G 및 1.6T 대역폭, 저지연 아키텍처, 뛰어난 확장성을 통해 미래의 하이퍼스케일 GPU 클러스터를 위한 더욱 효율적인 상호 연결 플랫폼을 제공합니다. AI 인프라의 지속적인 발전 속에서 XDR은 차세대 지능형 컴퓨팅 센터의 발전을 이끄는 핵심 기술 중 하나가 될 것으로 예상됩니다.


공유
