


Evolusi Seni Bina Pengkomputeran AI: Skala Menegak berbanding Skala Mendatar serta Pemilihan Modul Optik
Pengarang Moore
Tarikh 04/02/2026

Apabila model berskala besar mencapai trilion parameter dan saiz kluster AI menghampiri ratusan ribu GPU, infrastruktur pengkomputeran asas sedang mengalami peralihan seni bina yang ketara. Dua model rangkaian arus perdana untuk pengkomputeran AI—Scale-Up dan Scale-Out—sedang berkembang mengikut laluan teknikal yang berbeza, tetapi dalam amalan, kedua-duanya beransur-ansur bertumpu pada titik-titik utama.
Perubahan ini pada asasnya merupakan hasil pertimbangan berulang antara "kependaman rendah dan kebolehskalaan tinggi" dengan "kebolehpercayaan tinggi dan kawalan kos." Pada masa yang sama, evolusi berterusan teknologi modul optik (seperti LPO, NPO dan CPO) semakin membentuk reka bentuk sistem.
Penskalaan Menegak berbanding Penskalaan Mendatar: Perbezaan dan Pertukaran Antara Dua Laluan
Dalam reka bentuk kluster pengkomputeran AI, Scale-Up dan Scale-Out mempunyai matlamat yang berbeza sejak awal, dan kriteria penilaiannya tidak diselaraskan pada dimensi yang sama. Kedua-duanya boleh difahami sebagai dua pendekatan yang berbeza.
Penskalaan Menegak: Seni Bina Gandingan Rapat yang Menekankan Kependaman Rendah dan Konsistensi Kukuh
Penskalaan keluar lebih hampir kepada peluasan kuasa pengkomputeran satu nod; pada asasnya, ia berkaitan dengan "integrasi mendatar" dalam seni bina GPU sedia ada. Dengan membina unit pengkomputeran yang sangat berganding rapat, memori setempat berbilang GPU diabstrakkan ke dalam ruang logik bersatu, membolehkan teras pengkomputeran mengalami HBM hampir setempat apabila mengakses memori jauh. Pendekatan semantik hampir memori ini bukan sahaja bertujuan memperluas skala, tetapi juga meminimumkan jarak antara pengiraan dan data, mengurangkan kependaman kepada kurang daripada mikrosaat sambil mengekalkan ketekalan dan kestabilan yang tinggi.
Scale-Out: Model Pengkomputeran Teragih Berorientasikan Kebolehskalaan
Sebaliknya, Scale-Out lebih menyerupai proses menggabungkan kuasa pengkomputeran yang tersebar dengan menyusun sejumlah besar nod menjadi satu keseluruhan yang bersepadu melalui rangkaian. Pelaksanaan lazim adalah berdasarkan seni bina Clos dua atau tiga lapisan, yang menghubungkan puluhan ribu atau lebih GPU kepada kluster latihan yang sama untuk menyokong paralelisme data, paralelisme saluran paip dan mod latihan lain. Pendekatan ini memberi tumpuan kepada kebolehskalaan dan kawalan kos, memastikan sistem sentiasa tersedia dan boleh berkembang untuk memenuhi keperluan anda sambil berfungsi dengan perkakasan dan perisian semasa anda.
Secara umum, Scale-Up adalah tentang meningkatkan "keupayaan individu" untuk mencapai prestasi terbaik dan kependaman rendah. Sebaliknya, Scale-Out pula berkaitan dengan "kecekapan penskalaan," yang membolehkan kluster berskala besar berjalan dengan lancar. Yang pertama memfokuskan unit teras dalam pengkomputeran berprestasi tinggi, manakala yang kedua membentuk rangkaian asas untuk latihan dan inferens berskala besar. Kedua-dua mod ini sering wujud bersama dan saling melengkapi dalam infrastruktur AI dunia sebenar.
Evolusi Semasa: Perubahan Seni Bina Scale-Up dan Trend Penyederhanaan Scale-Out
Dalam beberapa tahun kebelakangan ini, Scale-Up dan Scale-Out telah berkembang dengan pesat, dan pengeluar terkemuka telah mengetahui cara melaksanakannya secara praktikal. Matlamatnya adalah untuk meningkatkan prestasi sambil memudahkan kerumitan.
Penskalaan Menegak: Daripada Berasaskan Casis kepada Kewujudan Bersama Pelbagai Bentuk, Saling Sambung 224G Menjadi Nod Utama
Penyelesaian awal untuk perniagaan yang berkembang kebanyakannya tertumpu pada "SuperNode casis", yang menghimpunkan sumber pengkomputeran ke dalam satu sistem dan menyambungkannya melalui pautan berkelajuan tinggi. Penyelesaian ini menekankan kestabilan dan konsistensi, biasanya menggunakan gabungan "backplane kabel + pensuisan L1/L2": sambungan antara komponen dalam casis bergantung terutamanya pada sambungan elektrik untuk memastikan ketumpatan lebar jalur yang tinggi; pengembangan merentas casis bergantung pada sambungan optik.
Saling sambung optik 224G secara beransur-ansur menjadi pilihan arus perdana untuk senario scale-up. Dari perspektif model kos, harga modul optik 1.6T berkemungkinan kekal kira-kira 1.2 hingga 1.4 kali ganda berbanding 800G dalam tempoh tiga hingga lima tahun akan datang. Perbezaan ini agak mudah untuk ditangani, sama ada berdasarkan seni bina LPO atau DSP tradisional. Namun, penggunaan teknologi 112G selalunya bermakna penggunaan lebih banyak gentian untuk lebar jalur yang sama, yang akhirnya meningkatkan kos. Apabila faktor seperti lebar jalur, penggunaan kuasa dan kerumitan pengkabelan dipertimbangkan, penyelesaian 224G adalah lebih baik dalam jangka panjang.
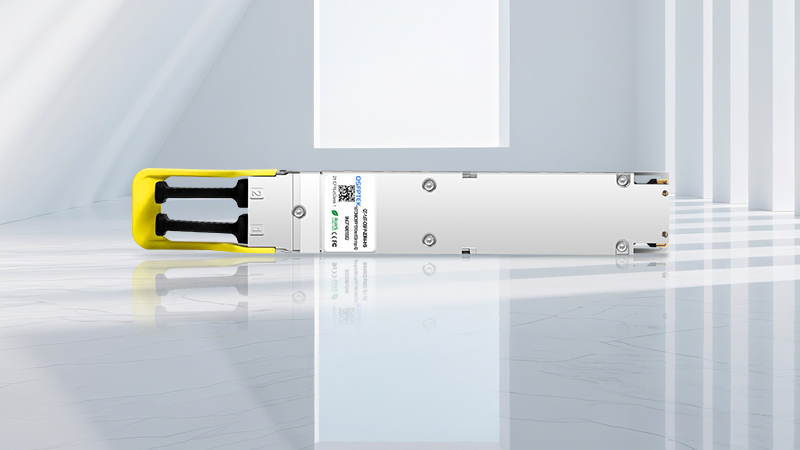
Modul Optik QSFPTEK 1.6T
Industri ini telah mengikuti trend ini dan mula membangunkan produk berkaitan, seperti modul siri OSFP QSFPTEK yang menyokong kadar 1.6T (contohnya, spesifikasi 2×DR4 dan 2×FR4). Produk ini terutamanya bertujuan memenuhi keperluan lebar jalur tinggi dan kependaman rendah bagi seni bina supernod masa hadapan. Produk ini juga menyediakan pusat data untuk langkah seterusnya dalam perkembangannya.
Scale-Out: Daripada Tiga Lapisan kepada Dua Lapisan, Struktur Rangkaian Beransur-ansur Menjadi Lebih Rata
Perubahan ketara dalam seni bina scale-out ialah penekanan yang semakin meningkat terhadap pemudahan dalam reka bentuk keseluruhan. Rangkaian Clos tiga lapisan yang sebelum ini biasa digunakan secara beransur-ansur digantikan dengan seni bina Clos dua lapisan. Dengan mengurangkan bilangan lapisan perantaraan, laluan rangkaian menjadi lebih langsung, sekali gus mengurangkan kerumitan sistem. Di bawah reka bentuk ini, kelompok latihan yang menyasarkan ratusan ribu GPU pun boleh mengekalkan kebolehskalaan yang tinggi sambil memastikan kos rangkaian terkawal.
Perubahan ini sebahagian besarnya disebabkan oleh peningkatan keupayaan cip pensuisan. Apabila saiz port terus bertambah, contohnya, dengan Radix mencapai 512 port, rangkaian Clos dua lapisan boleh menyokong secara langsung skala nod melebihi 100,000, dan dalam sesetengah model reka bentuk, malah merangkumi sekitar 130,000 kad pemecut, tanpa memerlukan lapisan pensuisan teras tambahan. Ini bermakna kelompok AI yang besar boleh mengekalkan kepadatan lebar jalur sambil mengekalkan topologi rangkaian yang lebih jelas semasa penskalaan.
Rangkaian Berbilang Satah: Mengurangkan Tekanan Lebar Jalur Melalui Reka Bentuk Berbilang Satah
Berdasarkan asas ini, sesetengah pengeluar telah mula meneroka kaedah baharu untuk mengatur rangkaian. Sebagai contoh, seni bina Multi-Plane yang dicadangkan dalam penyelidikan berkaitan ialah pendekatan yang lazim. Dalam skim ini, AI-NIC mengakses satah rangkaian Clos yang berbeza secara serentak melalui beberapa port berkelajuan tinggi; contohnya, ia menggunakan empat antara muka 200G untuk menyambung kepada empat satah rangkaian bebas, dan di pihak penghantaran, ia mengagihkan aliran data yang sama merentasi satah tersebut menggunakan kaedah round-robin.
Pada hujung penerima, mekanisme pemprosesan data yang menyokong penulisan luar susunan memasang semula data daripada laluan yang berbeza, supaya satu pautan tidak menjadi kesesakan. Pendekatan ini meningkatkan penggunaan lebar jalur pada satu GPU dalam senario Scale-Out, dengan mencapai kadar penggunaan keseluruhan melebihi 95% dalam sesetengah model ujian.
Dari perspektif trend, fokus Scale-Out bukan sekadar meningkatkan skala, tetapi mencapai keseimbangan yang lebih munasabah antara jalur lebar, kecekapan dan kos dalam kluster AI berskala amat besar melalui pengoptimuman struktur dan inovasi reka bentuk rangkaian.
Trend Pemilihan Modul Optik: LPO/NPO Semakin Popular, CPO Beransur-ansur Menurun
Dalam kedua-dua seni bina Scale-Up dan Scale-Out, modul optik bukan sahaja merupakan medium sambungan, malah turut mempengaruhi kependaman, penggunaan kuasa dan kestabilan pautan secara langsung. Oleh itu, pendekatan teknologi yang berbeza semakin menunjukkan perbezaan dalam pemilihan faktor bentuk modul optik. Perbezaan antara penyelesaian LPO, NPO dan tradisional yang didayakan DSP semakin jelas, manakala populariti CPO agak menurun.
Penskalaan Menegak: Penyelesaian Kependaman Lebih Rendah Mengutamakan LPO/NPO
Dalam senario apabila sistem ditingkatkan, matlamatnya adalah untuk mengurangkan kependaman dan penggunaan kuasa. Hal ini menjadikan penyelesaian LPO atau NPO tanpa DSP lebih popular. Modul optik ini memudahkan laluan pemprosesan isyarat, sekali gus mengurangkan jumlah kuasa yang digunakan dengan ketara. Sebagai contoh, sebuah Modul 800G dengan penyelesaian LPO menggunakan kira-kira 6W, iaitu peningkatan ketara berbanding produk tradisional yang dilengkapi DSP yang biasanya menggunakan sekitar 15W.
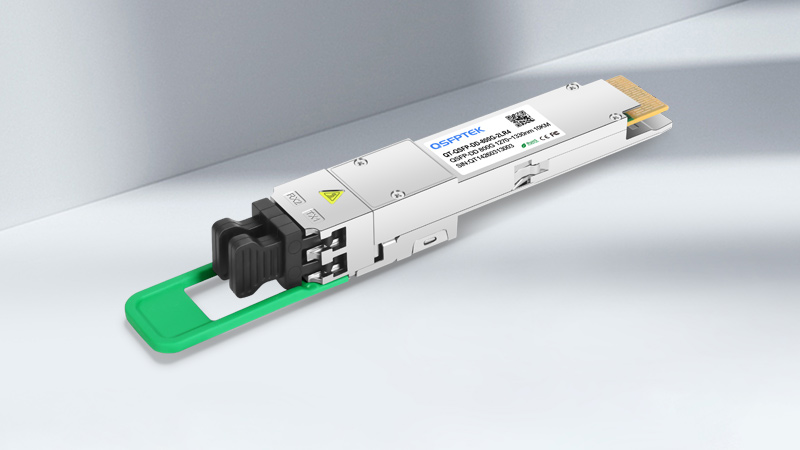
Modul Optik 800G QSFPTEK
Pada masa yang sama, pengurangan penglibatan DSP dalam pemprosesan data turut mengurangkan kependaman pautan. Kependaman sehala boleh dipendekkan sebanyak puluhan nanosaat, dengan pengurangan yang lebih ketara dalam kependaman pergi balik. Ciri-ciri ini menjadikannya lebih sesuai dengan keperluan penskalaan "jarak pendek, konsistensi tinggi", dan sesetengah produk LPO yang dioptimumkan untuk pusat data AI direka berdasarkan metrik ini.
Skala Keluar: Seni Bina DSP Masih Menjadi Pilihan Arus Perdana
Namun, dalam persekitaran yang sistemnya diskalakan secara mendatar, situasinya berbeza sama sekali. Modul optik dengan pemproses isyarat digital (DSP) lebih baik dalam mengendalikan sambungan rangkaian yang besar dan jarak penghantaran yang jauh. Atas sebab ini, modul tersebut kekal sebagai pilihan utama.
Di satu pihak, dari segi kawalan ralat, DSP boleh menyokong mekanisme pembetulan ralat hadapan yang lebih kompleks, membolehkan pautan mencapai kadar ralat yang lebih rendah selepas pembetulan, sekali gus menjadikannya sesuai untuk senario penghantaran jarak jauh. Sebaliknya, modul LPO/NPO mempunyai keupayaan yang agak terhad dalam hal ini dan sering gagal memenuhi keperluan kestabilan untuk pautan merentas pusat data atau pautan pada tahap 10 km.
Sebaliknya, kelompok berskala besar biasanya melibatkan penggunaan campuran peralatan daripada berbilang vendor, sekali gus meletakkan tuntutan yang lebih tinggi terhadap kesalingoperasian. Modul optik DSP berasaskan protokol standard (seperti IEEE 802.3) lebih matang dari segi keserasian antara vendor, manakala piawaian LPO/NPO masih berkembang dan ekosistemnya belum disatukan sepenuhnya.
Secara keseluruhan, kedua-dua laluan teknikal ini telah menjadi jelas: Scale-Up biasanya menggunakan LPO/NPO untuk mencapai kependaman dan penggunaan kuasa yang lebih rendah. Scale-Out terus bergantung pada seni bina DSP untuk memastikan penghantaran jarak jauh dan keserasian sistem. Walaupun kaedah pelaksanaannya berbeza, kedua-duanya berkongsi matlamat yang sama dalam evolusi lebar jalur—bergerak ke arah kelajuan saluran tunggal 224G.
Cabaran Sebenar Integrasi dan Pelaksanaan: Peluang dan Had Wujud Bersama
Apabila kebolehpercayaan tinggi scale-up dan kebolehskalaan berskala besar scale-out mula bertemu, hala tuju "rangkaian tertumpu" kelihatan semula jadi. Walau bagaimanapun, masih terdapat beberapa halangan yang tidak dapat dielakkan antara percubaan dan penggunaan berskala besar.
Perbezaan Seni Bina: Kesukaran Menyatukan Semantik Memori dan Semantik Mesej
Kedua-dua sistem beroperasi pada tahap yang berbeza. Scale-Up adalah seperti "semantik memori", iaitu cara GPU mengakses sumber jauh. Ini membolehkan semua peranti berkomunikasi antara satu sama lain dengan pantas. Sebaliknya, Scale-Out dibina berdasarkan "semantik mesej", menggunakan mekanisme seperti RDMA untuk menghantar dan menerima data. Pada asasnya, ia ialah model komunikasi eksplisit. Perbezaan utama dalam cara mereka mereka bentuk dan membina sistem bermakna penyepaduan kedua-duanya lebih rumit daripada sekadar memastikan semua peranti dapat berkomunikasi antara satu sama lain.
Laluan Kebolehpercayaan yang Tidak Konsisten: Cara Memperkenalkan Pautan yang Stabil
Bagi memastikan reka bentuk yang boleh dipercayai, Scale-Up biasanya menggunakan "backplane kabel + struktur pensuisan" untuk mengurangkan risiko kegagalan pautan dan mengekalkan laluan kritikal dalam julat kestabilan tinggi. Sebaliknya, sistem Scale-Out biasanya menggunakan modul optik untuk interkoneksi. Untuk mencapai penggabungan, sebahagian trafik Scale-Out perlu dialihkan ke pautan Scale-Up yang sangat boleh dipercayai, yang memerlukan pembinaan semula topologi rangkaian sedia ada. Bagi kelompok yang mempunyai puluhan ribu atau bahkan ratusan ribu kad, pelarasan sedemikian sememangnya merupakan projek kejuruteraan yang kompleks.
Kerjasama Rentas Vendor: Piawaian dan Ekosistem Kekal Berpecah-pecah
Rangkaian terkonvergens bukan sekadar isu seni bina; ia juga melibatkan kerjasama industri. Penjajaran piawaian yang lebih rapat diperlukan antara cip pensuisan, GPU dan modul optik. Sebagai contoh, penyelesaian berkaitan LPO masih bergantung pada pemurnian spesifikasi bersatu untuk kesalingoperasian merentas vendor. Pada masa yang sama, struktur pensuisan berasaskan memori perlu menyesuaikan diri dengan pelaksanaan antara muka daripada vendor GPU yang berbeza. Pada masa ini, vendor terkemuka memberi tumpuan terutamanya kepada ekosistem mereka sendiri, dan protokol serta laluan pelaksanaan belum diseragamkan sepenuhnya, yang sedikit sebanyak telah memperlahankan kadar penumpuan.
Berkaitan dengan isu-isu ini, beberapa persoalan utama mula timbul: Adakah LPO berpeluang mencapai kejayaan dalam kebolehoperasian dan menjadi penyelesaian sambungan optik yang lebih universal? Bolehkah semantik memori dan semantik mesej disepadukan pada peringkat perisian untuk membolehkan sistem mencapai kependaman rendah dan kebolehskalaan tinggi?
Yang pasti, persaingan untuk infrastruktur pengkomputeran telah memasuki tahap yang lebih mendalam. Setiap pelarasan terhadap teknologi modul optik, struktur rangkaian dan kaedah kerjasama industri akan mempengaruhi hasilnya. Daripada sekadar memilih antara dua laluan, arah yang lebih realistik mungkin adalah membolehkan sistem yang berbeza beroperasi secara kolaboratif dalam infrastruktur yang sama. Selaras dengan trend ini, idea yang serupa dengan "Scale-Across" juga telah dicadangkan sebagai bentuk peralihan yang menghubungkan kedua-dua mod tersebut.


Kongsi
