


Menuju ke Seni Bina Rubin: Lonjakan Rangkaian Pusat Data AI daripada 800G kepada 1.6T
Pengarang Leslie
Tarikh 04/02/2026

Platform GPU Rubin generasi seterusnya NVIDIA sedang mendorong perubahan asas dalam reka bentuk infrastruktur AI. Apabila beban kerja AI berkembang daripada berbilion parameter kepada trilion parameter, cabarannya jauh melangkaui prestasi pengkomputeran. Perkara yang benar-benar menentukan kecekapan sistem selalunya ialah keupayaan untuk memindahkan data dengan cekap antara ribuan GPU. Dalam konteks ini, rangkaian bukan lagi sekadar lapisan sokongan, tetapi komponen teras yang menentukan prestasi AI. Sistem ini sememangnya direka bentuk untuk keselarian besar-besaran, dengan komunikasi berterusan dan intensif antara nod, sekali gus membentuk semula logik reka bentuk pusat data.
Apakah Seni Bina Rubin
Seni bina Rubin NVIDIA merupakan peningkatan daripada seni bina Blackwell. Ia ialah platform pengkomputeran kolaboratif tindanan penuh yang direka khusus untuk latihan model AI berskala amat besar dan inferens kependaman rendah. Terdiri daripada berbilang cip baharu, ia menawarkan prestasi dan kecekapan tenaga yang lebih tinggi, menyokong operasi tugas AI berskala besar yang cekap serta berfungsi sebagai infrastruktur teras yang memacu pembangunan AI berskala besar.
Tidak seperti GPU terdahulu yang fokus utamanya adalah meningkatkan prestasi cip tunggal, Rubin direka bentuk sejak awal untuk sistem AI teragih berskala besar. Matlamat utamanya adalah untuk mencapai latihan yang cekap pada kelompok yang mengandungi berpuluh-puluh ribu GPU.
Dalam persekitaran ini, GPU perlu bertukar-tukar kecerunan, parameter dan data perantaraan secara berterusan. Beban komunikasi adalah amat berat, dan kecekapan penghantaran data memberi kesan langsung terhadap kelajuan latihan. Walaupun teknologi seperti InfiniBand dan RDMA dapat mengurangkan kependaman serta meningkatkan daya pemprosesan, teknologi tersebut masih bergantung pada lebar jalur yang mencukupi pada lapisan fizikal.
Peranan 800G dalam Infrastruktur AI
Saling sambungan 800G secara beransur-ansur telah menjadi standard de facto untuk infrastruktur AI berprestasi tinggi. Berbanding penyelesaian 400G, 800G mencapai lebar jalur dua kali ganda sambil mengekalkan keseimbangan yang munasabah antara penggunaan kuasa dan kerumitan penggunaan pada peringkat ini.
Dalam pelaksanaan sebenar, Penyelesaian 800G menunjukkan pembahagian tugas yang jelas berdasarkan senario aplikasi:
DAC digunakan untuk sambungan jarak ultra pendek antara GPU dan suis ToR dalam rak pelayan. Pengkabelan kuprum hampir tidak menambah penggunaan kuasa dan mempunyai kependaman penghantaran yang paling rendah, menjadikannya medium pilihan untuk sambungan antara komponen berketumpatan tinggi dalam rak pelayan.
AOC sesuai untuk sambungan jarak pendek hingga sederhana antara rak pelayan. AOC mengintegrasikan modul optik dan kabel, memudahkan proses penggunaan di tapak sambil memastikan integriti isyarat dan mengurangkan keperluan pembersihan serta penyelenggaraan antara muka gentian optik.
Modul optik digunakan dalam lapisan teras tulang belakang rangkaian berstruktur, menyokong sambungan antara rangkaian jarak jauh dalam seni bina Spine-Leaf. Modul optik, bersama-sama dengan sistem pengkabelan gentian optik, membolehkan pengembangan rangkaian merentasi POD dan wilayah.
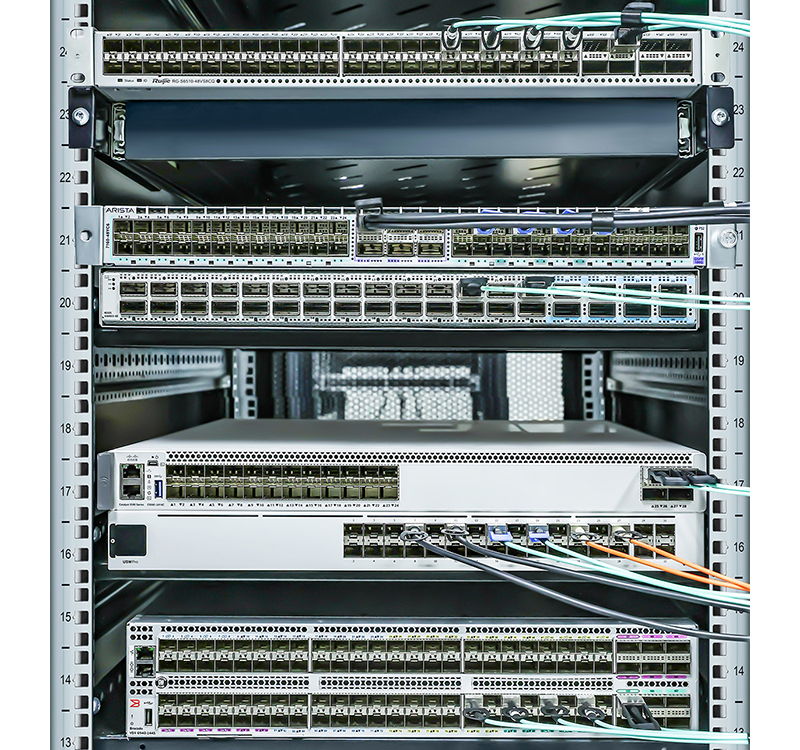
Pendekatan penggunaan berlapis ini mencerminkan keperluan kejuruteraan sebenar bagi kluster AI berskala besar. Dengan mengambil QSFPTEK sebagai contoh, rangkaian produk 800Gnya merangkumi keseluruhan rangkaian DAC, AOC dan modul optik. Nilai terasnya terletak pada memastikan pengguna memperoleh prestasi keserasian yang konsisten dalam seni bina rangkaian tiga lapisan. Dalam persekitaran kluster AI berketumpatan tinggi dan daya pemprosesan tinggi, kesalingoperasian yang stabil merentas senario selalunya lebih bermakna daripada satu penunjuk prestasi tunggal.
Had 800G dalam Era Rubin
Walaupun penyelesaian 800G telah terbukti berkesan dalam kelompok AI semasa, batasannya semakin jelas apabila berdepan dengan ketumpatan pengkomputeran generasi seterusnya yang diwakili oleh seni bina NVIDIA Rubin.
Sumber tekanan utama ialah tiga aspek berikut:
Ketumpatan GPU yang Meningkat Mendadak: Bilangan GPU setiap rak sedang berubah daripada 8 yang kini menjadi arus perdana kepada 16 atau 32, dan permintaan lebar jalur terkumpul dalam rak melonjak daripada tahap Tbps kepada puluhan Tbps, sekali gus memberikan cabaran besar kepada nisbah penumpuan port suis ToR.
Pengembangan Saiz Kluster: Nod kluster berkembang daripada ribuan kepada puluhan ribu atau bahkan ratusan ribu nod, dan corak kesesakan rangkaian berkembang daripada titik panas setempat kepada kesesakan yang diedarkan secara global. Meningkatkan bilangan pautan semata-mata akan membawa kepada peningkatan superlinear dalam kerumitan pemasangan kabel, penggunaan kuasa dan kos penyelenggaraan;
Evolusi Mod Komunikasi: Strategi keselarian model baharu, yang diwakili oleh Keselarian Pakar (MoE), meningkatkan kekerapan penyegerakan antara GPU dengan ketara berbanding seni bina Transformer tradisional, dan memerlukan sistem rangkaian memenuhi keperluan gabungan lebar jalur tinggi serta kependaman rendah secara serentak.
Dari perspektif hubungan padanan antara pengkomputeran dan rangkaian, daya pemprosesan pengkomputeran kad tunggal platform Rubin dijangka lebih daripada dua kali ganda berbanding seni bina Blackwell. Jika lebar jalur rangkaian kekal tidak berubah, kadar masa melahu sumber pengkomputeran yang menunggu data akan meningkat dengan ketara, sekali gus mengehadkan penggunaan berkesan kuasa pengkomputeran GPU secara langsung.
Mengapa Modul 1.6T Diperlukan
Kemajuan interkoneksi 1.6T sebahagian besarnya didorong oleh permintaan tegar terhadap lebar jalur rangkaian daripada seni bina GPU generasi seterusnya. Kepentingannya bukan sahaja terletak pada penggandaan kelajuan port, tetapi juga pada penyediaan laluan teknikal yang berdaya maju untuk menangani kesesakan struktur yang dinyatakan di atas.
Nilai teras 1.6T ditunjukkan dalam dimensi berikut:
Ketumpatan Jalur Lebar yang Dipertingkatkan: Satu port menyediakan daya pemprosesan data sebanyak 200GB/s. Sebagai contoh, suis 48 port boleh menyediakan lebar jalur agregat hampir 10Tbps, sekali gus mengurangkan bilangan port dan ruang rak yang digunakan kira-kira separuh berbanding penyelesaian 800G;
Topologi Dipermudah: Pada saiz kelompok yang sama, 1.6T menyokong topologi rangkaian yang lebih rata, seperti memudahkan seni bina Clos tiga peringkat kepada seni bina dua peringkat, mengurangkan bilangan peranti lapisan Spine, dan pada masa yang sama mengurangkan pengumpulan kependaman yang disebabkan oleh pemajuan merentas lapisan.
Kerumitan Operasi yang Dikurangkan: Pengurangan bilangan pautan secara langsung membawa kepada penurunan serentak dalam bilangan teras gentian, modul optik dan titik kerosakan. Dalam kelompok berskala besar, kesan ini boleh diterjemahkan kepada peningkatan yang ketara dalam kecekapan operasi.
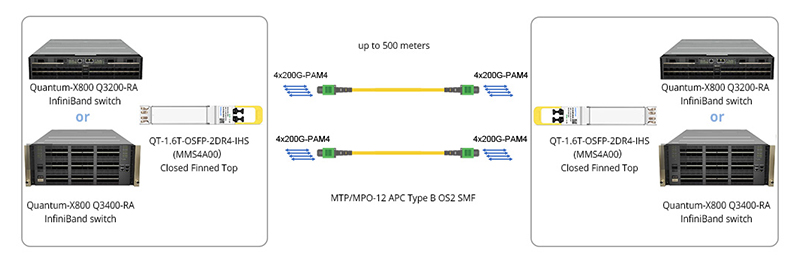
QSFPTEK telah mula melaksanakan teknologi dalam barisan produk 1.6T, dengan menawarkan beberapa modul 1.6T untuk pusat data AI. Ini bermakna mereka boleh merancang secara proaktif bagi integrasi rangkaian generasi seterusnya pada infrastruktur 800G sedia ada, dan bukannya menghadapi tekanan peningkatan reaktif semasa penggunaan penuh seni bina Rubin.
Laluan Naik Taraf Sebenar yang Disyorkan
Evolusi daripada 800G kepada 1.6T dalam persekitaran pusat data dunia sebenar biasanya mengikuti laluan beransur-ansur, bukannya penggantian lengkap secara sekali gus.
Anda boleh merujuk kepada laluan naik taraf berikut:
Lapisan Akses dan Saling Sambungan Jarak Pendek: Teruskan menggunakan penyelesaian DAC dan AOC 800G. Kelebihan kabel kuprum dan kabel optik aktif dari segi penggunaan kuasa dan kos masih sukar digantikan dalam jangka pendek untuk senario jarak pendek dalam dan antara rak;
Lapisan Spine dan Teras Backbone: Perkenalkan modul optik dan suis 1.6T terlebih dahulu untuk membawa trafik terkumpul merentasi POD, sambil memperuntukkan margin lebar jalur yang mencukupi untuk lapisan teras bagi menampung keperluan pengembangan pada masa hadapan;
Peralihan Seni Bina Hibrid: Mencapai operasi hibrid peralatan 800G dan 1.6T melalui mekanisme pengagregatan pautan atau rundingan kadar, melengkapkan penggantian generasi secara beransur-ansur daripada lapisan akses hingga lapisan teras, serta mengelakkan perbelanjaan modal sekali gus dan risiko gangguan perkhidmatan.
Bagi pusat data yang telah menggunakan infrastruktur 800G, tempoh peralihan yang lancar selama 2-3 tahun biasanya diterapkan. Dalam tempoh ini, adalah perlu untuk memberi perhatian secara serentak kepada keserasian ke belakang modul optik, kapasiti rizab sistem pengkabelan dan keupayaan penyelarasan berbilang kadar sistem pengendalian rangkaian.
Kesimpulan
Peralihan daripada modul optik 800G kepada 1.6T adalah penting untuk menyokong seni bina Rubin NVIDIA’s. 1.6T memberikan ketumpatan lebar jalur yang lebih tinggi, struktur rangkaian yang lebih ringkas dan kependaman yang lebih rendah bagi memenuhi keperluan pusat data generasi akan datang. Dengan pendekatan naik taraf berperingkat, pengguna boleh beralih infrastruktur mereka dengan lancar sambil memanfaatkan sepenuhnya penyelesaian optik QSFPTEK’s 1.6T untuk ketersambungan kluster yang stabil dan berprestasi tinggi.


Kongsi
