


Grandes cargas de trabalho de IA estão chegando: o que está mudando na infraestrutura dos data centers?
Autor Moore
Data 09/18/2026

À medida que as cargas de trabalho de IA se expandem entre servidores e racks, o desempenho final de todo o sistema depende cada vez mais da operação coordenada de elementos como capacidade computacional, rede, armazenamento, fornecimento de energia e refrigeração. Embora os parâmetros de pico no papel sejam importantes, eles já não representam plenamente a taxa de transferência efetiva, a escalabilidade ou os custos operacionais gerais de um cluster.
Isso obriga todos a ampliar a perspectiva para o nível do rack e de todo o cluster ao planejar e avaliar a infraestrutura de IA. Essa mudança de mentalidade está reformulando o projeto, a expansão e a implantação das arquiteturas subjacentes dos data centers, tornando o planejamento abrangente, a verificação em nível de sistema e a prontidão para implantação mais cruciais do que nunca. Este artigo examinará essas mudanças e os desafios práticos que elas trazem para a infraestrutura de IA em larga escala.
Transformação da infraestrutura de data centers impulsionada por IA
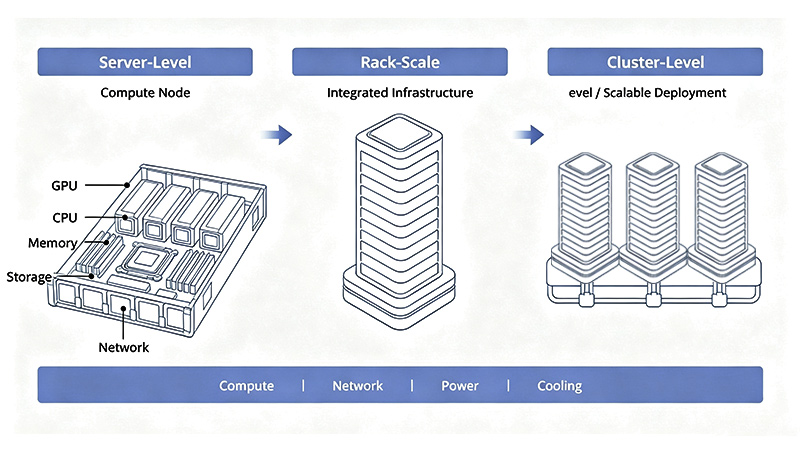
Para treinamento distribuído ou inferência em larga escala, os aceleradores precisam trocar dados constantemente. Isso torna a interconexão de rede, o acesso ao armazenamento, a alimentação elétrica e os recursos de resfriamento extremamente críticos para a estabilidade de todo o sistema. Por isso, o planejamento atual da infraestrutura há muito deixou de se limitar à implantação de servidores individuais, abrangendo racks de alta densidade e até clusters com vários racks. Embora os servidores continuem sendo os nós computacionais mais básicos, racks e clusters estão se tornando unidades de projeto arquitetônico cada vez mais centrais.
O GB300 NVL72 da NVIDIA é um excelente exemplo dessa abordagem em "nível de rack". Na arquitetura de referência empresarial da NVIDIA, um rack GB300 NVL72 refrigerado a líquido é tratado como uma unidade de expansão independente padrão, integrando 18 bandejas de computação e 72 GPUs. Para criar um conjunto computacional maior, várias dessas unidades em nível de rack podem ser conectadas e expandidas horizontalmente por meio de redes dedicadas de computação, redes convergentes e redes de gerenciamento.
Essa arquitetura não pode ser aproveitada com eficiência simplesmente reunindo vários servidores de alto desempenho. Para permitir comunicação rápida entre nós e facilitar a expansão futura, o cabeamento de rede, as interconexões, a distribuição de energia e as soluções de refrigeração líquida precisam ser integrados ao projeto geral da infraestrutura desde o início.
Os racks de servidores de alta densidade não só impõem enormes exigências à fonte de alimentação e aos recursos de refrigeração líquida do data center, como o enorme tráfego leste-oeste entre GPUs e servidores também representa um desafio maior para a largura de banda, a topologia e a escalabilidade da rede.
Portanto, ao planejar clusters de computação atualmente, as questões centrais já não são simples:
Desempenho da capacidade computacional de IA: apenas atualizar o hardware não é suficiente
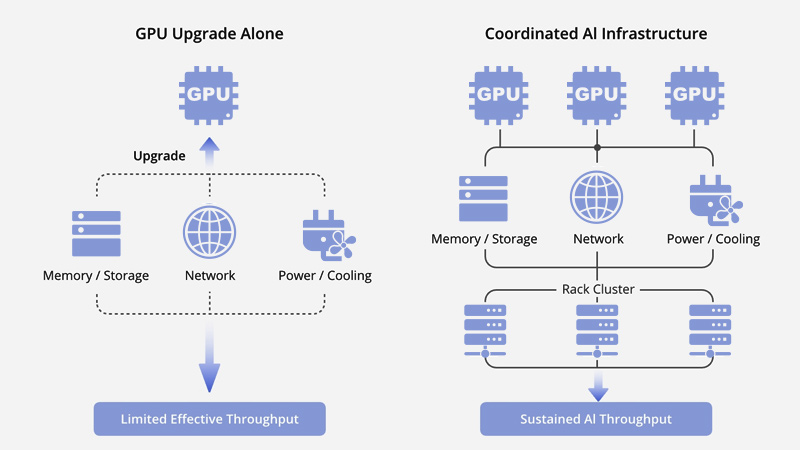
Adicionar hardware de maior desempenho pode, de fato, melhorar os sistemas de IA, mas o quanto esse valor se concretiza depende de a infraestrutura subjacente conseguir realmente converter as capacidades teóricas desses dispositivos em resultados efetivos durante as operações comerciais.
Eficiência do caminho de dados
A capacidade de processamento do armazenamento, a largura de banda da memória, juntamente com o pré-processamento de dados e os canais de entrada, determinam em conjunto se o acelerador consegue receber dados a tempo. Se a transmissão de dados for um pouco lenta, o tentador poder computacional teórico da GPU será desperdiçado. Além disso, o desempenho do armazenamento afeta diretamente a criação de checkpoints do modelo, a recuperação de falhas, a recuperação de recursos e o processamento de dados intermediários. Portanto, o padrão para medir essa capacidade não é focar nos parâmetros de um único disco rígido ou módulo de memória, mas avaliar se todo o caminho de dados consegue atender à carga de trabalho real do negócio.
Benefícios reais da comunicação em rede
A largura de banda anunciada pelos fabricantes para placas de rede e switches geralmente representam apenas a capacidade física disponível e não equivalem à velocidade real alcançada durante a execução de aplicativos. Da topologia da rede, sobrecapacidade e congestionamento da rede até links ópticos, cabeamento, configuração de software e até mesmo o desempenho do próprio terminal, tudo afeta a taxa real de utilização da rede pelo cluster de computação. Muitas vezes, mesmo que interfaces mais rápidas sejam usadas para aumentar o limite de comunicação, a melhoria de desempenho no lado do aplicativo pode não ser proporcional.
O efeito de escala da expansão do cluster
Adicionar GPUs pode, de fato, aumentar o poder computacional total, mas o desempenho do negócio não necessariamente aumentará na mesma proporção. A sobrecarga adicional da sincronização de nós, do agendamento de tarefas, da colaboração entre máquinas e da comunicação consumirá gradualmente os benefícios do hardware recém-adicionado.
Portanto, ao projetar a infraestrutura, os parâmetros de pico certamente são um indicador importante, mas devem ser considerados de forma abrangente em conjunto com a taxa real de utilização do acelerador, a taxa de transferência efetiva, a eficiência de expansão e o tempo final de conclusão da tarefa.
À medida que a infraestrutura de IA cresce: vários desafios pela frente
Expandir a infraestrutura de IA não é apenas um desafio técnico, mas também exige um cálculo empresarial cuidadoso. As empresas precisam considerar não apenas quanta capacidade adicional podem agregar, mas também quanto tempo levará para que esse poder computacional seja efetivamente implantado e quão eficiente será sua conversão.
Os limites da infraestrutura física
Ao chegar ao nível de rack e cluster, a expansão da rede não se resume a aumentar a velocidade. É preciso replanejar a densidade de portas, a localização dos switches, o cabeamento, a distância de transmissão dos módulos ópticos, os modelos de tráfego e as proporções de superdimensionamento. Uma rede que funciona bem em implantações de pequena escala pode exigir uma reformulação completa da arquitetura à medida que o cluster cresce.
A alimentação elétrica e o resfriamento também impõem limitações severas. A energia insuficiente ou o resfriamento inadequado não apenas limitarão a densidade dos racks e reduzirão o número de placas aceleradoras instaladas, mas também retardarão o processo de expansão. A capacidade de resfriamento insuficiente também pode fazer com que as máquinas sofram redução de frequência ou limitações operacionais sob cargas elevadas.
Por isso, implantações entre racks costumam ter consequências de longo alcance, exigindo ajustes na topologia de rede, na arquitetura de armazenamento, no fornecimento e na distribuição de energia, no resfriamento e até nos processos posteriores de acesso e gerenciamento de serviços. Como aumentar a capacidade sem causar custos de integração desequilibrados ou degradação do desempenho é um grande desafio.
Investimento de capital e cronograma de implementação
A escala do investimento vai muito além de GPUs e servidores. Rede, armazenamento, racks, interconexões ópticas de comunicação, vários cabos, além de infraestrutura de alimentação e refrigeração, reformas de data centers e ferramentas de manutenção—cada item representa uma despesa significativa.
Além disso, da aquisição até a implantação efetiva do poder computacional, há várias etapas: preparação do data center, cabeamento dos racks, configuração do software, testes de interoperabilidade, validação do negócio e entrega final. Qualquer gargalo em qualquer uma dessas etapas atrasará a entrega e a disponibilidade de todo o cluster.
Ansiedade com a utilização de equipamentos e a atualização tecnológica
O valor de um cluster de IA não pode ser medido apenas por seu poder computacional. A utilização dos equipamentos, o consumo de energia, a manutenção diária, os custos de gerenciamento e as máquinas subutilizadas contribuem para o aumento dos custos operacionais gerais.
O ritmo acelerado de iteração do hardware, com mudanças rápidas em aceleradores, redes, consumo de energia por ponto único e tecnologia de refrigeração líquida, está constantemente encurtando o ciclo de vida do planejamento de infraestrutura. As empresas precisam equilibrar suas necessidades atuais de capacidade computacional com os possíveis riscos de escalabilidade futura e dificuldades de modificação.
Interoperabilidade entre vários fornecedores
A infraestrutura de IA normalmente consiste em um conjunto de equipamentos de vários fornecedores. Placas de rede, switches, módulos ópticos, cabos, servidores e uma ampla variedade de firmware e software exigem verificação rigorosa de compatibilidade antes de serem implantados em produção.
Para minimizar os riscos de integração e solução de problemas, as especificações devem ser definidas antecipadamente, as combinações certificadas devem ser testadas e as responsabilidades de suporte de cada parte devem ser esclarecidas.
Em última análise, trata-se de um jogo empresarial abrangente: encontrar o equilíbrio ideal entre investimento de capital, disponibilidade de capacidade computacional, utilização dos equipamentos, custos operacionais diários e flexibilidade da arquitetura a longo prazo.
Infraestrutura de IA em Grande Escala: Planejamento e Validação
Os requisitos de infraestrutura para a IA moderna estão aumentando. Muito mais do que selecionar componentes individuais orienta a escolha do hardware; ela precisa ser considerada de forma holística no contexto da arquitetura completa do sistema e da carga de trabalho.
Planejamento global
Poder computacional, rede, armazenamento, além de alimentação e refrigeração—esses componentes essenciais devem ser planejados de forma integrada, com base nas necessidades do seu negócio, na escala de implantação, na densidade dos racks e nos planos de expansão futura.
Especificamente, a topologia da rede, a adequação das distâncias de transmissão dos módulos ópticos, as rotas de cabeamento, a distribuição de energia, os métodos de resfriamento, o acesso ao armazenamento, o layout físico do data center e os planos de expansão futura— devem estar claramente definidos com antecedência. Isso evita muitos transtornos e retrabalho extremamente caro devido à incompatibilidade de dispositivos durante a implantação.
Validação em nível de sistema
Apenas analisar as especificações de hardware no papel não é suficiente para determinar a usabilidade de uma infraestrutura de IA. Para ter total confiança, é necessária uma verificação abrangente em nível de sistema, incluindo principalmente:
Compatibilidade entre vários componentes de hardware;
Interoperabilidade perfeita entre módulos de rede e de comunicação óptica;
Desempenho sustentável do armazenamento e de todo o caminho de dados;
Comunicação normal durante operações comerciais no mundo real;
Operação estável sob carga total por períodos prolongados;
Fonte de alimentação e desempenho de refrigeração estáveis;
Degradação da eficiência durante a expansão entre nós e racks.
Somente concluindo todo esse processo é possível ter certeza de que sua infraestrutura é absolutamente confiável sob cargas de trabalho reais, em vez de apenas alcançar resultados impressionantes em testes individuais de componentes.
Prontidão para implantação
Estar pronto para a implantação não significa apenas comprar todo o hardware. Modelos de configuração padronizados, listas de materiais (BOMs) validadas, relatórios de testes de compatibilidade, documentação adequada, procedimentos de instalação e responsabilidades claras pela solução de problemas—toda essa preparação operacional é necessária para colocar o cluster em funcionamento e implantá-lo o mais rápido possível.
Olhando para o futuro, o processo de construção da infraestrutura de IA não dependerá mais apenas de quem possui as máquinas mais potentes, mas sim de quão eficazmente esses dispositivos são planejados, conectados e testados para que possam funcionar juntos como um todo plenamente integrado.
Conclusão
Os data centers modernos de IA há muito ultrapassaram a era da "otimização de dispositivos individuais", migrando totalmente para operações colaborativas em nível de sistema. Embora os parâmetros de desempenho máximo ainda tenham valor, a utilização real do poder computacional de IA depende cada vez mais da coordenação entre computação, rede, armazenamento, fornecimento e distribuição de energia, refrigeração e todo o processo de implantação. Para as empresas, a necessidade real é uma arquitetura subjacente que transforme as capacidades teóricas do hardware em capacidade empresarial real altamente flexível, confiável e econômica.
Para atender às necessidades de rede e interconexão, a QSFPTEK oferece uma solução completa, incluindo switches de alta velocidade, placas de interface de rede (NICs), módulos ópticos, e cabeamento estruturado. Como componentes cruciais da arquitetura em nível de sistema, esses componentes melhoram efetivamente a compatibilidade geral da rede, a largura de banda total, a escalabilidade e a prontidão para implantação, lidando sem esforço com cargas de trabalho de IA extremamente exigentes. Convidamos você a explorar mais as soluções de IA da QSFPTEK e a construir uma base de interconexão altamente flexível e rigorosamente validada para seus clusters de computação.


Compartilhar
