


O que é uma fábrica de IA? E por que a óptica 800G/1.6T é sua espinha dorsal
Autor Moore
Data 03/20/2026

A mudança de data centers para fábricas de IA
Algo mudou silenciosamente na forma como a infraestrutura está sendo construída. Não faz muito tempo, um data center era principalmente sobre armazenamento, virtualização e atendimento a solicitações dos usuários. Agora parece diferente. As cargas de trabalho são mais pesadas, mais contínuas e, em muitos casos, nem sequer estão vinculadas a ações diretas dos usuários. Sistemas de IA são executados em segundo plano, gerando, raciocinando, iterando, às vezes passando repetidamente por tarefas que nunca realmente “terminam” no sentido tradicional.
O conceito de “fábrica de IA” não é mais apenas uma palavra da moda; ele está se tornando cada vez mais uma realidade. Os dados são inseridos em grandes modelos para processamento e geração contínua de resultados. Esse sistema se assemelha mais a um sistema industrial do que a uma arquitetura de TI. Assim como a NVIDIA pretendia ao lançar a plataforma Rubin, o objetivo é concluir essa revolução arquitetônica. Os desafios que enfrentamos hoje vão além das capacidades do hardware. No nível da infraestrutura, devemos considerar como construir um sistema capaz de dar suporte à produção de IA em larga escala, reduzindo ao mesmo tempo os custos de inferência e melhorando a previsibilidade da implantação.
Quando a infraestrutura começa a se comportar como uma fábrica, a pressão se espalha por toda a pilha. A computação é apenas uma parte disso. Armazenamento, memória, agendamento, orquestração e, especialmente, rede começam a importar de maneiras diferentes. Você não precisa apenas de desempenho—precisa de consistência sob carga e da capacidade de escalar sem que tudo se torne frágil.
Por dentro da Plataforma Rubin: Um tipo diferente de design de sistema
Ao observar Rubin mais de perto, ele não segue realmente o antigo padrão de atualização incremental. Parece mais uma redefinição. Em vez de melhorar componentes isolados, a plataforma reúne várias camadas e as otimiza como um todo. A CPU Vera, a GPU Rubin, o NVLink 6, a SuperNIC ConnectX-9, a DPU BlueField-4 e a Ethernet Spectrum-6 fazem parte desse design.
Esse tipo de coordenação muda a forma como os sistemas se comportam. Por exemplo, as cargas de trabalho de treinamento MoE agora exigem significativamente menos GPUs em comparação com as gerações anteriores, mas isso não reduz a atividade geral. Apenas a redistribui. A inferência se torna mais frequente, os modelos se tornam mais complexos e as cargas de trabalho se estendem por sequências mais longas. O sistema acaba movendo mais dados, não menos.
O sistema em escala de rack NVL72 é uma boa ilustração. Agrupar dezenas de GPUs em uma unidade rigidamente integrada parece eficiente—e é—, mas isso também cria padrões de comunicação densos dentro do rack. Os dados não fluem mais apenas para cima e para baixo. Eles se movem constantemente lateralmente entre GPUs, pools de memória e aceleradores. Essa pressão interna acaba transbordando para a rede mais ampla.
Por que as fábricas de IA sobrecarregam a rede de uma maneira diferente
A rede dentro de uma AI Factory é diferente o suficiente para que suposições antigas comecem a deixar de se aplicar. Não se trata apenas de haver uma demanda maior por largura de banda. O padrão de tráfego muda. O tráfego leste-oeste é o principal, e geralmente permanece alto em vez de flutuar. As GPUs estão constantemente trocando dados, especialmente em cenários de treinamento distribuído e inferência em várias etapas. A latência se torna mais visível, não na teoria, mas no desempenho real.
Ao mesmo tempo, as tecnologias subjacentes estão avançando rapidamente. O NVLink 6, por exemplo, eleva a largura de banda de GPU para GPU a um nível em que cada dispositivo pode lidar com vários terabytes por segundo. Dentro de um único rack, a largura de banda agregada sobe para centenas de terabytes por segundo. Isso não é um pequeno avanço—é uma escala completamente diferente.
No campo da Ethernet, NVIDIA Spectrum-X está transformando a forma como as redes de IA são construídas. Em vez de tratar a Ethernet como uma malha de uso geral, ela está sendo ajustada especificamente para cargas de trabalho de IA. As melhorias de eficiência são evidentes, mas o que se destaca mais é a estabilidade sob carga sustentada. Clusters de IA não ficam muito ociosos, portanto, o tempo de atividade e a consistência começam a importar tanto quanto o desempenho máximo.
Também há o BlueField-4 na combinação, que desloca algumas funções de tratamento de dados e segurança para fora da CPU. Ele nem sempre recebe tanta atenção, mas em implantações em larga escala ajuda a manter as coisas gerenciáveis. E, com a transição para o armazenamento nativo de IA, em que o contexto de inferência pode ser reutilizado entre sessões, o sistema geral começa a se parecer menos com um conjunto de servidores e mais com um pipeline coordenado.
Tudo isso leva a uma observação simples. Atualmente, a rede é mais do que apenas um conector entre nós de computador. Ela se torna parte do próprio processo de computação. E, uma vez que isso acontece, as limitações dos designs mais antigos—especialmente aqueles baseados em pressupostos de 400G—tornam-se mais aparentes.
400G vs 800G vs 1.6T: O que realmente muda e por que isso importa
Migrando de 400G para 800G, ou até 1.6T, pode parecer uma atualização simples de velocidade. Na realidade, as diferenças vão além dos números de largura de banda.
400G ainda tem seu lugar. Ele é amplamente implantado, relativamente maduro e funciona bem em ambientes com padrões de tráfego previsíveis ou onde o tráfego não está constantemente saturado. Para cargas de trabalho tradicionais em nuvem, ou até mesmo clusters de IA menores, ele ainda pode oferecer um equilíbrio razoável entre custo e desempenho. O problema é que as AI Factories não se comportam mais assim. O tráfego é mais denso, mais contínuo e menos tolerante quando aparecem gargalos.
800G começa a fazer mais sentido quando as arquiteturas de switch migram para SerDes 200G. Em vez de combinar vários links mais lentos, você obtém uma conexão mais clara entre a capacidade do switch e as interfaces ópticas. Isso pode simplificar as coisas em algumas situações, mas, mais importante, aumenta a produtividade geral sem precisar de mais espaço. Em grandes clusters de GPU, esse tipo de eficiência se acumula rapidamente.
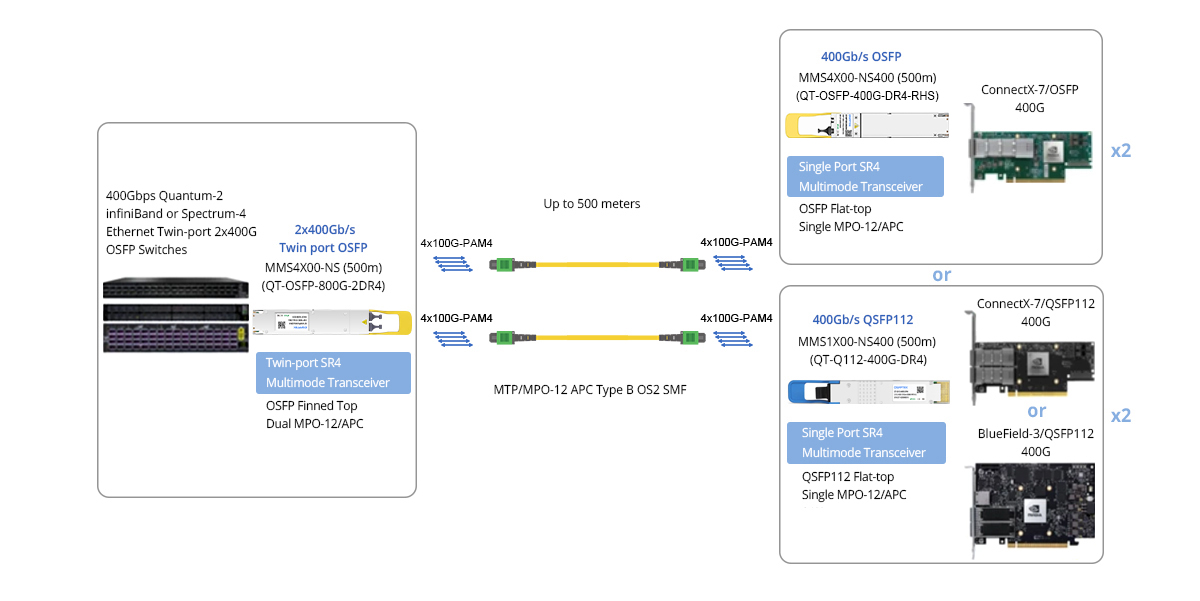
O 800G NVIDIA/Mellanox MMS4X00-NS é compatível com switches Quantum-2 e Spectrum-4 refrigerados a ar, sistemas refrigerados a líquido e DGX-H100, DPUs ConnectX-7 e BlueField-3.
Depois há o 1.6T, que realmente não parece uma atualização, mas sim como se estivessem se preparando para a próxima etapa. Ele permite maior densidade de portas, o que significa que menos switches são necessários para atingir a mesma escala. A eficiência energética por bit também melhora, o que é importante à medida que o consumo de energia começa a limitar a expansão. Em implantações de IA muito grandes—pense em dezenas ou centenas de milhares de GPUs—a diferença entre escalar com 800G e saltar para 1.6T não é apenas técnica; ela também afeta os modelos de custo e o layout físico.
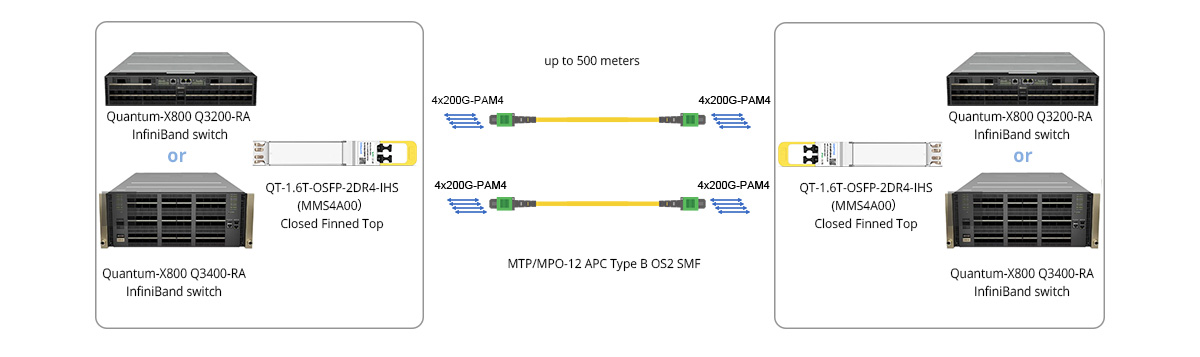
O 1.6T NVIDIA/Mellanox MMS4A00 é compatível com switches Quantum-3 refrigerados a ar e refrigerados a líquido.
Na prática, essas opções não substituem umas às outras da noite para o dia. Elas geralmente convivem. 400G ainda pode ser usado na borda ou em segmentos menos exigentes. 800G está se tornando a principal malha para clusters de IA atuais. 1.6T começa a aparecer em novas implantações ou em partes da rede onde densidade e eficiência são mais importantes. A "melhor" escolha depende menos da ficha técnica e mais de como se espera que o sistema mude ao longo do tempo.
É também aqui que os provedores de soluções podem ajudar. A QSFPTEK, por exemplo, tem 800G e módulos ópticos 1.6T, bem como maneiras de configurá-los que funcionam bem para data centers de IA. O foco está em como essas camadas se encaixam em arquiteturas reais, não apenas nas camadas de velocidade. Em alguns casos, misturar gerações dentro da mesma rede pode levar a melhores resultados do que forçar uma atualização completa de uma só vez.
Olhando para o futuro: por que 1.6T está mais perto do que parece
Embora 800G esteja se tornando mais comum, não parece que seja a versão final. As cargas de trabalho de IA estão crescendo, mas nem sempre das mesmas formas. Os modelos estão ficando maiores, mas também estão se tornando mais interativos. A inferência não é mais um simples ciclo de solicitação-resposta. Ela pode envolver várias etapas, ferramentas externas e janelas de contexto mais longas. Tudo isso aumenta a quantidade de dados que circulam pelo sistema.
Há também a questão da escala além de uma única localização. Algumas das arquiteturas mais recentes são projetadas para conectar vários data centers em um único ambiente lógico. Isso adiciona distância à equação, juntamente com novos desafios de latência e sincronização.
As ópticas 1.6T se encaixam nesse cenário de forma bastante natural. Elas não resolvem tudo, mas eliminam algumas das restrições imediatas relacionadas à largura de banda e à densidade. Em vez de trabalhar constantemente em torno dos limites, o projeto de rede se torna um pouco mais flexível novamente. Só isso já pode simplificar grandes implantações.
Conclusão
A QSFPTEK vem se preparando para esse tipo de cenário com seu portfólio 1.6T, bem como outras soluções de infraestrutura de IA. Não se trata de sempre ir o mais rápido possível. Trata-se mais de ter a opção pronta quando a rede chegar a um ponto em que atualizações incrementais não sejam suficientes.
No fim, a ideia de uma AI Factory traz tudo de volta ao fluxo—como os dados se movem, com que rapidez se movem e com que confiabilidade vão de um lugar a outro. Módulos ópticos normalmente não recebem muita atenção, mas estão bem nesse caminho. E, à medida que o restante do sistema continua a escalar, seu papel se torna mais difícil de ignorar.


Compartilhar
