


O que é InfiniBand XDR e por que ele é importante em redes de IA
Autor Leslie
Data 06/18/2026

InfiniBand XDR é uma solução crucial introduzida devido à escala cada vez maior dos clusters de treinamento de IA e ao rápido aumento na troca de dados entre GPUs. Para grandes plataformas de treinamento com dezenas de milhares de GPUs, a rede não é mais apenas um sistema auxiliar, mas uma infraestrutura crítica que afeta a eficiência do treinamento. Nesse contexto, a evolução contínua da tecnologia InfiniBand em direção a maior largura de banda tornou-se uma tendência, e InfiniBand XDR é precisamente a tecnologia que atende à próxima etapa dos requisitos de rede de IA.
O que é InfiniBand XDR
InfiniBand XDR é a classe de velocidade mais recente no roadmap da tecnologia InfiniBand, impulsionada pela NVIDIA, voltada principalmente para plataformas de computação de IA de próxima geração e ambientes de computação de alto desempenho. Em comparação com a velocidade de porta de 400Gbps da geração anterior NDR, o XDR aumenta a largura de banda de porta única para 800Gbps, alcançando um aumento significativo na capacidade da rede.
De uma perspectiva técnica, o XDR mantém as principais vantagens do InfiniBand, como baixa latência, alta taxa de transferência e RDMA, ao mesmo tempo em que combina SerDes de alta velocidade de próxima geração, chips de comutação e tecnologia de interconexão óptica para fornecer recursos de suporte de rede mais robustos para clusters de GPU em escala ultra grande.
Em termos simples, XDR não se trata apenas de dobrar a velocidade; é uma plataforma de interconexão de próxima geração projetada para atender às necessidades futuras de escalabilidade de clusters de IA.
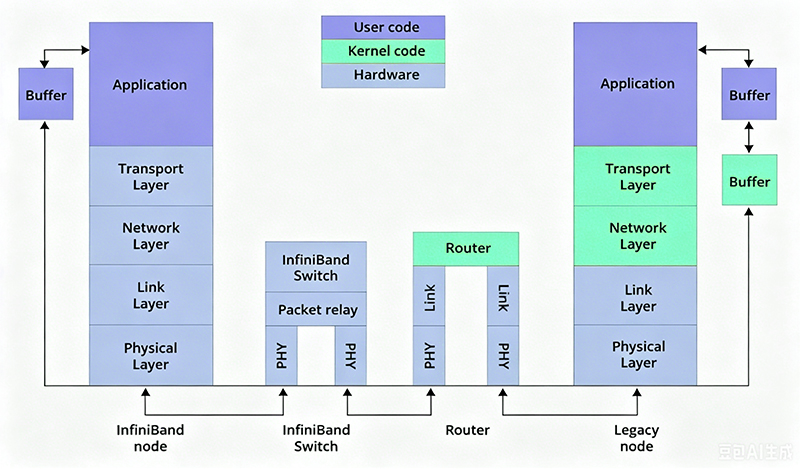
Por que o treinamento de IA requer redes 800G ou 1.6T
Em redes empresariais tradicionais, a maior parte do tráfego é tráfego norte-sul gerado por usuários acessando servidores. Ambientes de treinamento de IA são totalmente diferentes; seu tráfego principal ocorre principalmente entre servidores, ou seja, tráfego leste-oeste.
Durante o treinamento de grandes modelos, inúmeras GPUs precisam trocar frequentemente gradientes, parâmetros do modelo e resultados intermediários de computação. Por exemplo, a operação All-Reduce, comum em treinamento distribuído, gera requisitos significativos de comunicação entre nós.
À medida que o tamanho do modelo cresce de bilhões de parâmetros para centenas de bilhões ou até trilhões de parâmetros, o volume de comunicação de rede também aumenta. Se a rede não conseguir sincronizar os dados em tempo hábil, as GPUs só poderão esperar a transmissão de dados ser concluída, reduzindo assim a utilização geral.
Portanto, nos clusters modernos de IA, o desempenho da rede é tão importante quanto o desempenho da GPU.
Como o InfiniBand XDR aumenta a eficiência de clusters de IA
Primeiro, há o aumento da largura de banda. A 1.6T XDR o link pode transmitir mais dados de treinamento na mesma quantidade de tempo, reduzindo a latência de sincronização no treinamento distribuído e melhorando a utilização da GPU.
Em segundo lugar, há melhor escalabilidade. À medida que os clusters de IA crescem, o número de portas de switch e camadas de rede também aumenta. Taxas de porta mais altas significam que menos links podem ser usados para alcançar a mesma largura de banda, simplificando o projeto da arquitetura de rede.
Além disso, uma largura de banda maior alivia problemas de tráfego de pontos de acesso e congestionamento. Quando milhares de nós de GPU trocam dados simultaneamente, a rede pode fornecer recursos de transmissão mais amplos, reduzindo as oscilações de desempenho.
Para o treinamento de grandes modelos de linguagem, modelos multimodais e tarefas de computação científica, essas vantagens se traduzem diretamente em maior eficiência de treinamento.
Redes de IA InfiniBand XDR e Ethernet
Nos últimos anos, as soluções Ethernet baseadas em RoCEv2 se desenvolveram rapidamente, com Ethernet 400G e 800G amplamente adotada no mercado de data centers de IA. No entanto, InfiniBand ainda mantém uma vantagem significativa em cenários de treinamento em escala ultragrande.
Primeiro, o InfiniBand foi projetado desde o início para ambientes de computação de alto desempenho, e seu mecanismo RDMA, controle de congestionamento e recursos de comunicação agregada foram validados ao longo de um longo período.
Em segundo lugar, a NVIDIA criou um ecossistema InfiniBand completo, incluindo switches Quantum, placas de rede ConnectX e a pilha de software CUDA. Esses componentes trabalham juntos para otimizar o desempenho do treinamento de IA.
Para plataformas de IA que buscam desempenho máximo e latência mínima de comunicação, o InfiniBand continua sendo a solução preferida para muitos centros de supercomputação e grandes clusters de treinamento de IA.
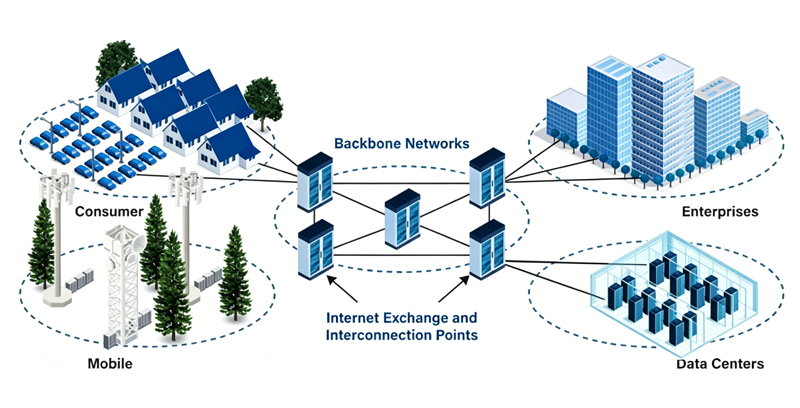
InfiniBand XDR impulsiona upgrades em interconexões ópticas de alta velocidade
À medida que as redes XDR são implantadas gradualmente, as arquiteturas de interconexão óptica de data centers também serão atualizadas de forma correspondente. Links de 800Gbps exigem switches e módulos ópticos de maior desempenho. Módulos ópticos de alta velocidade disponíveis atualmente, como 800G OSFP, 800G OSFP SR8, 800G DR8 e 800G 2x FR4 estão gradualmente se tornando componentes importantes na construção de redes XDR.
Ao mesmo tempo, o cabeamento de fibra óptica, o design dos racks e os sistemas de resfriamento também precisam se adaptar aos requisitos de implantação de maior densidade e maior largura de banda. É previsível que as atualizações de rede em data centers de IA nos próximos anos girem em grande parte em torno do ecossistema de interconexão 800G.
Conclusão
À medida que os tamanhos dos modelos de IA continuam a crescer, as redes se tornaram um fator crucial para determinar a eficiência do treinamento. Como a mais recente geração da tecnologia InfiniBand, o XDR oferece uma plataforma de interconexão mais eficiente para futuros clusters de GPU em hiperescala por meio de sua largura de banda de 800G e 1.6T, arquitetura de baixa latência e excelente escalabilidade. Na evolução contínua da infraestrutura de IA, espera-se que o XDR se torne uma das principais tecnologias que impulsionam o desenvolvimento dos centros de computação inteligente de próxima geração.


Compartilhar
