


KI-Training vs. KI-Inferenz: Warum sie unterschiedliche Netzwerkarchitekturen erfordern
Autor Moore
Datum 08/03/2026

Da Unternehmen die Einführung von KI beschleunigen, erscheinen KI-Training und KI-Inferenz zunehmend in derselben Infrastrukturstrategie. Sie als ähnliche Arbeitslasten zu behandeln, kann jedoch leicht zu Fallstricken bei der Netzwerkplanung führen. Tatsächlich geht der Unterschied zwischen Training und Inferenz weit über die Anwendungsebene hinaus; sie entsprechen völlig unterschiedlichen Leistungszielen, Datenverkehrsmerkmalen und betrieblichen Prioritäten. Dies bedeutet, dass eine Netzwerkarchitektur nicht auf ein einziges Datenverkehrsplanungsmodell zurückgreifen kann, um beide Bereiche gleichzeitig zu bewältigen.
Was ist KI-Training?
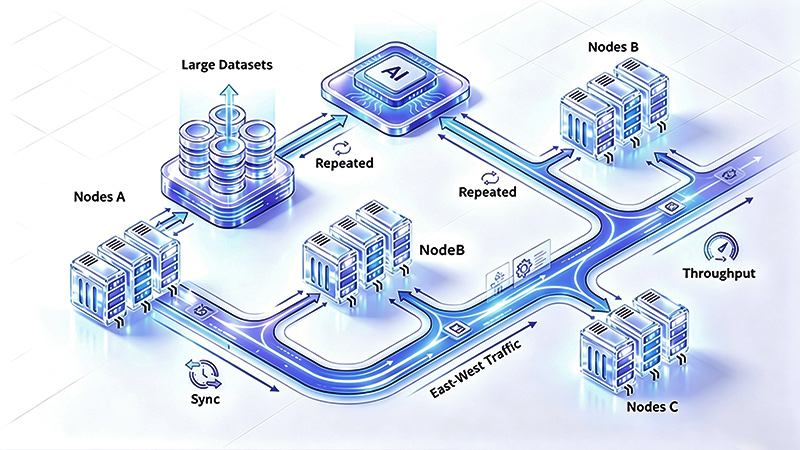
Beim Training von KI wird ein Modell von Grund auf mithilfe großer Datenmengen und wiederholter Berechnungen erstellt und kontinuierlich verbessert. Das Ziel ist einfach: In einer großen, verteilten Umgebung soll die Modellgenauigkeit verbessert und gleichzeitig die Trainingszeit minimiert werden.
In den meisten Fällen erzeugt das Training von KI viel Netzwerkverkehr zwischen GPUs, Servern und Clustern. Diese Art von Workload ist stark auf ausreichende Bandbreite, gute Synchronisierungsmechanismen und einen vorhersehbaren Durchsatz angewiesen. Daher konzentrieren sie sich beim Entwurf von Netzwerken für Trainingsumgebungen in der Regel darauf, Datenpipelines voll auszulasten, Kommunikationsengpässe zu beseitigen und groß angelegte parallele Berechnungen innerhalb der gesamten KI-Infrastruktur zu unterstützen.
Was ist KI-Inferenz?
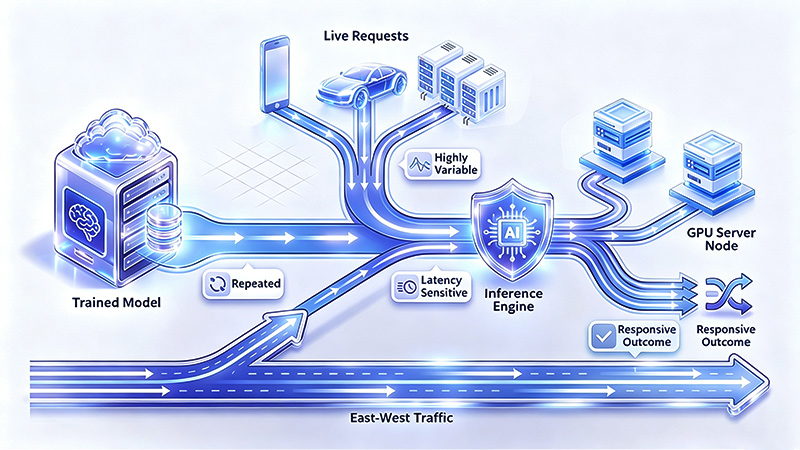
Einfach ausgedrückt bedeutet KI-Inferenz, ein trainiertes Modell in realen Szenarien einzusetzen—um unmittelbare Anfragen zu empfangen und zu verarbeiten und Ergebnisse in Echtzeit oder nahezu in Echtzeit bereitzustellen. In dieser Phase geht es nicht mehr darum, das Modell selbst intelligenter zu machen, sondern Nutzern oder Anwendungen höherer Ebenen schnelle, stabile und problemlos skalierbare Antwortdienste bereitzustellen.
Im Vergleich zur Trainingsphase ist der Datenverkehr bei der Inferenz wesentlich dynamischer und burstartiger. Der Datenverkehr kann in einer Sekunde stabil sein und im nächsten Moment dramatisch ansteigen, was zu einer hohen Parallelitätsbelastung und einer extremen Latenzempfindlichkeit führt. In diesem Zusammenhang haben sich die Maßstäbe zur Messung der Netzwerkleistung verschoben: Statt einfach konstant einen hohen Durchsatz anzustreben, stehen die Reaktionsgeschwindigkeit des Systems, die Stabilität der Dienstqualität und die Fähigkeit zur Verarbeitung verschiedener Datenverkehrsspitzen in einer verteilten Rechenzentrum sind zu kritischeren Indikatoren geworden.
KI-Training vs. KI-Inferenz: Welche Unterschiede gibt es bei den Netzwerkanforderungen?
Bevor wir konkrete Netzwerkarchitekturen besprechen, vergleichen wir KI-Training und KI-Inferenz anhand mehrerer zentraler Dimensionen. Obwohl beide unter das Dach derselben KI-Infrastruktur fallen, unterscheiden sich ihre Leistungsziele, Datenverkehrsmerkmale und betrieblichen Prioritäten grundlegend. Das Verständnis dieser Unterschiede erklärt, warum eine einzige Strategie für die Netzwerkplanung wahrscheinlich nicht in der Lage ist, beide Aspekte gleichzeitig effektiv zu verwalten.
Warum erfordern verschiedene Workloads unterschiedliche Planungsprioritäten?
Beim Verständnis des Unterschieds zwischen KI-Training und Inferenz geht es nicht nur um deren Bezeichnung. Der entscheidendere Widerspruch besteht darin, dass diese beiden Aufgaben das Netzwerk in völlig unterschiedliche Optimierungsrichtungen lenken.
Betrachten wir zunächst das KI-Training. Das Netzwerk muss in der Lage sein, eine langfristige Kommunikation mit hohem Datenvolumen zwischen Rechenressourcen zu bewältigen. Bei einer schlechten Verkehrsplanung besteht die unmittelbarste Folge darin, dass die GPU-Rechenleistung nicht vollständig genutzt wird, sich Trainingszyklen verlängern und die mühsam aufgebaute Infrastruktur verschwendet wird. Daher sind die Kernanforderungen an das Trainingsnetzwerk sehr klar—: Es soll einen hohen Durchsatz, Fairness bei der Planung großer Datenmengen und eine konstant stabile Übertragungseffizienz bieten.
Doch mit KI-Inferenz ändert sich die Situation erheblich. Hier verbindet sich der Datenverkehr direkt mit Benutzern oder Anwendungen, und Latenz sowie Schwankungen werden zu den größten Schmerzpunkten. Sie können nicht einfach dieselbe Scheduling-Logik, die beim Training im großen Maßstab verwendet wird, auf die Inferenz anwenden. Wenn das Netzwerk den gesamten Datenverkehr gleich behandelt, werden die Antwortzeiten bei hohem Datenverkehr oder plötzlichen Spitzen unvorhersehbar.
Aus diesem Grund muss der Unterschied zwischen Training und Inferenz auf die Ebene des Netzwerkdesigns gehoben werden, anstatt als Geschäftskategorie behandelt zu werden. Wenn sich die Leistungsziele ändern, muss sich natürlich auch die zugrunde liegende Planungslogik ändern.
Wie kann die Netzwerkplanung die Anforderungen der KI-Auslastung präzise erfüllen?
Unterschiedliche Lastcharakteristiken bestimmen direkt unterschiedliche Strategien zur Verkehrsplanung.
In KI-Trainingsszenarien müssen Planungsstrategien eine vorhersehbare Stream-Verarbeitung, einen effizienten Lastausgleich und eine extrem hohe Netzwerkauslastung in den Vordergrund stellen. Kurz gesagt geht es darum, kontinuierlich riesige Datenmengen zwischen verteilten Rechenknoten zu übertragen, ohne eine Überlastung zu verursachen. Diese Art von Datenverkehr reagiert nicht empfindlich auf die Mikro-Latenz einer einzelnen Anfrage, stellt jedoch über lange Zeiträume äußerst hohe Anforderungen an die gesamte Kommunikationseffizienz.
KI-Inferenz ist eine ganz andere Angelegenheit. Die Verkehrsplanung muss flexibel und reaktionsschnell sein. Das Netzwerk muss große Datenmengen schnell verarbeiten und auch bei einer hohen Anzahl von Anfragen stabil bleiben. Das bedeutet nicht nur eine schnelle Übertragung, sondern auch die Minimierung von Latenz und Leistungsschwankungen.
Letztendlich lassen sich die Unterschiede in der Scheduling-Logik zwischen Training und Inferenz in zwei grundlegenden Richtungen zusammenfassen:
KI-Training: Der Fokus liegt auf der Maximierung des Netzwerkdurchsatzes durch stabile Datenflüsse und eine effiziente Übertragung.
KI-Inferenz: Der Schwerpunkt liegt auf der Minimierung der Übertragungslatenz durch schnelle Reaktion und Anpassung an plötzliche Verkehrsspitzen.
Für Architekten, die KI-Infrastrukturen entwerfen, ist die Klärung dieser Abgrenzung eine wesentliche und grundlegende Aufgabe, die nicht umgangen werden kann.
Was sollte beim Design von KI-Infrastruktur priorisiert werden?
Nach der Klärung der Unterschiede zwischen Training und Inferenz besteht der nächste Schritt darin, diese Merkmale in konkrete Prioritäten für das Architekturdesign zu übersetzen. Kurz gesagt, liegt der Fokus nicht mehr darauf, die Unterschiede zwischen den beiden zu wiederholen, sondern darauf, wie die Netzwerkarchitektur in praktischen Bereitstellungen umgesetzt werden sollte.
Zu den wichtigsten Überlegungen gehören:
Enge Abstimmung mit den geschäftlichen Merkmalen: Beim Netzwerkdesign muss zunächst der vorherrschende Lasttyp identifiziert werden. Es sollte vermieden werden, eine einzige Architektur auf alle anzuwenden. KI-Geschäft.
Präzise Zeitplanabstimmung: Strategien zur Verkehrsplanung müssen auf die Muster des Lastverhaltens abgestimmt sein, damit Netzwerkstrategien die tatsächlichen Ziele der Anwendungsleistung wirklich unterstützen.
Gesamtkoordination der Ressourcen: Bei der Planung des Netzwerks müssen Rechenleistung, Datenverkehr und Übertragungsverhalten ganzheitlich innerhalb der gesamten KI-Infrastruktur betrachtet werden, wobei ihre Wechselwirkungen zu untersuchen sind.
Aufrechterhaltung der betrieblichen Flexibilität: Mit der zunehmenden Verbreitung von kombiniertem Training und Inferenz muss das Netzwerksystem in der Lage sein, Strategien und Leistung in Umgebungen mit gemischter Auslastung flexibel anzupassen.
Für Netzwerktopologien mit Schwerpunkt auf Training bietet ein verlustfreies RoCE-Netzwerkdesign eine äußerst praxisnahe Referenz für eine überlastungsbewusste Übertragung.
Fazit
Die Behandlung von KI-Training und KI-Inferenz als zwei unterschiedliche Netzwerk-Workloads ist eine entscheidende Voraussetzung für eine effektive Architekturplanung. Die Unterschiede gehen weit über die Phase des Modells in seinem Lebenszyklus hinaus; sie wirken sich direkt auf Leistungsprioritäten, Datenverkehrsmerkmale und spezifische Planungsanforderungen aus.
Letztendlich erinnern uns Gespräche über Training und Inferenz daran, dass das Netzwerkdesign zur Geschäftswelt passen muss. Training hängt vom Durchsatz ab, während Inferenz sehr latenzempfindlich ist. Daher müssen Strategien zur Verkehrsplanung angepasst werden, um diese spezifischen Anforderungen zu erfüllen. Wenn Sie als Unternehmen eine skalierbare KI-Infrastruktur aufbauen möchten, ist dies entscheidend, um präzise und effektive Netzwerkentscheidungen zu treffen.


Teilen
