


1.6T XDR erschließen: Der neue Grundpfeiler des KI-Supercomputings der nächsten Generation
Autor Moore
Datum 08/28/2026

Da groß angelegte KI-Trainings und Modelle mit Billionen von Parametern zum Standard werden, verlagern sich die Leistungsengpässe in der KI-Infrastruktur— von der reinen Rechenleistung zur Netzwerkvernetzung. Während sich GPUs rasant weiterentwickeln, wächst der massive Ost-West-Datenverkehr, der durch verteiltes Training entsteht, noch schneller. Daher sind Netzwerkbandbreite, Latenz und Skalierbarkeit zu den entscheidenden Faktoren für die Bestimmung der gesamten Rechenauslastung des Clusters geworden.
Die Netzwerktechnologie hat sich von HDR 200G zu NDR 400G und 800G weiterentwickelt, und heute zeichnen sich die Konturen der nächsten Evolutionsstufe bereits deutlich ab: Eine 1,6T-Interconnect-Architektur auf Basis einer 200G-Signaltechnologie pro Kanal rückt in den Mittelpunkt. Durch die Kombination aus Siliziumphotonik, fortschrittlichen DSPs und hochdichter optischer Interconnect-Technologie wird 1,6T InfiniBand XDR eine zentrale Rolle bei der Unterstützung zukünftiger KI-Supercomputing-Cluster spielen.
KI-Cluster treiben die Entwicklung von Netzwerken von 800G NDR zu 1.6T XDR voran
Netzwerkherausforderungen für hyperskalierte KI-Cluster
Das verteilte KI-Training von heute’s erfordert häufig, dass Tausende oder sogar Zehntausende GPUs zusammenarbeiten. Die Synchronisierung von Parametern im großen Maßstab, die Aggregation von Gradienten und die häufige Kommunikation zwischen Clustern erzeugen eine enorme Menge an Ost-West-Netzwerkverkehr innerhalb von Rechenzentren.
Da die Clustergrößen weiter zunehmen, beginnen bestehende HDR- und NDR-Netzwerke, Engpässe aufzuweisen, hauptsächlich in den folgenden Bereichen:
Bandbreitenbeschränkungen: Angesichts der Anforderungen an die Hochgeschwindigkeitskommunikation massiver GPU-Arrays haben 400G-Verbindungen bereits Schwierigkeiten, Schritt zu halten, was zu ungenutzten Rechenressourcen und einer geringeren Gesamtauslastung führen kann.
Einschränkungen der Übertragungsentfernung: Herkömmliche optische SR-Lösungen mit Multimode-Fasern bieten relativ kurze Abdeckungsdistanzen, was die Flexibilität von Hyperscale-Rechenzentren bei der Rack-Anordnung und Raumplanung direkt einschränkt.
Die doppelte Herausforderung von Stromverbrauch und Signalintegrität: Die Erhöhung der elektrischen Signalrate zur Steigerung des Durchsatzes führt zu einem starken Anstieg des Stromverbrauchs und stellt hohe Anforderungen an das Wärmemanagement. Zudem entstehen erhebliche Herausforderungen bei der Kontrolle der Bitfehlerrate (BER).
InfiniBand-Netzwerke wurden in den letzten 20 Jahren immer besser und schneller, um mit solchen Problemen umzugehen. Mit jedem Generationswechsel wurden große Durchsatzsteigerungen erzielt, während kontinuierlich schnellere SerDes-Technologien und leistungsfähigere zugrunde liegende Interconnect-Architekturen eingeführt wurden.
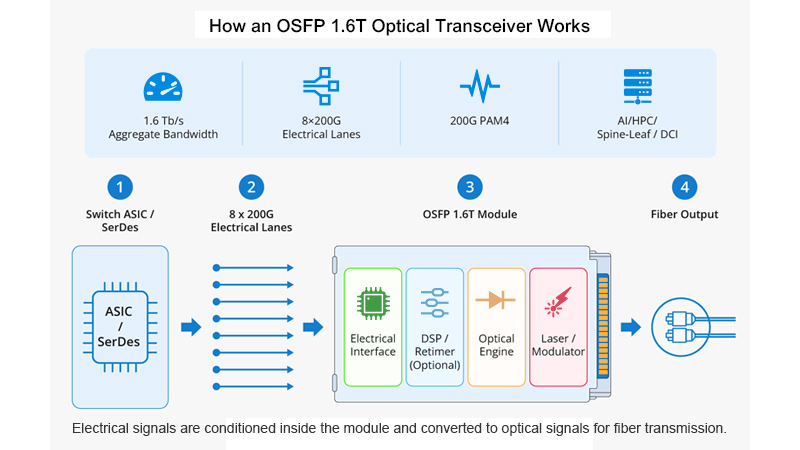
Branchenübliche Basisparameter der Kerntechnologie für 1.6T XDR
Der Kern dieses Generationssprungs liegt in der umfassenden Aufrüstung elektrischer Signale von 100G SerDes auf 200G. Durch die Verdopplung der Bandbreite pro Kanal—in Kombination mit fortschrittlicher DSP-Technologie und einer verbesserten Packaging-Architektur—kann die XDR-Plattform der neuen Generation die Obergrenze des gesamten Netzwerkdurchsatzes deutlich anheben, ohne die Systemkomplexität wesentlich zu erhöhen.
Wichtige zugrunde liegende Technologien für 1.6T XDR
Nur die Bandbreite zu erhöhen, reicht nicht aus. Für 1.6T-Interconnects Damit sie wirklich funktionieren, müssen sie sich in einer Reihe von Bereichen gemeinsam weiterentwickeln, etwa bei der optischen Verpackung, der DSP-Signalverarbeitung, dem Wärmemanagement und Low-Level-Switch-Chips, um nur einige zu nennen.
Eine eingehende Analyse der Full-Stack-Hardwarearchitektur: 1.6T XDR vs. 800G NDR
Um ein leistungsstarkes KI-Netzwerk aufzubauen, reicht eine einfache Aufrüstung der Switch-Chips bei Weitem nicht aus. Die gesamte Interconnect-Infrastruktur muss auf dem koordinierten Zusammenspiel von optischen Modulen, DAC-Direktanschluss-Kupferkabeln, aktiven optischen AOC-Kabeln und Komponenten für Abzweigverbindungen basieren, um die strengen Anforderungen für unterschiedliche Übertragungsentfernungen zu erfüllen.
Von GPUs im Rack über Switch-Verbindungen bis hin zu Backbone-Verbindungen über große Entfernungen, die verschiedene Rechenzentren verbinden, spielt jede Komponente eine unverzichtbare Rolle bei der Unterstützung eines hochgradig skalierbaren Netzwerks.
Produktmatrix für optische Module: Von 800G NDR bis 1.6T Silicon Photonics
Für Verbindungen über mittlere und lange Distanzen in KI-Rechenzentren sind optische Module nach wie vor die bevorzugte Lösung. Je nachdem, wie weit das Signal übertragen werden muss und welcher Fasertyp verwendet wird, unterteilt die Branche sie üblicherweise in drei Kategorien: SR-Multimode-Lösungen (kurze Reichweite), DR-Singlemode-Lösungen (Rechenzentrumsklasse) und FR-Singlemode-Lösungen (große Reichweite).
Mit dem Erreichen von Datenraten von 1.6T wird die Siliziumphotonik-Technologie (SiPh) immer wichtiger. Optische Funktionen direkt auf eine siliziumbasierte Plattform zu bringen, ist für die Siliziumphotonik ein echter Wendepunkt. Das bietet viele Vorteile.
Höhere Integrationsdichte
Geringerer Stromverbrauch
Bessere Skalierbarkeit für die Massenproduktion
Mehr Flexibilität beim Wärmemanagement
Dank dieser Eigenschaften ist die Siliziumphotonik zu einem der wichtigsten Wege für den zukünftigen großflächigen Einsatz von 1.6T-Netzwerken geworden.
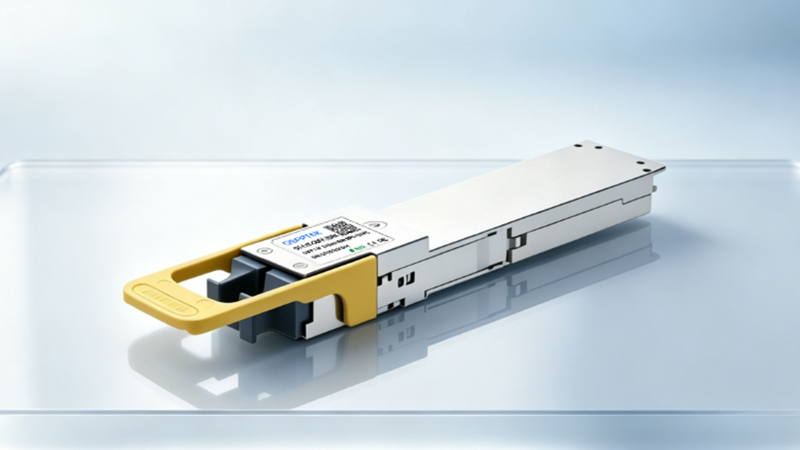
1.6T XDR OSFP DR8 (1310 nm Singlemode-Siliziumphotonik-Lösung)
Die Betriebswellenlänge beträgt 1310 nm, und es wird eine Singlemode-Faserübertragung verwendet.
Die typische Übertragungsdistanz beträgt bis zu 500 Meter.
Verfügt über ein duales MPO-Schnittstellendesign
Parallele Architektur mit 8 Kanälen und einer Datenrate von ungefähr 200G pro Kanal
Typische Anwendungen: Backbone-Verbindungen zwischen KI-Switches der nächsten Generation und die Bereitstellung von Fabric-Netzwerken für KI-Cluster im Hyperscale-Bereich.
800G NDR OSFP-Serie
SR8 (850 nm Multimode): Es verwendet OM3- und OM4-Fasern für Kurzstreckenverbindungen mit hoher Geschwindigkeit innerhalb von Rechenzentren.
FR8 (1310 nm Singlemode): Es kann über große Entfernungen, sogar mehrere Kilometer, übertragen, sodass Sie Verbindungen über große Entfernungen zwischen Gebäuden und Campusgeländen herstellen können.
400G NDR OSFP / QSFP56 Serie
Bietet bewährte Architekturen wie SR4, DR4 und FR4
Ermöglicht eine reibungslose Weiterentwicklung und Umstellung von HDR-Netzwerken
Weit verbreitet auf der Serverseite und in Netzwerken der Zugriffsebene eingesetzt.
Hochgeschwindigkeitskabel-Matrizen: DAC- und AOC-Verbindungslösungen
Diese Kabel werden hauptsächlich verwendet, um GPU-Server und Switches im selben Rack zu verbinden. Zu den häufigsten Typen gehören passive Kupferkabel (DAC), aktive optische Kabel (AOC) und Splitterkabel (1-zu-2 oder 1-zu-4). Diese Kabel sind wegen ihrer Erschwinglichkeit und der hochdichten Verkabelung bei Kurzstreckenverbindungen in KI-Clustern beliebt.
Passive DAC-Kupferkabel mit Direktanschluss (OSFP / QSFP56-Schnittstellen): Diese Kabel enthalten an keinem Ende Signalverarbeitungschips und nutzen ausschließlich Kupfermedien zur Übertragung reiner elektrischer Signale. Dadurch bieten sie die Vorteile eines extrem niedrigen Stromverbrauchs und geringer Kosten. Übliche Längen sind hauptsächlich 1 Meter und 3 Meter, und sie sind speziell für interne Verbindungen in Racks mit einer Länge von 1 bis 3 Metern ausgelegt. Zu den Produktformen gehören standardmäßige Durchgangskabel, Y-förmige 1-zu-2-Splitter und 1-zu-4-Splitter, die eine kostengünstige und flexible Erweiterung von Multi-GPU-Knoten ermöglichen, indem sie die Bandbreite eines einzelnen Ports aufteilen.
Aktive AOC-Kabel: Diese Kabel integrieren an beiden Enden optoelektronische Konvertierungschips und verwenden in der Mitte Glasfaser zur Übertragung, wodurch die physikalischen Übertragungsentfernungsbeschränkungen von Kupferkabeln vollständig überwunden werden. Der HDR 200G AOC unterstützt Übertragungsentfernungen von bis zu 100 Metern, während der NDR 400G AOC Entfernungen von mehreren Dutzend Metern abdecken kann; sie werden hauptsächlich für Hochgeschwindigkeitsverbindungen zwischen benachbarten Racks verwendet.
Breakout-Kabel: Diese unterstützen Konvertierungsspezifikationen wie OSFP zu 2×QSFP56 oder OSFP zu 4×OSFP, sodass ein einzelner 800G-Port in mehrere 200G/400G-Downlinks aufgeteilt werden kann. Sie eignen sich perfekt für flexible Netzwerke in vielfältigen KI-Clustern und können ungenutzte und verschwendete Switch-Ports deutlich reduzieren.
Über drei Generationen hinweg: Die Entwicklung von Netzwerkhardware
Von HDR zu NDR und nun zu XDR geht der technologische Sprung weit über die bloße Verdoppelung von Bandbreitenzahlen hinaus. Mit jeder Generation der Weiterentwicklung wurden die zugrunde liegende Signalmodulation, DSP-Architektur, optische Packaging-Designs und der gesamte Stromverbrauch umfassend überarbeitet.
Die wesentlichen Unterschiede zwischen diesen drei Generationen von Hardwarearchitekturen zeigen sich hauptsächlich in diesen Kernmetriken.
Der praktische Nutzen von 1.6T-XDR-Netzwerken in KI-Supercomputing-Clustern
Steigert die Auslastung der GPU-Rechenleistung erheblich
Dank der Architektur mit extrem niedriger Latenz, die 1.6T-RDMA und InfiniBand kombiniert, wurde die Kommunikationslatenz zwischen GPUs auf den Mikrosekundenbereich reduziert. Beim verteilten Training großer Modelle kann die effektive Auslastung der Rechenleistung von GPU-Clustern direkt von etwa 40% auf 75%–80% steigen, wodurch der Trainingszyklus für Modelle mit Billionen von Parametern erheblich verkürzt wird. Wenn bestehende 800G-NDR-Cluster auf ein XDR-Backbone-Netzwerk aufgerüstet und umgestellt werden, wird erwartet, dass die gesamte Trainingseffizienz des Clusters um mehr als 40% steigt.
Optimierung der Kosten für Verkabelung und Rechenzentrumsinfrastruktur
Reduzierung der Gesamtzahl der Switch-Ports: Mit der doppelten Bandbreite pro Port wird die Anzahl der von einem Switch benötigten Ports um 50% reduziert, während dieselbe Rechenkapazität unterstützt wird, wodurch Rackplatz, Lasten der Stromverteilung und Kühlungskosten erheblich gesenkt werden.
Erweiterte Übertragungsdistanz: Die Singlemode-DR/FR-Serienmodule mit 1310nm unterstützen Übertragungsdistanzen von 500 Metern bis 2 Kilometern. Dies ist besser als die Entfernungsbeschränkungen, die durch 850nm-Multimodefasern in der physischen Gestaltung von Rechenzentren entstehen. Dadurch lassen sich Racks in intelligenten Rechenzentren einfacher aufteilen und zusätzliche Kapazitäten hinzufügen.
Überlegene Energieeffizienz der vollständigen Verbindung: Die Integration von Siliziumphotonik mit einer hochmodernen 3-nm-DSP-Lösung senkt den Energieverbrauch pro Gbit/s Bandbreite im Vergleich zu herkömmlichen diskreten Komponenten um etwa 25 %. Dadurch sinken die Stromkosten für Supercomputing-Cluster mit 10.000 Karten und ganzjährig hoher Auslastung deutlich.
Kompatibel mit vorhandenen Netzwerkkomponenten
Das XDR-1.6T-Protokoll funktioniert mit NDR 800G und HDR 200G. Sie müssen Ihre 200G/400G-Cluster nicht vollständig neu aufbauen. Ersetzen Sie einfach die Core-Switches und optischen Backbone-Module, um schrittweise auf 1.6T umzusteigen. Dadurch lassen sich die anfänglichen Upgrade-Kosten erheblich senken.
Auswahlempfehlungen für häufige Szenarien
Unterschiedliche Geschäftsszenarien stellen unterschiedliche Anforderungen an die Vernetzung. Bei der Auswahl der Hardware berücksichtigen Sie in der Regel Faktoren wie die erforderliche Signalreichweite, den benötigten Verkabelungsaufwand, das verfügbare Budget und die Frage, ob künftig eine Erweiterung erforderlich sein wird.
Auf Grundlage des tatsächlichen Bedarfs in gängigen Geschäftsumgebungen werden die empfohlenen Netzwerkhardwarelösungen für verschiedene Szenarien wie folgt zusammengefasst:
Zusammenfassung
Betrachtet man die allgemeinen technologischen Trends in der Branche, nimmt die Einführung der Siliziumphotonik weiter zu. Sobald Netzwerkgeschwindigkeiten die Schwelle von 800G überschreiten, wird der Wert der Siliziumphotonik bei der Reduzierung des Energieverbrauchs und der Steigerung der Integration unersetzlich. Gleichzeitig bewegen sich 1.6T-Netzwerke von einer zukunftsorientierten Planung hin zu einer substanziellen kommerziellen Einführung und werden in den kommenden Jahren zum Rückgrat für KI-Training mit hoher Bandbreite. Was längerfristige Lösungen wie Co-Packaged Optics (CPO) betrifft, bleibt R&D die Begeisterung groß. Sowohl heute als auch in absehbarer Zukunft werden ausgereifte steckbare optische Module bei der Bereitstellung eindeutig den Mainstream bilden.
Dies bedeutet auch, dass 1,6T den klarsten und pragmatischsten entscheidenden Schritt beim aktuellen Ausbau der KI-Infrastruktur darstellt. Um die 1,6T-Architektur jedoch tatsächlich umzusetzen, reicht eine einfache Aufrüstung der Switch-Hardware bei Weitem nicht aus; erforderlich sind die koordinierten Anstrengungen eines gesamten Interconnect-Ökosystems, das optische Module, Hochgeschwindigkeitskabel und Netzwerkarchitektur umfasst.
Mit einem vollständigen Produktportfolio für 400G, 800G und das aufkommende 1.6T— – darunter Transceivermodule auf Basis der Siliziumphotonik, hochdichte DAC/AOC-Kabelbaugruppen und KI-orientierte Netzwerklösungen— – engagiert sich QSFPTEK dafür, Anwender beim Aufbau einer hoch skalierbaren und leistungsstarken Computing-Infrastruktur zu unterstützen und einen stabileren und nahtloseren Übergang von der bestehenden NDR-Architektur zum AI-Fabric der nächsten Generation mit 1.6T zu gewährleisten.


Teilen
