


Entwicklung der KI-Computing-Architektur: Scale-Up vs. Scale-Out und die Wahl optischer Module
Autor Moore
Datum 04/02/2026

Da groß angelegte Modelle Billionen von Parametern erreichen und die Größe von KI-Clustern sich Hunderttausenden von GPUs nähert, durchläuft die zugrunde liegende Computing-Infrastruktur einen bedeutenden architektonischen Wandel. Die beiden gängigen Netzwerkmodelle für KI-Computing—Scale-Up und Scale-Out—entwickeln sich entlang unterschiedlicher technischer Pfade weiter, konvergieren in der Praxis jedoch allmählich an wichtigen Punkten.
Diese Änderung ist im Wesentlichen das Ergebnis wiederholter Abwägungen zwischen "niedriger Latenz und hoher Skalierbarkeit" und "hoher Zuverlässigkeit und Kostenkontrolle". Gleichzeitig prägt die kontinuierliche Weiterentwicklung optischer Modultechnologien (wie LPO, NPO und CPO) zunehmend das Systemdesign.
Scale-Up vs. Scale-Out: Differenzierung und Kompromisse zwischen zwei Ansätzen
Beim Design von KI-Computing-Clustern verfolgen Scale-Up und Scale-Out von Anfang an unterschiedliche Ziele, und ihre Bewertungskriterien sind nicht entlang derselben Dimension ausgerichtet. Sie können als zwei unterschiedliche Ansätze verstanden werden.
Scale-Up: Eng gekoppelte Architektur mit Schwerpunkt auf niedriger Latenz und starker Konsistenz
Scale-up ähnelt eher der Erweiterung der Rechenleistung eines einzelnen Knotens; im Wesentlichen geht es um „horizontale Integration“ innerhalb der bestehenden GPU-Architektur. Durch den Aufbau eng gekoppelter Recheneinheiten wird der lokale Speicher mehrerer GPUs in einen einheitlichen logischen Raum abstrahiert, sodass der Rechenkern beim Zugriff auf entfernten Speicher nahezu lokale HBM erfährt. Dieser Ansatz der Near-Memory-Semantik zielt nicht nur darauf ab, die Skalierung zu erweitern, sondern auch die Distanz zwischen Berechnung und Daten zu minimieren, die Latenz auf unter Mikrosekunden zu reduzieren und gleichzeitig hohe Konsistenz und Stabilität aufrechtzuerhalten.
Scale-Out: Auf Skalierbarkeit ausgerichtetes verteiltes Rechenmodell
Im Gegensatz dazu ähnelt Scale-Out eher dem Zusammenfügen verteilter Rechenleistung, indem eine große Anzahl von Knoten über ein Netzwerk zu einem zusammenhängenden Ganzen organisiert wird. Typische Implementierungen basieren auf einer zwei- oder dreischichtigen Clos-Architektur und verbinden Zehntausende oder sogar noch mehr GPUs mit demselben Trainingscluster, um Datenparallelität, Pipeline-Parallelität und andere Trainingsmodi zu unterstützen. Bei diesem Ansatz geht es vor allem um Skalierbarkeit und Kostenkontrolle, damit das System stets verfügbar ist und mit Ihren Anforderungen wachsen kann, während es mit Ihrer aktuellen Hardware und Software arbeitet.
Im Allgemeinen geht es bei Scale-Up darum, „individuelle Fähigkeiten“ zu verbessern, um Spitzenleistung und geringe Latenz zu erreichen. Bei Scale-Out hingegen dreht sich alles um „Skaleneffizienz“, wodurch große Cluster reibungslos laufen können. Ersteres konzentriert sich auf die Kerneinheiten im Hochleistungsrechnen, während Letzteres das grundlegende Netzwerk für groß angelegtes Training und Inferenz bildet. Diese beiden Modi existieren in realen KI-Infrastrukturen häufig nebeneinander und ergänzen sich gegenseitig.
Aktuelle Entwicklung: Änderungen der Scale-Up-Architektur und Trends zur Scale-Out-Vereinfachung
In den letzten Jahren haben sich Scale-Up und Scale-Out rasant weiterentwickelt, und führende Hersteller haben herausgefunden, wie sie diese in der Praxis umsetzen können. Ziel ist es, die Leistung zu steigern und gleichzeitig die Komplexität zu vereinfachen.
Scale-Up: Von chassis-basiertem Betrieb zu Koexistenz mehrerer Formfaktoren, 224G-Interconnect wird zu einem Schlüsselknoten
Frühe Lösungen für wachsende Unternehmen konzentrierten sich hauptsächlich auf "Chassis SuperNodes", die Rechenressourcen in einem einzigen System zusammenführten und sie über Hochgeschwindigkeitsverbindungen verbanden. Diese Lösungen betonten Stabilität und Konsistenz und verwendeten typischerweise eine Kombination aus "Kabel-Backplane + L1/L2-Switching": Interne Chassis-Verbindungen stützten sich hauptsächlich auf elektrische Verbindungen, um eine hohe Bandbreitendichte zu gewährleisten; die chassisübergreifende Erweiterung stützte sich auf optische Verbindungen.
Optische 224G-Verbindungen werden allmählich zur bevorzugten Wahl für Scale-up-Szenarien. Aus Sicht des Kostenmodells ist der Preis von 1.6T optische Module wird in den nächsten drei bis fünf Jahren wahrscheinlich ungefähr beim 1,2- bis 1,4-Fachen von 800G bleiben. Dieser Unterschied ist recht einfach zu handhaben, unabhängig davon, ob er auf LPO oder einer traditionellen DSP-Architektur basiert. Die Verwendung von 112G-Technologie bedeutet jedoch oft, dass für dieselbe Bandbreite mehr Glasfaser benötigt wird, was letztlich mehr kostet. Wenn man Faktoren wie Bandbreite, Stromverbrauch und Verkabelungskomplexität berücksichtigt, ist die 224G-Lösung langfristig besser.
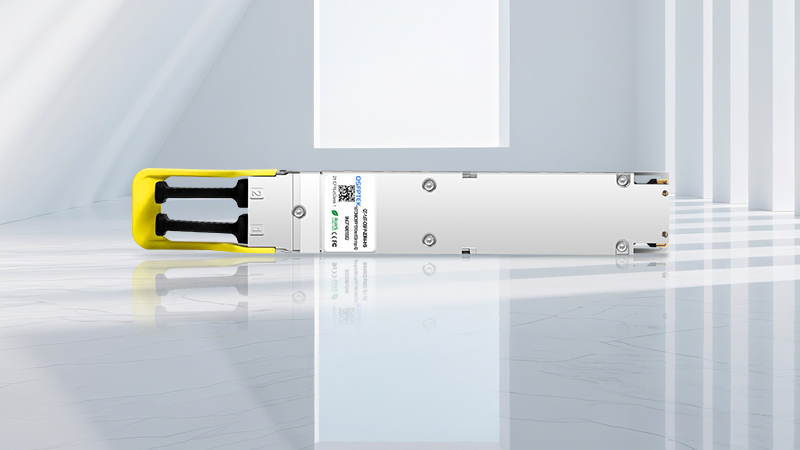
QSFPTEK 1.6T Optisches Modul
Die Branche folgt diesem Trend und hat mit der Entwicklung entsprechender Produkte begonnen, wie etwa der OSFP-Serienmodule von QSFPTEK, die 1.6T-Raten unterstützen (z. B. 2×DR4- und 2×FR4-Spezifikationen). Diese zielen in erster Linie darauf ab, die Anforderungen zukünftiger Supernode-Architekturen an hohe Bandbreite und geringe Latenz zu erfüllen. Diese Produkte bereiten Rechenzentren außerdem auf den nächsten Schritt ihres Wachstums vor.
Scale-Out: Von drei Ebenen zu zwei Ebenen, Netzwerkstruktur wird schrittweise flacher
Eine bedeutende Veränderung bei Scale-out-Architekturen ist die zunehmende Betonung der Vereinfachung im Gesamtdesign. Das zuvor verbreitete dreistufige Clos-Netzwerk wird nach und nach durch eine zweistufige Clos-Architektur ersetzt. Durch die Reduzierung der Anzahl der Zwischenschichten wird der Netzwerkpfad direkter, wodurch die Systemkomplexität verringert wird. Bei diesem Design können selbst Trainingscluster, die auf Hunderttausende von GPUs ausgelegt sind, eine hohe Skalierbarkeit beibehalten und gleichzeitig die Netzwerkkosten unter Kontrolle halten.
Diese Veränderung ist größtenteils auf Verbesserungen der Fähigkeiten von Switching-Chips zurückzuführen. Da die Portgrößen immer weiter zunehmen, zum Beispiel wenn Radix 512 Ports erreicht, kann ein zweistufiges Clos-Netzwerk Knotengrößen von über 100.000 direkt unterstützen und in einigen Designmodellen sogar rund 130.000 Beschleunigerkarten abdecken, ohne dass eine zusätzliche Core-Switching-Schicht erforderlich ist. Das bedeutet, dass große KI-Cluster beim Skalieren die Bandbreitendichte beibehalten und gleichzeitig eine klarere Netzwerktopologie aufrechterhalten können.
Multi-Plane-Netzwerke: Entlastung des Bandbreitendrucks durch Multi-Plane-Design
Aufbauend auf dieser Grundlage haben einige Hersteller begonnen, neue Methoden der Netzwerkorganisation zu untersuchen. Beispielsweise ist die in einschlägiger Forschung vorgeschlagene Multi-Plane-Architektur ein typischer Ansatz. Bei diesem Schema greift die AI-NIC über mehrere Hochgeschwindigkeitsports gleichzeitig auf verschiedene Clos-Netzwerkebenen zu; beispielsweise verwendet sie vier 200G-Schnittstellen, um vier unabhängige Netzwerkebenen zu verbinden, und auf der Sendeseite verteilt sie denselben Datenstrom mithilfe eines Round-Robin-Verfahrens über die Ebenen.
Auf der Empfangsseite setzt ein Datenverarbeitungsmechanismus, der Out-of-Order-Schreibvorgänge unterstützt, Daten aus verschiedenen Pfaden wieder zusammen, sodass eine einzelne Verbindung nicht zum Engpass wird. Dieser Ansatz verbessert die Bandbreitennutzung auf einer einzelnen GPU in Scale-Out-Szenarien und erreicht in einigen Testmodellen eine Gesamtauslastung von über 95 %.
Aus Trendperspektive liegt der Fokus von Scale-Out nicht nur auf der Erhöhung des Umfangs, sondern darauf, durch strukturelle Optimierung und Innovation im Netzwerkdesign ein ausgewogeneres Verhältnis zwischen Bandbreite, Effizienz und Kosten in ultr gro n AI-Clustern zu erreichen.
Trends bei der Auswahl optischer Module: LPO/NPO gewinnt an Beliebtheit, CPO geht allmählich zurück
Sowohl in Scale-Up- als auch in Scale-Out-Architekturen sind optische Module nicht nur das Verbindungsmedium, sondern beeinflussen auch direkt Latenz, Stromverbrauch und Link-Stabilität. Daher unterscheiden sich verschiedene technologische Ansätze zunehmend in ihrer Wahl der Formfaktoren für optische Module. Die Unterschiede zwischen LPO, NPO und herkömmlichen DSP-fähigen Lösungen werden deutlicher, während die Popularität von CPO relativ zurückgegangen ist.
Scale-Up: Lösungen mit geringerer Latenz bevorzugen LPO/NPO
In Szenarien, in denen das System hochskaliert wird, besteht das Ziel darin, Latenz und Stromverbrauch zu reduzieren. Dadurch werden LPO- oder NPO-Lösungen ohne DSPs beliebter. Diese optischen Module vereinfachen den Signalverarbeitungspfad, wodurch ihr Stromverbrauch erheblich reduziert wird. Zum Beispiel ein 800G-Modul mit einer LPO-Lösung verbraucht etwa 6W, eine deutliche Verbesserung gegenüber herkömmlichen DSP-ausgestatteten Produkten, die typischerweise etwa 15W verbrauchen.
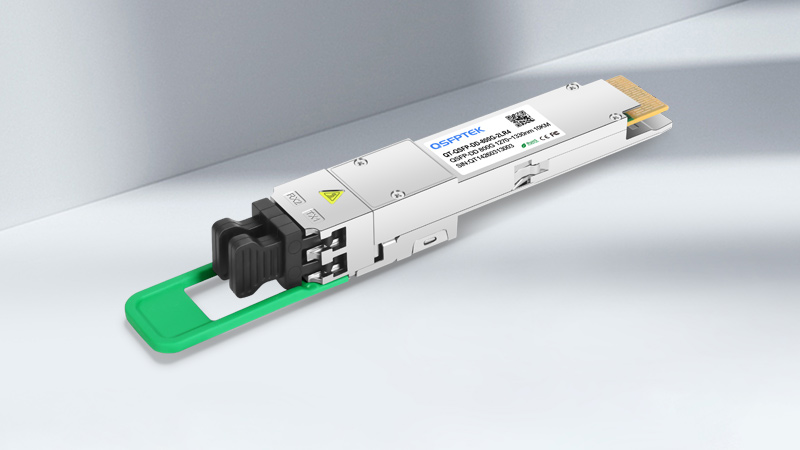
Optisches QSFPTEK 800G-Modul
Gleichzeitig reduziert eine geringere DSP-Beteiligung an der Datenverarbeitung auch die Verbindungslatenz. Die Einweglatenz kann um mehrere zehn Nanosekunden verkürzt werden, mit einer noch ausgeprägteren Reduzierung der Round-Trip-Latenz. Diese Eigenschaften machen sie besser geeignet für die Scale-up-Anforderungen von "kurzer Reichweite, hoher Konsistenz", und einige für KI-Rechenzentren optimierte LPO-Produkte sind auf diese Kennzahlen ausgelegt.
Scale-Out: DSP-Architektur ist weiterhin die gängige Wahl
In Umgebungen, in denen Systeme horizontal skaliert werden, ist es jedoch eine ganz andere Sache. Optische Module mit digitalen Signalprozessoren (DSPs) eignen sich besser für die Handhabung großer Netzwerkverbindungen und langer Übertragungsdistanzen. Aus diesem Grund bleiben sie die bevorzugte Wahl.
Einerseits können DSPs in Bezug auf die Fehlerkontrolle komplexere Forward Error Correction-Mechanismen unterstützen, wodurch die Verbindung nach der Korrektur eine niedrigere Fehlerrate erreichen kann, was sie für Übertragungsszenarien über große Entfernungen geeignet macht. LPO/NPO-Module hingegen verfügen in dieser Hinsicht über relativ begrenzte Fähigkeiten und erfüllen häufig nicht die Stabilitätsanforderungen für Verbindungen zwischen Rechenzentren oder Links im Bereich von 10 km.
Andererseits umfasst der Einsatz großer Cluster typischerweise die gemischte Bereitstellung von Geräten mehrerer Anbieter, was höhere Anforderungen an die Interoperabilität stellt. DSP-Optikmodule auf Basis von Standardprotokollen (wie IEEE 802.3) sind bei der herstellerübergreifenden Kompatibilität ausgereifter, während sich LPO/NPO-Standards noch weiterentwickeln und das Ökosystem noch nicht vollständig vereinheitlicht ist.
Insgesamt sind die beiden technischen Wege klar geworden: Scale-Up verwendet in der Regel LPO/NPO, um geringere Latenz und niedrigeren Stromverbrauch zu erreichen. Scale-Out setzt weiterhin auf die DSP-Architektur, um Langstreckenübertragung und Systemkompatibilität sicherzustellen. Trotz ihrer unterschiedlichen Implementierungsmethoden verfolgen beide dasselbe Ziel bei der Bandbreitenentwicklung—die Entwicklung hin zu 224G-Single-Channel-Geschwindigkeiten.
Die realen Herausforderungen von Integration und Implementierung: Chancen und Grenzen bestehen nebeneinander
Wenn die hohe Zuverlässigkeit von Scale-up und die groß angelegte Skalierbarkeit von Scale-out beginnen, sich zu überschneiden, scheint die Richtung der "konvergierten Netzwerke" natürlich. Zwischen Experimenten und groß angelegter Bereitstellung gibt es jedoch noch mehrere unvermeidbare Hürden.
Architektonische Unterschiede: Schwierigkeit bei der Vereinheitlichung von Speicherse mantik und Nachrichtensemantik
Die beiden Systeme arbeiten auf unterschiedlichen Ebenen. Scale-Up ähnelt der „Speichersemantik“, die GPUs den Zugriff auf entfernte Ressourcen ermöglicht. Dadurch können alle Geräte schnell miteinander kommunizieren. Scale-Out hingegen basiert auf „Nachrichtensemantik“ und verwendet Mechanismen wie RDMA zum Senden und Empfangen von Daten. Es handelt sich im Grunde um ein explizites Kommunikationsmodell. Die wesentlichen Unterschiede in der Art und Weise, wie sie ihre Systeme entwerfen und aufbauen, bedeuten, dass ihre Integration komplizierter ist, als nur sicherzustellen, dass sie alle miteinander kommunizieren können.
Inkonsistente Zuverlässigkeitspfade: So führen Sie stabile Verbindungen ein
Um sicherzustellen, dass ein Design zuverlässig ist, verwendet Scale-Up typischerweise eine "Kabel-Backplane + Switching-Struktur", um das Risiko von Link-Ausfällen zu verringern und den kritischen Pfad in einem hochstabilen Bereich zu halten. Im Gegensatz dazu verwenden Scale-Out-Systeme in der Regel optische Module für die Verbindung. Um Konvergenz zu erreichen, muss ein Teil des Scale-Out-Datenverkehrs auf die hochzuverlässigen Links von Scale-Up umgeleitet werden, was die Rekonstruktion der bestehenden Netzwerktopologie erfordert. Bei Clustern mit Zehntausenden oder sogar Hunderttausenden von Karten sind solche Anpassungen von Natur aus komplexe Engineering-Projekte.
Herstellerübergreifende Zusammenarbeit: Standards und Ökosysteme bleiben fragmentiert
Konvergente Netzwerke sind nicht nur eine Frage der Architektur; sie erfordern auch Branchenzusammenarbeit. Eine engere Standardabstimmung zwischen Switching-Chips, GPUs und optischen Modulen ist erforderlich. Beispielsweise hängen LPO-bezogene Lösungen weiterhin von der Verfeinerung einheitlicher Spezifikationen für die herstellerübergreifende Interoperabilität ab. Gleichzeitig müssen speicherbasierte Switching-Strukturen an die Schnittstellenimplementierungen verschiedener GPU-Anbieter angepasst werden. Derzeit konzentrieren sich führende Anbieter hauptsächlich auf ihre eigenen Ökosysteme, und Protokolle sowie Implementierungspfade sind nicht vollständig vereinheitlicht, was das Tempo der Konvergenz bis zu einem gewissen Grad verlangsamt hat.
Im Zusammenhang mit diesen Fragen zeichnen sich einige zentrale Fragen ab: Hat LPO die Chance, einen Durchbruch bei der Interoperabilität zu erzielen und zu einer universelleren optischen Interconnect-Lösung zu werden? Können Speichersemantik und Nachrichtensemantik auf Softwareebene integriert werden, damit das System sowohl niedrige Latenz als auch hohe Skalierbarkeit erreicht?
Sicher ist, dass der Wettbewerb um Computing-Infrastruktur in eine tiefere Phase eingetreten ist. Jede Anpassung der optischen Modultechnologie, der Netzwerkstruktur und der Methoden der Branchenzusammenarbeit wird sich auf das Ergebnis auswirken. Anstatt einfach zwischen zwei Wegen zu wählen, könnte eine realistischere Richtung darin bestehen, verschiedene Systeme innerhalb derselben Infrastruktur gemeinsam arbeiten zu lassen. Im Einklang mit diesem Trend wurden auch Ideen ähnlich wie "Scale-Across" als Übergangsform vorgeschlagen, die die beiden Modi verbindet.


Teilen
