


Auf dem Weg zur Rubin-Architektur: Der Sprung von KI-Rechenzentrumsnetzwerken von 800G auf 1.6T
Autor Leslie
Datum 04/02/2026

NVIDIAs Rubin-GPU-Plattform der nächsten Generation treibt einen grundlegenden Wandel im Design der KI-Infrastruktur voran. Da KI-Workloads von Milliarden auf Billionen von Parametern anwachsen, gehen die Herausforderungen weit über die Rechenleistung hinaus. Was die Systemeffizienz wirklich bestimmt, ist oft die Fähigkeit, Daten effizient zwischen Tausenden von GPUs zu übertragen. In diesem Zusammenhang ist das Netzwerk nicht mehr nur eine unterstützende Schicht, sondern eine Kernkomponente, die die KI-Leistung bestimmt. Diese Systeme sind von Natur aus auf massive Parallelität ausgelegt, mit kontinuierlicher und intensiver Kommunikation zwischen Knoten, wodurch die Designlogik von Rechenzentren neu gestaltet wird.
Was ist Rubin Architecture
NVIDIAs Rubin-Architektur ist ein Upgrade der Blackwell-Architektur. Sie ist eine kollaborative Full-Stack-Computing-Plattform, die speziell für das Training von KI-Modellen im sehr großen Maßstab und Inferenz mit niedriger Latenz entwickelt wurde. Sie besteht aus mehreren neuen Chips, bietet höhere Leistung und Energieeffizienz, unterstützt den effizienten Betrieb groß angelegter KI-Aufgaben und dient als Kerninfrastruktur, die die großflächige Entwicklung von KI vorantreibt.
Im Gegensatz zu früheren GPUs, die sich hauptsächlich auf die Verbesserung der Single-Chip-Leistung konzentrierten, wurde Rubin von Anfang an für groß angelegte verteilte KI-Systeme entwickelt. Sein ultimatives Ziel ist es, ein effizientes Training auf Clustern mit Zehntausenden von GPUs zu ermöglichen.
In dieser Umgebung müssen GPUs kontinuierlich Gradienten, Parameter und Zwischendaten austauschen. Die Kommunikationslast ist extrem hoch, und die Effizienz der Datenübertragung wirkt sich direkt auf die Trainingsgeschwindigkeit aus. Während Technologien wie InfiniBand und RDMA die Latenz reduzieren und den Durchsatz erhöhen können, sind sie dennoch auf ausreichende Bandbreite auf der physischen Ebene angewiesen.
Die Rolle von 800G in der KI-Infrastruktur
Die 800G-Verbindung hat sich allmählich zum De-facto-Standard für leistungsstarke KI-Infrastrukturen entwickelt. Im Vergleich zu 400G-Lösungen erreicht 800G die doppelte Bandbreite und bietet dabei in dieser Phase ein angemessenes Gleichgewicht zwischen Stromverbrauch und Bereitstellungskomplexität.
In tatsächlichen Bereitstellungen, 800G-Lösungen weisen eine klare Arbeitsteilung basierend auf Anwendungsszenarien auf:
DACs werden für Verbindungen über ultrakurze Distanzen zwischen GPUs und ToR-Switches innerhalb eines Server-Racks verwendet. Kupferverkabelung verursacht nahezu keinen zusätzlichen Stromverbrauch und bietet die niedrigste Übertragungslatenz, wodurch sie das bevorzugte Medium für hochdichte Verbindungen innerhalb von Server-Racks ist.
AOCs eignen sich für Verbindungen über kurze bis mittlere Entfernungen zwischen Server-Racks. AOCs integrieren optische Module und Kabel, vereinfachen den Bereitstellungsprozess vor Ort, gewährleisten gleichzeitig die Signalintegrität und reduzieren den Reinigungs- und Wartungsaufwand für Glasfaserschnittstellen.
Optische Module werden in der zentralen Backbone-Schicht strukturierter Netzwerke eingesetzt und unterstützen Langstreckenverbindungen in Spine-Leaf-Architekturen. Optische Module ermöglichen in Verbindung mit Glasfaser-Verkabelungssystemen die Netzwerkerweiterung über PODs und Regionen hinweg.
Dieser mehrschichtige Bereitstellungsansatz spiegelt die tatsächlichen technischen Anforderungen großer KI-Cluster wider. Am Beispiel von QSFPTEK deckt die 800G-Produktlinie das gesamte Spektrum von DACs, AOCs und optischen Modulen ab. Ihr zentraler Wert liegt darin, sicherzustellen, dass Benutzer in einer dreischichtigen Netzwerkarchitektur eine konsistente Kompatibilitätsleistung erhalten. In hochdichten KI-Clusterumgebungen mit hohem Durchsatz ist stabile Interoperabilität über verschiedene Szenarien hinweg oft aussagekräftiger als ein einzelner Leistungsindikator.
Die Grenzen von 800G in der Rubin-Ära
Während sich 800G-Lösungen in aktuellen AI-Clustern bereits bewährt haben, werden ihre Einschränkungen angesichts der Computing-Dichte der nächsten Generation, wie sie durch die NVIDIA Rubin-Architektur repräsentiert wird, zunehmend deutlich.
Die Hauptursachen für Druck sind die folgenden drei Aspekte:
Rasant steigende GPU-Dichte: Die Anzahl der GPUs pro Rack entwickelt sich vom derzeitigen Mainstream von 8 auf 16 oder 32, und der aggregierte Bandbreitenbedarf innerhalb des Racks springt vom Tbps-Niveau auf mehrere zehn Tbps, was eine große Herausforderung für das Konvergenzverhältnis der ToR-Switch-Ports darstellt.
Erweiterung der Clustergröße: Cluster-Knoten wachsen von Tausenden auf Zehntausende oder sogar Hunderttausende von Knoten, und das Muster der Netzwerküberlastung entwickelt sich von lokalen Hotspots zu global verteilter Überlastung. Eine bloße Erhöhung der Anzahl der Verbindungen führt zu einem überproportionalen Anstieg der Verkabelungskomplexität, des Stromverbrauchs und der Wartungskosten;
Entwicklung der Kommunikationsmodi: Neue Modellparallelismus-Strategien, repräsentiert durch Expert Parallelism (MoE), erhöhen die Synchronisationsfrequenz zwischen GPUs im Vergleich zur traditionellen Transformer-Architektur erheblich, sodass das Netzwerksystem gleichzeitig die kombinierten Anforderungen an hohe Bandbreite und niedrige Latenz erfüllen muss.
Aus der Perspektive der Abstimmungsbeziehung zwischen Rechenleistung und Netzwerk wird erwartet, dass der Single-Card-Rechendurchsatz der Rubin-Plattform mehr als doppelt so hoch ist wie der der Blackwell-Architektur. Wenn die Netzwerkbandbreite unverändert bleibt, wird der Anteil der Leerlaufzeit, in der Rechenressourcen auf Daten warten, erheblich steigen, was die effektive Nutzung der GPU-Rechenleistung direkt begrenzt.
Warum 1.6T-Module benötigt werden
Die Weiterentwicklung der 1.6T-Verbindungstechnik wird größtenteils durch den zwingenden Bedarf an Netzwerkbandbreite durch GPU-Architekturen der nächsten Generation vorangetrieben. Ihre Bedeutung liegt nicht nur in der Verdopplung der Portgeschwindigkeiten, sondern auch darin, einen tragfähigen technischen Weg zur Behebung der oben genannten strukturellen Engpässe bereitzustellen.
Der Kernwert von 1.6T spiegelt sich in den folgenden Dimensionen wider:
Erhöhte Bandbreitendichte: Ein einzelner Port bietet einen Datendurchsatz von 200GB/s. Beispielsweise kann ein 48-Port-Switch eine aggregierte Bandbreite von nahezu 10Tbps bereitstellen, wodurch die Anzahl der Ports und der belegte Rackplatz im Vergleich zu 800G-Lösungen um etwa die Hälfte reduziert werden;
Vereinfachte Topologie: Bei gleicher Clustergröße unterstützt 1.6T eine flachere Netzwerktopologie, etwa die Vereinfachung einer dreistufigen Clos-Architektur zu einer zweistufigen Architektur, wodurch die Anzahl der Geräte in der Spine-Schicht reduziert und gleichzeitig die durch schichtübergreifende Weiterleitung verursachte Latenzakkumulation verringert wird.
Reduzierte betriebliche Komplexität: Die Verringerung der Anzahl der Verbindungen führt direkt zu einer gleichzeitigen Verringerung der Anzahl der Glasfaserkerne, optischen Module und Fehlerpunkte. In großen Clustern kann sich dieser Effekt in einer erheblichen Verbesserung der betrieblichen Effizienz niederschlagen.
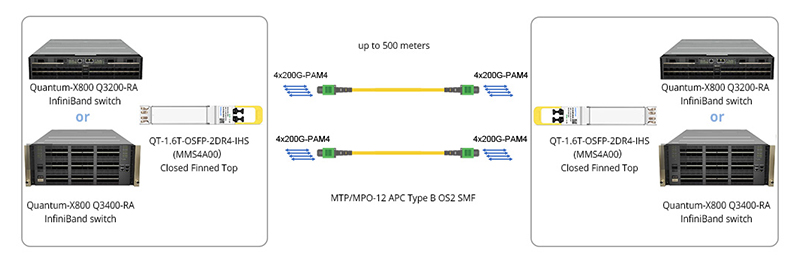
QSFPTEK hat bereits mit der Technologieeinführung in der 1.6T-Produktlinie begonnen und bietet mehrere 1.6T-Module für KI-Rechenzentren. Das bedeutet, dass sie die Integration von Netzwerken der nächsten Generation in die bestehende 800G-Infrastruktur proaktiv planen können, statt während der vollständigen Bereitstellung der Rubin-Architektur unter dem Druck reaktiver Upgrades zu stehen.
Empfohlener tatsächlicher Upgrade-Pfad
Die Entwicklung von 800G zu 1.6T in realen Rechenzentrumsumgebungen folgt typischerweise einem schrittweisen Pfad und nicht einem einmaligen vollständigen Austausch.
Sie können sich auf den folgenden Upgrade-Pfad beziehen:
Access Layer und Kurzstreckenverbindungen: Verwenden Sie weiterhin die 800G-DAC- und AOC-Lösungen. Die Vorteile von Kupferverkabelung und aktiven optischen Kabeln in Bezug auf Stromverbrauch und Kosten bleiben kurzfristig für Kurzstreckenszenarien innerhalb von und zwischen Racks schwer zu ersetzen;
Spine-Layer und Core-Backbone: Führen Sie zuerst optische 1.6T-Module und Switches ein, um aggregierten Datenverkehr über PODs hinweg zu transportieren, und reservieren Sie ausreichende Bandbreitenreserven für die Core-Layer, um zukünftige Erweiterungsanforderungen zu erfüllen;
Übergang zu einer Hybridarchitektur: Ermöglicht den hybriden Betrieb von 800G- und 1.6T-Geräten durch Link-Aggregation oder Mechanismen zur Ratenverhandlung, schließt schrittweise den Generationswechsel von der Zugriffsschicht bis zur Kernschicht ab und vermeidet einmalige Investitionsausgaben sowie Risiken von Dienstunterbrechungen.
Für Rechenzentren, die bereits eine 800G-Infrastruktur bereitgestellt haben, wird typischerweise eine reibungslose Übergangsphase von 2-3 Jahren vorgesehen. Während dieses Zeitraums ist es erforderlich, gleichzeitig auf die Abwärtskompatibilität der optischen Module, die reservierte Kapazität des Verkabelungssystems und die Multi-Rate-Koordinationsfähigkeiten des Netzwerkbetriebssystems zu achten.
Fazit
Der Wechsel von 800G- zu 1.6T-Optikmodulen ist unerlässlich, um NVIDIA’s Rubin-Architektur zu unterstützen. 1.6T bietet eine höhere Bandbreitendichte, eine einfachere Netzwerkstruktur und geringere Latenz, um den Anforderungen von Rechenzentren der nächsten Generation gerecht zu werden. Mit einem stufenweisen Upgrade-Ansatz können Benutzer ihre Infrastruktur reibungslos umstellen und gleichzeitig die 1.6T-Optiklösungen von QSFPTEK’s für stabile, leistungsstarke Cluster-Konnektivität voll ausschöpfen.


Teilen
