


Was ist InfiniBand XDR und warum ist es in KI-Netzwerken wichtig
Autor Leslie
Datum 06/18/2026

InfiniBand XDR ist eine entscheidende Lösung, die aufgrund der stetig wachsenden Größe von KI-Trainingsclustern und des raschen Anstiegs des Datenaustauschs zwischen GPUs eingeführt wurde. Bei großen Trainingsplattformen mit Zehntausenden von GPUs ist das Netzwerk nicht mehr nur ein Hilfssystem, sondern eine kritische Infrastruktur, die die Trainingseffizienz beeinflusst. Vor diesem Hintergrund ist die kontinuierliche Weiterentwicklung der InfiniBand-Technologie hin zu höherer Bandbreite zu einem Trend geworden, und InfiniBand XDR ist genau die Technologie, die die nächste Stufe der Anforderungen an KI-Netzwerke erfüllt.
Was ist InfiniBand XDR
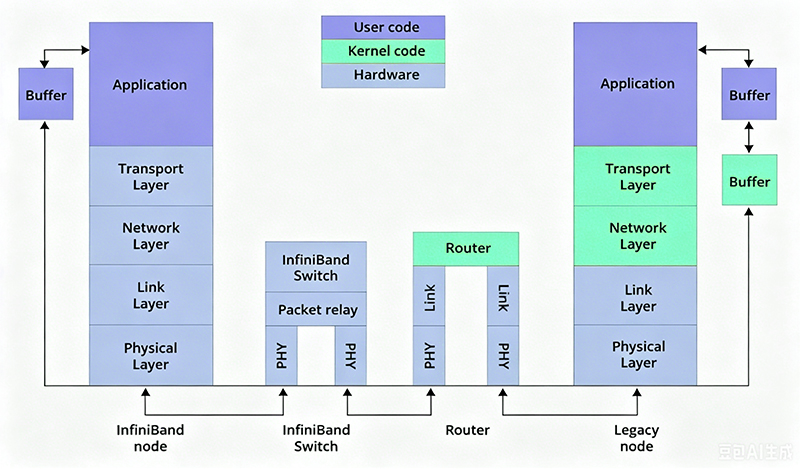
InfiniBand XDR ist die neueste Geschwindigkeitsklasse in der Technologie-Roadmap von InfiniBand, vorangetrieben von NVIDIA, und zielt hauptsächlich auf KI-Computing-Plattformen der nächsten Generation und Hochleistungsrechnerumgebungen ab. Im Vergleich zur Portgeschwindigkeit von 400 Gbit/s der vorherigen NDR-Generation erhöht XDR die Bandbreite pro Port auf 800 Gbit/s und erreicht damit eine erhebliche Steigerung der Netzwerkkapazität.
Aus technischer Sicht führt XDR die Kernvorteile von InfiniBand wie niedrige Latenz, hohen Durchsatz und RDMA fort und kombiniert gleichzeitig Hochgeschwindigkeits-SerDes der nächsten Generation, Switching-Chips und optische Interconnect-Technologie, um stärkere Netzwerkunterstützungsfunktionen für ultra-große GPU-Cluster bereitzustellen.
Einfach ausgedrückt geht es bei XDR nicht nur um eine Verdopplung der Geschwindigkeit; es ist eine Interconnect-Plattform der nächsten Generation, die darauf ausgelegt ist, die zukünftigen Skalierungsanforderungen von KI-Clustern zu erfüllen.
Warum erfordert KI-Training 800G- oder 1.6T-Netzwerke
In traditionellen Unternehmensnetzwerken ist der meiste Datenverkehr Nord-Süd-Verkehr, der dadurch entsteht, dass Benutzer auf Server zugreifen. KI-Trainingsumgebungen sind völlig anders; ihr zentraler Datenverkehr findet hauptsächlich zwischen Servern statt, d. h. als Ost-West-Verkehr.
Während des Trainings großer Modelle müssen zahlreiche GPUs häufig Gradienten, Modellparameter und Zwischenergebnisse von Berechnungen austauschen. Beispielsweise erzeugt die im verteilten Training übliche All-Reduce-Operation erhebliche Anforderungen an die Kommunikation zwischen Knoten.
Wenn die Modellgröße von Milliarden von Parametern auf Hunderte von Milliarden oder sogar Billionen von Parametern anwächst, nimmt auch das Volumen der Netzwerkkommunikation zu. Wenn das Netzwerk Daten nicht rechtzeitig synchronisieren kann, können GPUs nur auf den Abschluss der Datenübertragung warten, wodurch die Gesamtauslastung sinkt.
Daher ist in modernen KI-Clustern die Netzwerkleistung ebenso wichtig wie die GPU-Leistung.
Wie InfiniBand XDR die Effizienz von KI-Clustern steigert
Zunächst gibt es die erhöhte Bandbreite. A 1.6T XDR Die Verbindung kann in derselben Zeit mehr Trainingsdaten übertragen, wodurch die Synchronisationslatenz beim verteilten Training reduziert und die GPU-Auslastung verbessert wird.
Zweitens gibt es eine bessere Skalierbarkeit. Mit dem Wachstum von AI-Clustern steigt auch die Anzahl der Switch-Ports und Netzwerkschichten. Höhere Port-Raten bedeuten, dass weniger Links verwendet werden können, um dieselbe Bandbreite zu erreichen, was das Design der Netzwerkarchitektur vereinfacht.
Darüber hinaus lindert eine größere Bandbreite Hotspot-Datenverkehrs- und Überlastungsprobleme. Wenn Tausende von GPU-Knoten gleichzeitig Daten austauschen, kann das Netzwerk umfangreichere Übertragungsressourcen bereitstellen und so Leistungsschwankungen reduzieren.
Beim Training großer Sprachmodelle, multimodaler Modelle und bei wissenschaftlichen Rechenaufgaben führen diese Vorteile direkt zu einer höheren Trainingseffizienz.
InfiniBand XDR und Ethernet-KI-Netzwerke
In den letzten Jahren haben sich RoCEv2-basierte Ethernet-Lösungen rasant entwickelt, wobei 400G- und 800G-Ethernet im Markt für KI-Rechenzentren weit verbreitet sind. InfiniBand behält jedoch weiterhin einen erheblichen Vorteil in Szenarien für Training in extrem großem Maßstab.
Erstens wurde InfiniBand von Anfang an für High-Performance-Computing-Umgebungen entwickelt, und sein RDMA-Mechanismus, seine Überlastungssteuerung und seine gebündelten Kommunikationsfähigkeiten wurden über einen langen Zeitraum validiert.
Zweitens hat NVIDIA ein vollständiges InfiniBand-Ökosystem aufgebaut, einschließlich Quantum-Switches, ConnectX-Netzwerkkarten und des CUDA-Software-Stacks. Diese Komponenten arbeiten zusammen, um die Leistung beim KI-Training zu optimieren.
Für KI-Plattformen, die höchste Leistung und minimale Kommunikationslatenz anstreben, bleibt InfiniBand für viele Supercomputing-Zentren und große KI-Trainingscluster die bevorzugte Lösung.
InfiniBand XDR treibt Upgrades bei optischen Hochgeschwindigkeits-Interconnects voran
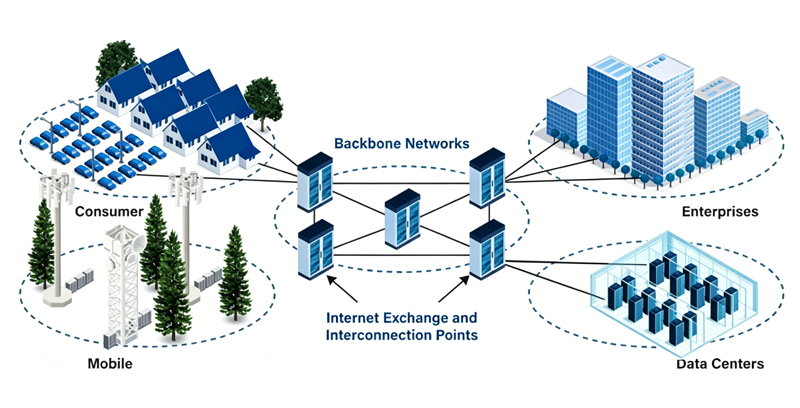
Da XDR-Netzwerke schrittweise bereitgestellt werden, werden auch die optischen Interconnect-Architekturen von Rechenzentren entsprechend aufgerüstet. 800Gbps-Verbindungen erfordern leistungsfähigere Switches und optische Module. Derzeit verfügbare optische Hochgeschwindigkeitsmodule, wie z. B. 800G OSFP, 800G OSFP SR8, 800G DR8 und 800G 2x FR4 werden nach und nach zu wichtigen Komponenten beim Aufbau von XDR-Netzwerken.
Gleichzeitig müssen sich Glasfaserverkabelung, Rack-Design und Kühlsysteme ebenfalls an die Bereitstellungsanforderungen höherer Dichte und höherer Bandbreite anpassen. Es ist absehbar, dass sich Netzwerk-Upgrades in KI-Rechenzentren in den kommenden Jahren weitgehend um das 800G-Interconnect-Ökosystem drehen werden.
Fazit
Da die Größen von KI-Modellen weiter wachsen, sind Netzwerke zu einem entscheidenden Faktor für die Trainingseffizienz geworden. Als neueste Generation der InfiniBand-Technologie bietet XDR durch seine Bandbreite von 800G und 1.6T, seine latenzarme Architektur und seine hervorragende Skalierbarkeit eine effizientere Interconnect-Plattform für zukünftige Hyperscale-GPU-Cluster. In der fortlaufenden Weiterentwicklung der KI-Infrastruktur wird erwartet, dass XDR zu einer der Schlüsseltechnologien wird, die die Entwicklung von intelligenten Rechenzentren der nächsten Generation vorantreiben.


Teilen
