


Was ist Supercomputing der nächsten Generation?
Autor Moore
Datum 07/07/2026

Der Schwerpunkt des Supercomputing verlagert sich allmählich von der bloßen Steigerung der Rechenleistung hin zur tiefen Integration verschiedener Rechenparadigmen. Als wichtiger Treiber der Branche hat NVIDIA seine wissenschaftliche Computing-Plattform der nächsten Generation vorgestellt, die auf Simulation, KI (Künstliche Intelligenz) und Quantencomputing basiert. Durch innovative Lösungen wie die Vera CPU, proprietäre optische Hochgeschwindigkeits-Interconnect-Technologie und das vortrainierte physikalische Modell Apollo strebt NVIDIA danach, ein einheitliches Computing-Framework zu schaffen, das Leistung, Energieeffizienz und Skalierbarkeit in Einklang bringt und neue Infrastrukturunterstützung für zukünftige wissenschaftliche Forschung und groß angelegte KI-Anwendungen bietet.
Die drei wichtigsten Computing-Paradigmen konvergieren
In den letzten Jahrzehnten hat sich die Entwicklung des Supercomputing hauptsächlich auf numerische Simulationen gestützt, um wissenschaftliche Forschung und technische Innovation durch das Lösen komplexer physikalischer Gleichungen voranzutreiben. Die rasanten Fortschritte in der künstlichen Intelligenz und im Quantencomputing bedeuten jedoch, dass sich zukünftige Supercomputing-Plattformen von Einzelrechnerarchitekturen hin zu vielfältigeren, konvergenten Architekturen bewegen.
Eine der wichtigsten Aufgaben des High-Performance-Computing ist die wissenschaftliche Simulation. Traditionelle numerische Simulationen werden weiterhin für wichtige Berechnungen in Bereichen wie Klimavorhersage, Materialforschung und -entwicklung sowie Strömungsdynamikanalyse eingesetzt. Aber KI kann vieles deutlich verbessern. Sie kann Aufgaben viel schneller erledigen als zuvor. Sie kann Dinge erledigen, die früher lange gedauert haben.
Gleichzeitig wird künstliche Intelligenz zu einem wichtigen Produktivitätswerkzeug in der wissenschaftlichen Forschung. Von generativer KI bis hin zu AI for Science nutzen immer mehr Forschungseinrichtungen KI, um riesige Mengen experimenteller Daten zu verarbeiten, beim Modelltraining zu unterstützen und die Validierung von Forschungsergebnissen zu beschleunigen. KI ist nicht mehr nur eine Technologie auf Anwendungsebene, sondern wird schrittweise in den gesamten wissenschaftlichen Computing-Workflow integriert.
Quantencomputing stellt einen weiteren Entwicklungspfad dar, der Aufmerksamkeit verdient. Obwohl es sich noch in den frühen Phasen der Kommerzialisierung befindet, sind “quantenklassische Hybridarchitekturen”—bei denen Quantencomputing im Zusammenspiel mit traditionellem Hochleistungsrechnen arbeitet—zu einem zentralen Erkundungsbereich für die Branche geworden. In Zukunft könnten bestimmte Arten komplexer Probleme durch Quantencomputing beschleunigt werden, während traditionelle Computing-Plattformen weiterhin groß angelegte allgemeine Rechenaufgaben übernehmen werden.
Nach den aktuellen Trends zu urteilen, werden zukünftige Supercomputer nicht länger Rechenleistung stapeln; stattdessen werden sie durch die synergistische Integration von wissenschaftlicher Simulation, künstlicher Intelligenz und Quantencomputing eine neue Generation effizienterer und intelligenterer Computing-Plattformen aufbauen.
KI für die Wissenschaft bewegt sich rasch hin zu praktischen Anwendungen
In der Vergangenheit stützte sich die wissenschaftliche Forschung hauptsächlich auf numerische Simulationen, um die physische Welt zu rekonstruieren und vorherzusagen. Da die Datenmengen jedoch weiter wachsen, können traditionelle Berechnungsmethoden allein die Anforderungen der wissenschaftlichen Forschung zunehmend nicht mehr erfüllen. Heute entwickelt sich KI allmählich von einem unterstützenden Werkzeug zu einer zentralen Forschungsmethode, die nicht nur verändert, wie wissenschaftliche Probleme gelöst werden, sondern auch viele Forschungsergebnisse in Richtung praktischer Anwendungen vorantreibt.
In der Klimaforschung hat die Kombination aus KI und Hochleistungsrechnen bereits bemerkenswerte Effizienzsteigerungen gezeigt. Beispielsweise kann die auf dem Earth-2-Projekt basierende Klimasimulationsplattform der nächsten Generation das globale Klima mit einer Auflösung von 1 Kilometer modellieren und Simulationszyklen erheblich verkürzen. Rechenaufgaben, deren Abschluss früher beträchtliche Zeit in Anspruch nahm, liefern heute deutlich schneller Vorhersagen und bieten damit eine zeitnähere Datenunterstützung für Unwetterwarnungen und die Klimaforschung.
Strömungsdynamik ist ebenfalls eines der Gebiete, in denen die KI-Beschleunigung am deutlichsten ist. Herkömmliche CFD-Simulationen dauern oft Stunden oder sogar länger. Mithilfe von KI-Ersatzmodellen und dem Physics-NeMo-Framework wurden jedoch einige komplexe Strömungsfeldberechnungen auf nur wenige Sekunden verkürzt, wobei eine hohe Genauigkeit beibehalten wurde. Dieser Effizienzgewinn ist für die Luft- und Raumfahrt, das Automobildesign und die industrielle Fertigung von erheblichem Wert.
In der Kernfusionsforschung ist die Digital-Twin-Technologie eine neue Entwicklung. Durch die Kombination von Omniverse mit KI-Modellen können Forscher digitale Repliken von Fusionsreaktoren in Echtzeit erstellen und Veränderungen des Plasmazustands sehr schnell vorhersagen. Dies hilft, Experimente effizienter zu gestalten, und schafft einen neuen Weg, die zukünftige Kommerzialisierung der Fusionsenergie zu erkunden.
KI-Technologie wird auch häufig eingesetzt, um Erdbeben und Tsunamis vorherzusagen. Mithilfe von Informationen über frühere seismische Aktivitäten können große KI-Modelle potenzielle Risiken schnell erkennen und die Wahrscheinlichkeit eines Tsunamis im jeweiligen Moment einschätzen. Diese Methode liefert Frühwarnungen, die den Menschen Zeit geben, die Auswirkungen einer Katastrophe zu verhindern oder zu verringern.
Gleichzeitig treibt “AI for Science” Upgrades der globalen wissenschaftlichen Forschungsinfrastruktur voran. Immer mehr nationale Forschungseinrichtungen bauen neue Supercomputing-Plattformen auf, die für KI konzipiert sind. So setzt beispielsweise Japans RIKEN ein System der nächsten Generation ein, das auf der NVIDIA Blackwell-Architektur basiert. Durch den koordinierten Betrieb von GPU-Clustern, Hochgeschwindigkeits-InfiniBand-Netzwerken und KI-Computing-Frameworks stellt dieses System eine einheitliche Computing-Plattform für wissenschaftliches Rechnen, Quantenforschung und KI-Training bereit.
Von der Wettervorhersage bis zur Energieerzeugung durch Fusion und von der Prüfung der Arbeitsweise von Branchen bis zur Warnung von Menschen vor Naturkatastrophen wird KI zunehmend in allen Bereichen der wissenschaftlichen Forschung eingesetzt. Anstatt Computer nur schneller zu machen, ist es wichtiger, die Art und Weise zu verändern, wie Wissenschaftler Entdeckungen machen. Sie ermöglicht es Forschern, komplexe Probleme kostengünstiger und schneller zu lösen und neue wissenschaftliche Ideen schneller in die Industrie zu bringen.
Die Hardwarearchitektur verändert sich
Zur Unterstützung der nächsten Generation des wissenschaftlichen Rechnens hat NVIDIA auch mehrere Anpassungen an der zugrunde liegenden Hardwarearchitektur vorgenommen. Nach dem auf der SC25 vorgestellten Supercomputing-Prototyp der nächsten Generation zu urteilen, werden künftige Systeme nicht mehr einfache Kombinationen aus CPUs und GPUs sein. Stattdessen werden sie sich schrittweise zu komplexen Plattformen entwickeln, die Quantenschnittstellen, optische Hochgeschwindigkeitsverbindungen und heterogene Rechenfähigkeiten integrieren.
Selbstentwickelte CPU: Vera- und Olympus-Kerne
Die neue Vera-CPU verwendet das spezielle Olympus-Kerndesign von NVIDIA, wodurch sie fast doppelt so schnell ist wie die alte Grace-Plattform. Darüber hinaus führt Vera ein LPDDR5X-Speichersystem ein, das für Rechenzentrumsumgebungen entwickelt wurde. Dieses System ist für Bandbreitennutzung und Energieeffizienz optimiert und bietet erweiterte Datenverarbeitungsfunktionen für KI-Training, wissenschaftliche Simulationen und hybride Rechenaufgaben.
CPO: Neudefinition der Rechenzentrumsverbindung
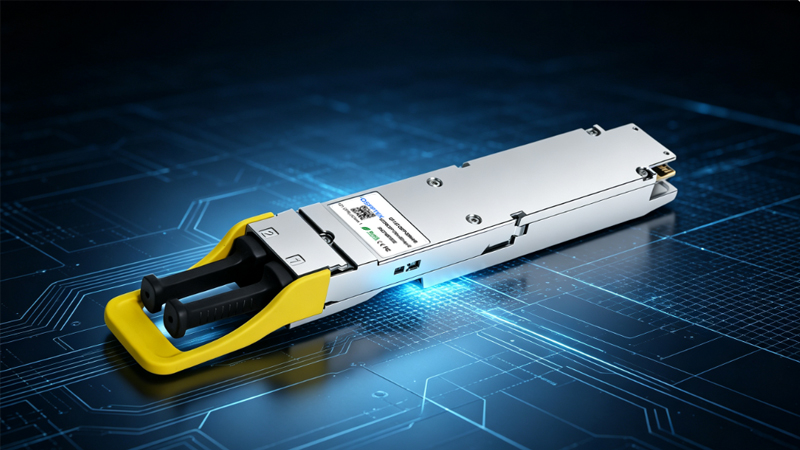
Da KI-Cluster weiter wachsen, stehen herkömmliche steckbare optische Module vor zunehmenden Herausforderungen in Bezug auf Stromverbrauch, Wartung und Ausfallraten. Als Reaktion darauf hat NVIDIA einen anderen Entwicklungsweg gewählt—die Integration der optischen Engine direkt in dasselbe Gehäuse wie den Switch-Chip.
CPO (Co-Packaged Optics) bedeutet mehr, als nur die Form optischer Module zu ändern. Es ist eine neue Art, das System als Ganzes zu entwerfen. CPO erreicht dies durch die Verkürzung des Übertragungswegs elektrischer Signale. Dadurch wird der Stromverbrauch reduziert und die Effizienz der Verbindungen verbessert. Insgesamt entsteht so eine Netzwerkinfrastruktur, die für künftige Hyperscale-KI-Cluster skaliert werden kann.
Gemäß den von NVIDIA’s angekündigten Plänen werden TACC, Lambda und CoreWeave zu den ersten gehören, die die Quantum-X Photonics-Plattform einsetzen, und die ersten sein, die diese Technologie auf KI- und Hochleistungsrechner-Infrastrukturen anwenden.
NVLink: Ermöglicht Hunderten von GPUs, als eine einzige Einheit zu arbeiten
Die durch die Blackwell-Architektur erzielte deutliche Verbesserung der Inferenzleistung ist nicht ausschließlich auf Optimierungen der FP4-Präzision zurückzuführen. Ein noch wichtigerer Faktor ist die kontinuierliche Weiterentwicklung der NVLink-Verbindungstechnologie.
Mit der neuesten Generation von NVLink können bis zu 576 GPUs zu einer einheitlichen Computing-Domäne mit gemeinsamem Speicher verbunden werden, sodass sie eher wie ein einziges großes Computersystem zusammenarbeiten können als wie eine einfache Ansammlung von Hunderten unabhängiger Knoten.
Für das Training und die Inferenz großer Modelle bestimmt die Effizienz des Datenaustauschs zwischen GPUs häufig die Obergrenze der Gesamtleistung. Da die Modellgrößen weiter wachsen, wird die Netzwerkbandbreite genauso wichtig wie die Rechenleistung selbst. Aus diesem Grund ist NVLink zu einer der Schlüsseltechnologien geworden, die groß angelegte KI-Infrastrukturen untermauern.
Apollo: KI-Physikmodelle treten in die Pre-Training-Ära ein
Neben Hardware-Upgrades entwickelt sich auch das Software-Ökosystem parallel weiter.
Auf der SC25-Konferenz stellte NVIDIA offiziell die Apollo-Serie von KI-Physikmodellen vor, die mehrere Bereiche des wissenschaftlichen Rechnens abdeckt, darunter Strömungsdynamik und Strukturmechanik. Die Einführung von Apollo bedeutet, dass sich die technische Simulation allmählich vom traditionellen Ansatz des “Modellierens von Grund auf” zu einem Modell aus “Vortraining + Feinabstimmung” verschiebt, ähnlich dem großer Sprachmodelle.
Apollo integriert wichtige KI-Physik Fortschritte, darunter neuronale Operatoren, Transformer-Architekturen und Diffusionsmodelle. Außerdem nutzt es während des Trainings umfangreiches physikalisches Vorwissen.
Entwickler können die offiziell bereitgestellten vortrainierten Modelle nicht nur direkt nutzen, sondern auch ein sekundäres Training und kundenspezifische Entwicklungen auf Basis ihrer eigenen Szenarien durchführen, wodurch die Einstiegshürde für den Aufbau wissenschaftlicher Rechenmodelle deutlich gesenkt und der Übergang wissenschaftlicher Forschungsergebnisse vom Labor in praktische Anwendungen beschleunigt wird.
In gewisser Weise führt Apollo das wissenschaftliche Rechnen in eine Entwicklungsphase, die der generativen KI ähnelt—Forscher müssen Modelle nicht mehr jedes Mal von Grund auf neu erstellen. Dennoch können sie es. Stattdessen können sie schnell iterieren und innovieren, indem sie auf bestehenden Grundlagen aufbauen.
Quantencomputing: Heterogene Integration könnte zum Computing-Paradigma der nächsten Generation werden
Wenn es um Quantencomputing geht, besteht der Ansatz von NVIDIA nicht darin, traditionelle Computerplattformen durch Quantensysteme zu ersetzen, sondern vielmehr darin, Quantenprozessoren zusammen mit GPUs als Schlüsselkomponente zukünftiger Supercomputing-Architekturen arbeiten zu lassen.
Kollaboratives Computing mit GPU und QPU
Laut NVIDIA fungiert die QPU (Quantum Processor Unit) als spezialisierter Beschleuniger, der die GPU ergänzt. Über die einheitliche CUDA-Q-Softwareplattform können Entwickler Quanten- und klassische Rechenaufgaben in derselben Entwicklungsumgebung planen, sodass diese beiden Arten von Rechenressourcen bei komplexen Aufgaben zusammenarbeiten können.
Das bedeutet, dass Forschende nicht zwei separate Entwicklungssysteme pflegen müssen: Sie können Quantenalgorithmen entwerfen, Simulationsverifizierungen durchführen und Simulationen innerhalb eines einheitlichen Frameworks ausführen. Dadurch wird es für Menschen wesentlich einfacher, sich mit Quantencomputing zu beschäftigen.
NVQLink: Eine Brücke zwischen Quanten- und klassischem Computing
Um Quantenprozessoren und GPUs die Zusammenarbeit zu erleichtern, hat NVIDIA NVQLink entwickelt, das beide verbindet. Diese Technologie ist für die Verbindung von QPUs und GPUs unerlässlich und unterstützt groß angelegte Quantencomputing-Workflows, die von CUDA-Q gesteuert werden.
Bei gemeinsamen Tests mit Quantinuum’s Quantenprozessor Helios der nächsten Generation erreichte NVQLink eine latenzarme Verbindung zwischen GPU und QPU und validierte erfolgreich die weltweit erste Echtzeit-Decodierung skalierbarer qLDPC-Quantenfehlerkorrekturcodes.
Die Testergebnisse zeigen, dass die Systemtreue mit vorhandenen Fehlerkorrekturmechanismen bei etwa 99% gehalten werden kann, was besser ist als 95% ohne Fehlerkorrektur. Dies zeigt, dass Quantenfehlerkorrekturtechnologie in der Praxis tatsächlich nützlich ist und dass Quantencomputing zusammen mit herkömmlichem High-Performance-Computing eingesetzt werden kann.
Angesichts des aktuellen Entwicklungsstands hat Quantencomputing noch einen langen Weg vor sich, bevor es eigenständig in großem Maßstab eingesetzt werden kann; es hat jedoch bereits begonnen, als Coprozessor für GPUs bei komplexen wissenschaftlichen Rechenaufgaben praktischen Wert zu zeigen. Zukünftige Supercomputing-Systeme werden wahrscheinlich nicht länger ein Wettbewerb zwischen einzelnen Architekturen sein, sondern heterogene konvergente Plattformen, die aus CPUs, GPUs und QPUs bestehen.
Fazit
In Zukunft werden Supercomputer mit einer Mischung aus CPU- und GPU-basierten Designs sowie Hybridsystemen gebaut, die wissenschaftliche Simulation, künstliche Intelligenz und Quantencomputing kombinieren. Technologien wie die Vera CPU, CPO Optical Interconnect, die Blackwell-Architektur und NVLink/NVQLink tragen dazu bei, die Bandbreite zu erhöhen, die Latenz zu reduzieren und die Zusammenarbeit von Ressourcen zu erleichtern. Gleichzeitig verändern wissenschaftsorientierte KI-Plattformen wie Apollo die Art und Weise, wie wir Dinge tun. Sie verwenden bereits trainierte physikalische Modelle, um traditionelle Methoden zu unterstützen.


Teilen
