


Entraînement de l’IA et inférence de l’IA : pourquoi ils exigent des architectures réseau différentes
Auteur Moore
Date 08/03/2026

À mesure que les entreprises accélèrent l'adoption de l'IA, l'entraînement et l'inférence de l'IA apparaissent de plus en plus dans une même stratégie d'infrastructure. Cependant, les traiter comme des charges de travail similaires peut facilement entraîner des écueils dans la planification du réseau. En réalité, la différence entre l'entraînement et l'inférence va bien au-delà du niveau applicatif ; ils correspondent à des objectifs de performance, des caractéristiques de trafic et des priorités opérationnelles complètement différents. Cela signifie qu'une architecture réseau ne peut pas s'appuyer sur un modèle unique de planification du trafic pour gérer simultanément ces deux aspects.
Qu’est-ce que l’entraînement de l’IA ?
L’entraînement d’une IA consiste à construire et à améliorer continuellement un modèle depuis le début, à l’aide d’une grande quantité de données et de calculs répétés. L’objectif est simple : dans un environnement distribué de grande envergure, il s’agit d’améliorer la précision du modèle tout en réduisant au minimum la durée d’entraînement.
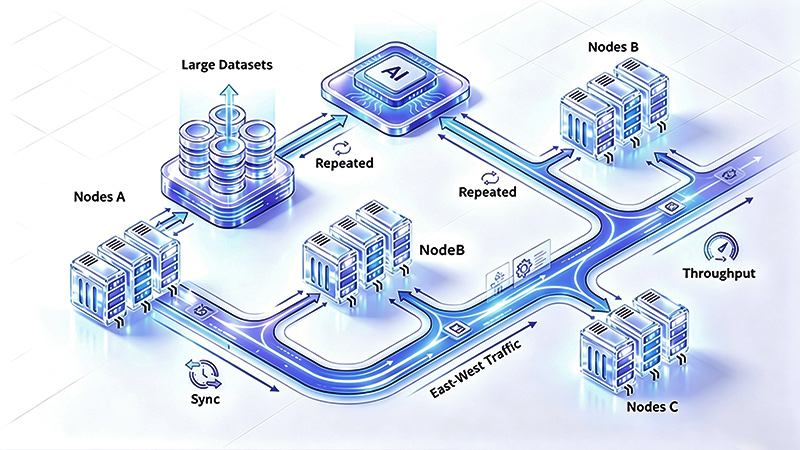
Dans la plupart des cas, l’entraînement de l’IA génère beaucoup de trafic réseau entre les GPU, les serveurs et les clusters. Ce type de charge de travail dépend fortement d’une bande passante suffisante, de bons mécanismes de synchronisation et d’un débit prévisible. Ainsi, lorsqu’ils conçoivent des réseaux pour des environnements d’entraînement, ils se concentrent généralement sur le maintien des pipelines de données à pleine capacité, l’élimination des goulets d’étranglement de communication et la prise en charge du calcul parallèle à grande échelle au sein de l’infrastructure IA globale.
Qu’est-ce que l’inférence IA ?
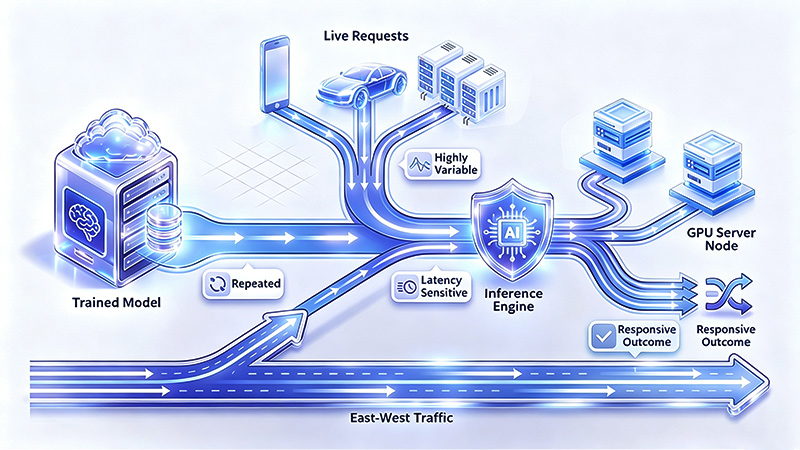
En bref, l’inférence IA consiste à déployer un modèle entraîné dans des situations réelles—pour recevoir et traiter des requêtes immédiates et fournir des résultats en temps réel ou quasi réel. À ce stade, l’objectif n’est plus de rendre le modèle lui-même plus intelligent, mais de fournir aux utilisateurs ou aux applications de couche supérieure des services de réponse rapides, stables et facilement évolutifs.
Par rapport à la phase d’entraînement, l’inférence implique un trafic réseau beaucoup plus dynamique et irrégulier. Le trafic peut être stable à un instant, puis connaître une forte hausse l’instant suivant, ce qui entraîne une pression élevée liée à la concurrence et une sensibilité extrême à la latence. Dans ce contexte, les critères de mesure des performances réseau ont évolué : plutôt que de viser simplement un débit constamment élevé, on privilégie la rapidité de réponse du système, la stabilité de la qualité de service et la capacité à gérer diverses pointes de trafic dans un environnement distribué centre de données sont devenus des indicateurs plus critiques.
Entraînement de l'IA ou inférence de l'IA : quelles sont les différences en matière d'exigences réseau ?
Avant d'aborder la conception d'une architecture réseau spécifique, comparons l'entraînement de l'IA et l'inférence de l'IA selon plusieurs dimensions fondamentales. Bien que les deux relèvent de la même infrastructure d'IA, leurs objectifs de performance, leurs caractéristiques de trafic et leurs priorités opérationnelles sont complètement différents. Comprendre ces différences explique pourquoi une stratégie unique de planification réseau a peu de chances de gérer efficacement ces deux aspects simultanément.
Pourquoi différentes charges de travail nécessitent-elles des priorités de planification différentes ?
Comprendre la différence entre l’entraînement et l’inférence de l’IA ne consiste pas seulement à les étiqueter. La contradiction la plus importante est que ces deux tâches orientent le réseau dans des directions d’optimisation complètement différentes.
Commençons par examiner l’entraînement de l’IA. Le réseau doit être capable de gérer des communications à long terme et à haut volume entre les ressources informatiques. Si la planification du trafic est mauvaise, la conséquence la plus directe est que la puissance de calcul des GPU n’est pas pleinement utilisée, que les cycles d’entraînement sont prolongés et que l’infrastructure durement acquise est gaspillée. Les exigences essentielles du réseau d’entraînement sont donc très claires— : viser un débit élevé, une équité dans la planification des gros volumes et une efficacité de transmission constamment stable.
Mais avec l’inférence IA, la situation change considérablement. Ici, le trafic est directement destiné aux utilisateurs ou aux applications, et la latence ainsi que les fluctuations deviennent les principaux problèmes. Il est impossible d’appliquer simplement à l’inférence la même logique de planification que celle utilisée pour l’entraînement à grande échelle. Si le réseau traite tout le trafic de la même manière, les temps de réponse deviendront imprévisibles en cas de trafic important ou de pics soudains.
C'est pourquoi la différence entre l'entraînement et l'inférence doit être prise en compte au niveau de la conception du réseau, plutôt que d'être traitée comme une catégorie métier. Lorsque les objectifs de performance changent, la logique de planification sous-jacente doit naturellement être modifiée elle aussi.
Comment la planification du réseau peut-elle correspondre précisément aux exigences de charge de travail de l’IA ?
Des caractéristiques de charge différentes déterminent directement des stratégies différentes de planification du trafic.
Dans les scénarios d’entraînement de l’IA, les stratégies d’ordonnancement doivent privilégier un traitement prévisible des flux, un équilibrage efficace de la charge et une utilisation extrêmement élevée du réseau. En bref, il s’agit de déplacer en continu d’énormes quantités de données entre des nœuds de calcul distribués sans provoquer de congestion. Ce type de trafic n’est pas sensible à la micro-latence d’une seule requête, mais il est extrêmement exigeant en matière d’efficacité globale des communications sur de longues périodes.
L’inférence d’IA est un tout autre domaine. Sa planification du trafic doit être flexible et réactive. Le réseau doit traiter rapidement un volume important de trafic et rester stable même lorsqu’il y a beaucoup de requêtes. Cela implique non seulement une transmission rapide, mais aussi une réduction de la latence et de la variabilité des performances.
En définitive, les différences de logique de planification entre l'entraînement et l'inférence peuvent être résumées en deux orientations fondamentales :
Entraînement de l'IA : L’objectif est de maximiser le débit du réseau grâce à des flux de données stables et à une transmission efficace.
Inférence IA : L’accent est mis sur la minimisation de la latence de transmission grâce à une réponse rapide et à une adaptation aux augmentations soudaines du trafic.
Pour les architectes concevant des infrastructures d'IA, clarifier cette limite est une tâche essentielle et fondamentale qui ne peut être contournée.
Quels éléments doivent être prioritaires dans la conception d’une infrastructure d’IA ?
Après avoir clarifié les différences entre l’entraînement et l’inférence, l’étape suivante consiste à traduire ces caractéristiques en priorités spécifiques de conception architecturale. En bref, l’objectif n’est plus de réitérer les différences entre les deux, mais de déterminer comment l’architecture réseau doit être mise en œuvre dans des déploiements pratiques.
Plusieurs considérations clés incluent :
S’aligner étroitement sur les caractéristiques de l’activité : La conception du réseau doit d'abord identifier le type de charge dominant ; évitez d'essayer d'appliquer une architecture unique à tous les cas Entreprise d’IA.
Correspondance de planification précise : Les stratégies de planification du trafic doivent s’aligner sur les schémas de comportement de la charge afin de garantir que les stratégies réseau répondent réellement aux objectifs de performance des applications.
Coordination globale des ressources : Lors de la planification du réseau, la puissance de calcul, le trafic et le comportement de transmission doivent être considérés de manière globale dans l’infrastructure d’IA, en examinant leurs interactions.
Maintenir la flexibilité opérationnelle : Avec la prévalence croissante de la combinaison de l’entraînement et de l’inférence, le système réseau doit pouvoir ajuster de manière flexible les stratégies et les performances dans des environnements à charge mixte.
Pour les topologies réseau orientées vers l'entraînement, la conception de réseau sans perte RoCE offre une référence très pratique pour une transmission tenant compte de la congestion.
Conclusion
Considérer l’entraînement de l’IA et l’inférence de l’IA comme deux charges de travail réseau distinctes est un prérequis essentiel pour une planification efficace de l’architecture. Les différences vont bien au-delà de l’étape du modèle dans son cycle de vie ; elles ont un impact direct sur les priorités de performance, les caractéristiques du trafic et les exigences spécifiques de planification.
En fin de compte, les discussions sur l'entraînement et l'inférence nous rappellent que la conception du réseau doit s'adapter au monde des affaires. L'entraînement dépend du débit, tandis que l'inférence est très sensible à la latence. Les stratégies de planification du trafic doivent donc être personnalisées pour répondre à ces besoins spécifiques. Si vous êtes une entreprise qui cherche à construire une infrastructure d'IA évolutive, c'est essentiel pour prendre des décisions précises et efficaces en matière de réseau.


Partager
