


Libérer le potentiel du 1.6T XDR : la nouvelle pierre angulaire du supercalculateur IA de nouvelle génération
Auteur Moore
Date 08/28/2026

À mesure que l'entraînement de modèles d'IA à grande échelle et les modèles comportant des milliers de milliards de paramètres deviennent la norme, les goulots d'étranglement des infrastructures d'IA se déplacent—de la puissance de calcul pure vers l'interconnexion réseau. Alors que les GPU évoluent à un rythme soutenu, le trafic est-ouest massif généré par l'entraînement distribué augmente encore plus rapidement. Par conséquent, la bande passante réseau, la latence et l'évolutivité sont devenues les principaux facteurs déterminant l'utilisation globale des ressources de calcul de l'ensemble du cluster.
La technologie réseau a évolué du HDR 200G au NDR 400G et 800G, et aujourd’hui, les contours de l’évolution de nouvelle génération sont déjà assez clairs : une architecture d’interconnexion 1.6T reposant sur une technologie de signal monocanal 200G s’impose progressivement. En combinant la photonique sur silicium, des DSP avancés et une technologie d’interconnexion optique haute densité, l’InfiniBand XDR 1.6T est appelé à jouer un rôle central dans la prise en charge des futurs clusters de supercalcul IA.
Les clusters d’IA font évoluer les réseaux de 800G NDR vers 1.6T XDR
Défis réseau rencontrés par les clusters d’IA hyperscale
Aujourd’hui’s, l’entraînement distribué de l’IA nécessite souvent que des milliers, voire des dizaines de milliers de GPU, travaillent en parallèle. La synchronisation des paramètres à très grande échelle, l’agrégation des gradients et les communications fréquentes entre clusters génèrent une quantité considérable de trafic réseau est-ouest au sein des centres de données.
À mesure que la taille des clusters continue d'augmenter, les réseaux HDR et NDR existants commencent à présenter des goulots d'étranglement, principalement dans les domaines suivants :
Contraintes de bande passante : face aux exigences de communication à haut débit des vastes réseaux de GPU, les liaisons 400G peinent déjà à suivre, ce qui peut entraîner l'inactivité des ressources de calcul et une baisse de l'utilisation globale.
Limitations de la distance de transmission : les solutions optiques SR multimodes traditionnelles offrent des distances de couverture relativement courtes, ce qui limite directement la flexibilité des centres de données hyperscale en matière d’agencement des racks et de planification de l’espace.
Les deux défis de la consommation d'énergie et de l'intégrité du signal : l'augmentation du débit du signal électrique pour accroître le débit utile entraîne une forte hausse de la consommation d'énergie et exerce une pression importante sur la gestion thermique, tout en posant de sérieux défis pour le contrôle du taux d'erreur binaire (BER).
Les réseaux InfiniBand se sont améliorés et accélérés au cours des 20 dernières années afin de faire face à ce type de problèmes. À chaque transition générationnelle, ils ont réalisé des progrès majeurs en matière de débit, tout en intégrant continuellement des technologies SerDes plus rapides et des architectures d’interconnexion sous-jacentes plus performantes.
Paramètres de référence de la technologie de base conformes aux normes industrielles pour le XDR 1.6T
Le cœur de ce saut générationnel réside dans la mise à niveau complète des signaux électriques de 100G SerDes à 200G. En doublant la bande passante par canal—tout en intégrant une technologie DSP avancée et une architecture de boîtier améliorée—la plateforme XDR de nouvelle génération peut augmenter considérablement la limite supérieure du débit global du réseau sans accroître de manière significative la complexité du système.
Technologies sous-jacentes clés prenant en charge le XDR 1.6T
Augmenter la bande passante ne suffit pas. Pour Interconnexions 1,6T pour fonctionner réellement, ils doivent évoluer ensemble dans de nombreux domaines, comme le packaging optique, le traitement du signal par DSP, la conception de la gestion thermique et les puces de commutation de bas niveau, pour n’en citer que quelques-uns.
Analyse approfondie de l’architecture matérielle full-stack : 1.6T XDR contre 800G NDR
Pour construire un réseau d'IA haute performance, il est loin d'être suffisant de simplement mettre à niveau les puces des commutateurs. L'ensemble de l'infrastructure d'interconnexion doit reposer sur le fonctionnement coordonné des modules optiques, des câbles en cuivre DAC à connexion directe, des câbles optiques actifs AOC et des composants d'interconnexion de dérivation afin de répondre aux exigences strictes liées aux différentes distances de transmission.
Des GPU à l'intérieur du rack aux interconnexions des commutateurs, puis aux liaisons dorsales longue distance reliant différents centres de données, chaque composant joue un rôle indispensable dans le soutien d'un réseau hautement évolutif.
Matrice des produits de modules optiques : de 800G NDR à la photonique sur silicium 1.6T
Pour les connexions à moyenne et longue distance dans les centres de données dédiés à l'IA, les modules optiques restent la solution privilégiée. Selon la distance que le signal doit parcourir et le type de fibre, le secteur les répartit généralement en trois catégories : solutions multimodes SR (courte portée), solutions monomodes DR (classe centre de données) et solutions monomodes FR (longue portée).
À mesure que les débits de données approchent 1,6T, la technologie de photonique sur silicium (SiPh) devient de plus en plus importante. Intégrer directement des fonctions optiques sur une plateforme à base de silicium change complètement la donne pour la photonique sur silicium. Cela présente de nombreux avantages.
Densité d’intégration accrue
Consommation d’énergie réduite
Une meilleure évolutivité pour la production de masse
Plus de flexibilité pour la gestion thermique
Grâce à ces caractéristiques, la technologie de photonique sur silicium est devenue l’une des principales voies pour le déploiement futur à grande échelle de réseaux 1.6T.
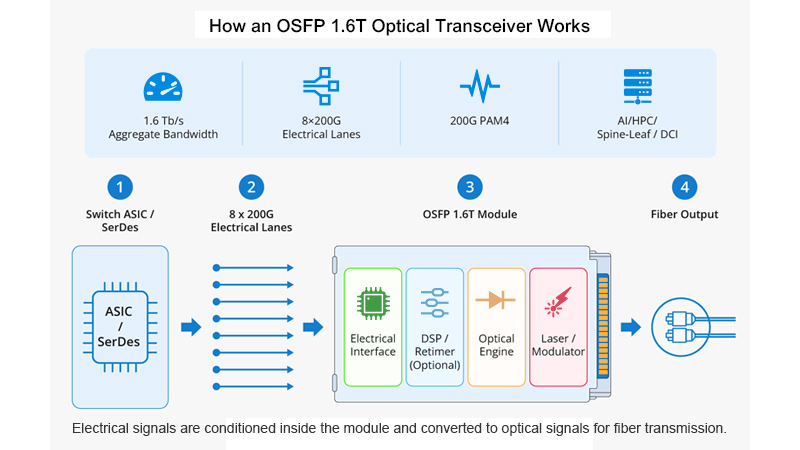
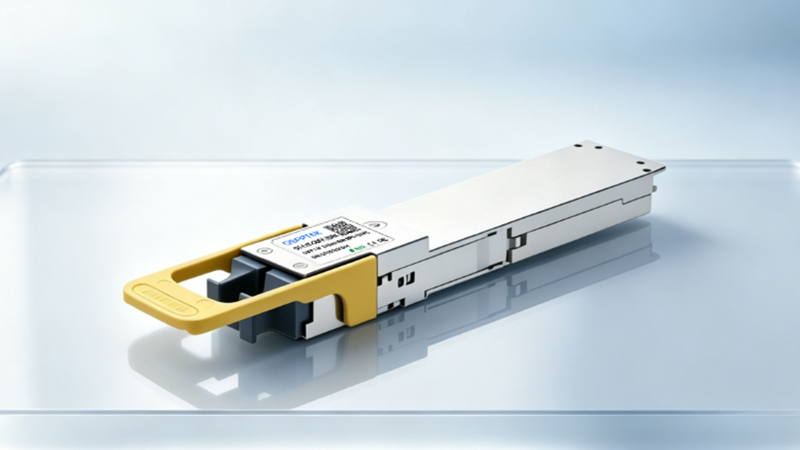
1.6T XDR OSFP DR8 (solution photonique sur silicium monomode 1310 nm)
La longueur d’onde de fonctionnement est de 1310 nm et il utilise une transmission par fibre monomode.
La distance de transmission typique peut atteindre 500 mètres.
Doté d’une conception à double interface MPO
Architecture parallèle à 8 canaux, avec un débit de données d’environ 200G par canal
Applications typiques : interconnexions de backbone entre les commutateurs d'IA de nouvelle génération et déploiement de réseaux fabric pour les clusters d'IA hyperscale.
Série 800G NDR OSFP
SR8 (multimode 850 nm) : il utilise des fibres OM3 et OM4 pour établir des connexions haut débit sur de courtes distances à l'intérieur des centres de données.
FR8 (monomode 1310 nm) : Il peut transmettre sur de longues distances, voire plusieurs kilomètres, ce qui permet d’établir des connexions longue distance entre des bâtiments et des campus.
Série 400G NDR OSFP / QSFP56
Propose des architectures éprouvées telles que SR4, DR4 et FR4
Permet une évolution et une transition fluides depuis les réseaux HDR
Largement déployé du côté de l'accès aux serveurs et dans les réseaux de couche d'accès.
Matrices de câbles haut débit : solutions d'interconnexion DAC et AOC
Ces câbles sont principalement utilisés pour connecter des serveurs GPU et des commutateurs dans le même rack. Parmi les types les plus courants figurent les câbles en cuivre passifs (DAC), les câbles optiques actifs (AOC) et les câbles répartiteurs (1 vers 2 ou 1 vers 4). Ces câbles sont populaires pour les connexions sur de courtes distances dans les clusters d’IA, car ils sont abordables et permettent un câblage haute densité.
Câbles en cuivre DAC passifs à connexion directe (interfaces OSFP / QSFP56) : ces câbles ne contiennent aucune puce de traitement du signal à leurs extrémités et reposent entièrement sur un support en cuivre pour la transmission pure de signaux électriques, offrant les avantages d’une consommation d’énergie ultra-faible et d’un faible coût. Les longueurs courantes sont principalement de 1 mètre et 3 mètres, et ils sont spécifiquement conçus pour les interconnexions internes de baies allant de 1 à 3 mètres. Les formes de produit comprennent des câbles droits standard, des répartiteurs de type Y 1 vers 2 et des répartiteurs 1 vers 4, qui permettent une extension flexible et économique des nœuds multi-GPU en répartissant la bande passante d’un seul port.
Câbles AOC actifs : ces câbles intègrent des puces de conversion optoélectronique aux deux extrémités et utilisent une fibre optique pour la transmission au milieu, éliminant complètement les limitations physiques de distance de transmission des câbles en cuivre. Parmi eux, l'AOC HDR 200G prend en charge des distances de transmission allant jusqu'à 100 mètres, tandis que l'AOC NDR 400G peut couvrir des distances de plusieurs dizaines de mètres ; ils sont principalement utilisés pour les interconnexions haut débit entre racks adjacents.
Câbles breakout : ils prennent en charge des spécifications de conversion, telles que OSFP vers 2×QSFP56 ou OSFP vers 4×OSFP, permettant de diviser un seul port 800G en plusieurs liaisons descendantes 200G/400G. Ils sont parfaits pour une mise en réseau flexible dans divers clusters d'IA et peuvent réduire considérablement le nombre de ports de commutateur inactifs et gaspillés.
À travers trois générations : l'évolution du matériel réseau
Du HDR au NDR, et maintenant au XDR, le saut technologique impliqué va bien au-delà du simple doublement des chiffres de bande passante. À chaque génération d’évolution, la modulation du signal sous-jacente, l’architecture DSP, les conceptions de packaging optique et la consommation électrique globale ont toutes fait l’objet d’une refonte complète.
Les principales différences entre ces trois générations d'architectures matérielles se reflètent principalement dans ces métriques clés.
La valeur pratique des réseaux XDR 1,6T dans les clusters de supercalculateurs IA
Augmente considérablement l’utilisation de la puissance de calcul des GPU
Grâce à l’architecture à latence ultra-faible combinant le RDMA 1.6T et InfiniBand, la latence de communication entre les GPU a été réduite à l’ordre de la microseconde. Dans l’entraînement distribué de modèles de grande taille, l’utilisation effective de la puissance de calcul des clusters de GPU peut passer directement d’environ 40 % à 75 %–80 %, réduisant considérablement le cycle d’entraînement des modèles comportant des milliers de milliards de paramètres. Si les clusters NDR 800G existants sont mis à niveau et remplacés par un réseau dorsal XDR, l’efficacité globale d’entraînement de l’ensemble du cluster devrait augmenter de plus de 40 %.
Optimiser les coûts du câblage et de l’infrastructure du centre de données
Réduction du nombre total de ports de commutateur : avec deux fois plus de bande passante par port, le nombre de ports requis par un commutateur est réduit de 50 % tout en prenant en charge la même capacité de calcul, ce qui réduit considérablement l'espace occupé dans les racks, les charges de distribution électrique et les coûts de refroidissement.
Distance de transmission étendue : les modules de la série DR/FR monomode 1310nm prennent en charge des distances de transmission allant de 500 mètres à 2 kilomètres. Cette distance est supérieure aux contraintes imposées par la fibre multimode 850nm dans les configurations physiques des centres de données. Il est ainsi plus facile de répartir les racks et d'ajouter davantage de capacité dans les centres de calcul intelligent.
Efficacité énergétique supérieure de bout en bout : l’intégration de la photonique sur silicium avec une solution DSP 3 nm de nouvelle génération réduit la consommation d’énergie par Gbit/s de bande passante d’environ 25 % par rapport aux composants discrets classiques. Cela rend les coûts d’électricité beaucoup plus bas pour les clusters de calcul intensif qui utilisent 10 000 cartes et ont une charge élevée toute l’année.
Compatible avec les équipements réseau existants
Le protocole XDR 1.6T fonctionne avec le NDR 800G et le HDR 200G. Vous n’avez pas besoin de reconstruire complètement vos clusters 200G/400G. Il suffit de remplacer les commutateurs centraux et les modules optiques du backbone pour passer progressivement à 1.6T. Cela réduira vraiment les coûts des mises à niveau au départ.
Recommandations de sélection pour les scénarios courants
Les différents scénarios professionnels ont des exigences d’interconnexion différentes. Lors du choix du matériel, vous réfléchissez généralement à des éléments tels que la distance que le signal doit parcourir, la quantité de câblage nécessaire, le budget disponible et la nécessité éventuelle d’une extension ultérieure.
Sur la base des besoins réels des environnements professionnels courants, les solutions matérielles réseau recommandées pour différents scénarios sont résumées comme suit :
En conclusion
Si l'on considère les tendances technologiques générales du secteur, l'adoption de la photonique sur silicium continue de s'accélérer. À mesure que les débits réseau dépassent le seuil de 800G, la valeur de la photonique sur silicium pour réduire la consommation d'énergie et accroître l'intégration devient irremplaçable ; parallèlement, les réseaux 1.6T passent d'une planification prospective à un déploiement commercial concret et deviendront la norme pour l'entraînement de l'IA à haut débit dans les années à venir. Concernant les solutions à plus long terme telles que les optiques co-packagées (CPO), l&D enthousiasme reste élevé. Aujourd'hui comme dans un avenir prévisible, les modules optiques enfichables matures resteront largement majoritaires dans le secteur du déploiement.
Cela signifie également que le 1.6T représente l'étape clé la plus claire et la plus pragmatique de la mise à niveau actuelle de l'infrastructure d'IA. Cependant, pour que l'architecture 1.6T fonctionne réellement, il est loin d'être suffisant de simplement mettre à niveau le matériel des commutateurs ; cela nécessite les efforts coordonnés de tout un écosystème d'interconnexion englobant les modules optiques, les câbles haut débit et l'architecture réseau.
S'appuyant sur un portefeuille de produits complet couvrant les technologies 400G, 800G et la technologie émergente 1.6T— incluant des modules émetteurs-récepteurs à base de photonique sur silicium, des assemblages de câbles DAC/AOC haute densité et des solutions réseau axées sur l'IA— QSFPTEK s'engage à aider les utilisateurs à construire une infrastructure informatique hautement évolutive et performante, en assurant une transition plus stable et fluide de l'architecture NDR existante vers la prochaine génération d'AI Fabric 1.6T.


Partager
