


La photonique sur silicium et le CPO repoussent les limites des réseaux 1.6T
Auteur Leslie
Date 09/01/2026

La photonique sur silicium et les optiques co-packagées remodèlent l'infrastructure d'interconnexion des centres de données d'IA pour l'ère du 1.6T. À mesure que l'échelle de l'entraînement des grands modèles s'accroît, la demande en bande passante ultra-élevée au sein des clusters de GPU devient de plus en plus urgente. Les modules optiques enfichables traditionnels, à mesure qu'ils évoluent vers des gammes de fréquences plus élevées, atteignent des limites physiques en matière de performances thermiques et électriques, devenant ainsi un goulot d'étranglement critique qui limite la pleine exploitation de la puissance de calcul. L'adoption commerciale accélérée des technologies de photonique sur silicium et de CPO est appelée à lever fondamentalement la barrière de la consommation énergétique des réseaux de calcul intelligent de nouvelle génération.
Limites de consommation électrique des optiques enfichables
Les modules optiques enfichables traditionnels ont dominé les réseaux informatiques jusqu'à présent grâce à leur flexibilité de déploiement ; cependant, alors que les débits de données par voie unique atteignent 224 Gbit/s en PAM4, les limitations électriques inhérentes à leur architecture physique traditionnelle sont devenues flagrantes.
Dans les réseaux utilisant des modules optiques traditionnels, les signaux électriques à haut débit doivent parcourir les pistes du circuit imprimé de la carte mère—sur plus de dix centimètres—pour atteindre le panneau avant. À ces vitesses, la fréquence de Nyquist du signal atteint 56 GHz ; sur de telles distances, les signaux haute fréquence subissent un effet de peau et des pertes diélectriques importants, l'affaiblissement d'insertion du canal dépassant fréquemment 30 dB.
Pour compenser l'atténuation et la distorsion extrêmes du signal qui en résultent, les modules optiques traditionnels doivent intégrer des puces DSP hautes performances pour le traitement numérique du signal. Cela augmente considérablement la taille physique et la consommation électrique du module. Au niveau 1.6T, la consommation électrique d'un seul module approche les 30 W. Si un commutateur central 102.4T est entièrement équipé de modules optiques 1.6T, la chaleur générée par les seules interconnexions optiques atteint plusieurs kilowatts. Une densité de flux thermique aussi extrême rend les solutions traditionnelles de refroidissement par air intenables, tandis que la conception des plaques froides et des canalisations des systèmes de refroidissement liquide pose d'immenses défis techniques.
Évolution architecturale de la photonique sur silicium et du CPO
Pour surmonter les limitations physiques imposées par le routage de la carte mère, la photonique sur silicium et les architectures d’optiques co-packagées offrent une solution révolutionnaire en améliorant l’intégration des dispositifs et en raccourcissant les interconnexions électriques.
Les modules optiques traditionnels reposent sur des assemblages de composants optiques discrets, ce qui entraîne un boîtier volumineux et une forte perte du signal optique. En revanche, la photonique sur silicium exploite des procédés matures de semi-conducteurs CMOS pour miniaturiser et intégrer fortement les modulateurs, les détecteurs et les guides d'onde passifs sur une seule puce à base de silicium. Cette restructuration fondamentale des matériaux et des procédés élimine dès la source le besoin d'empiler des composants optiques complexes, permettant une miniaturisation extrême des dispositifs optoélectroniques et garantissant une grande homogénéité lors de la fabrication en série.
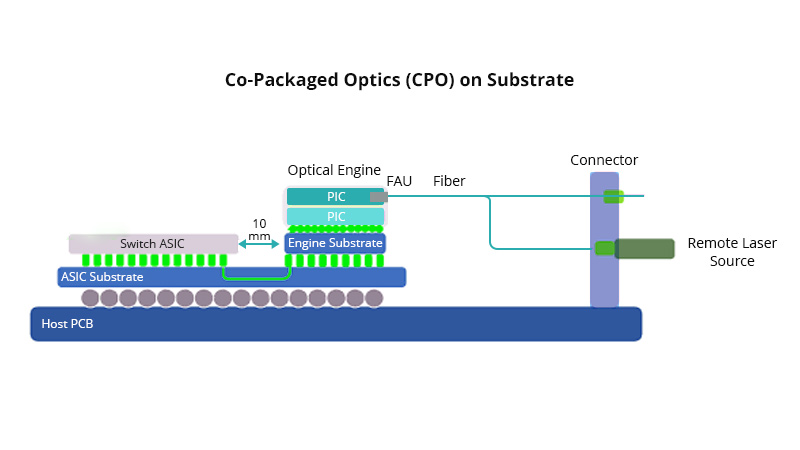
S'appuyant sur les niveaux élevés d'intégration atteints par la photonique sur silicium, le CPO reconfigure davantage la topologie physique de l'équipement. Le CPO utilise une technologie de packaging avancée pour intégrer dans un même substrat multicouche le moteur photonique sur silicium et l'ASIC de commutation réseau. Cette conception comprime considérablement le chemin de transmission physique des signaux électriques à haute vitesse—réduisant la distance de plus de dix centimètres sur la carte mère à seulement quelques millimètres au sein du substrat. Ces interconnexions ultra-courtes réduisent considérablement l'atténuation du canal, permettant au système d'adopter une architecture linéaire à entraînement direct à faible consommation et d'éliminer fondamentalement sa dépendance aux puces DSP énergivores.
Efficacité énergétique du système et densité de bande passante
Le passage de composants discrets à des solutions hautement intégrées à base de silicium—et de longues pistes de circuit imprimé à des interconnexions directes au niveau du substrat—a fondamentalement restructuré l'architecture sous-jacente, offrant des avantages système tangibles et multidimensionnels.
La percée la plus immédiate est une réduction significative de la consommation d'énergie par bit transmis. En éliminant les puces DSP énergivores, l'architecture CPO réduit de plus de 30% la consommation globale d'énergie de la liaison de communication. Parallèlement, la suppression du DSP élimine la latence de calcul inhérente au traitement numérique du signal. Dans le contexte des communications collectives pour l'entraînement distribué à grande échelle, cette capacité de transmission matérielle directe au niveau de la microseconde réduit considérablement les temps d'attente liés à la synchronisation entre les nœuds, ce qui augmente effectivement l'utilisation réelle des capacités de calcul des clusters de GPU.
Au niveau de la topologie, le CPO libère complètement l'espace sur le panneau avant du commutateur. La face avant de l'appareil n'a plus besoin d'accueillir de volumineux logements enfichables, ne conservant que des interfaces de fibre optique haute densité et des sources laser externes (ELS). Il devient ainsi possible d'atteindre un débit de commutation ultra-élevé supérieur à 102,4 Tbps dans un format 1RU ; cela simplifie non seulement les hiérarchies de réseau leaf-spine, mais réduit également considérablement la complexité du câblage en fibre optique pour les clusters comprenant des dizaines de milliers de GPU.
Solutions de photonique sur silicium 1.6T de QSFPTEK
Lors de la transition vers les architectures CPO, les modules enfichables haute performance basés sur la technologie de photonique sur silicium restent la base pratique pour augmenter la puissance de calcul. Pour répondre aux exigences des clusters de calcul IA à grande échelle, QSFPTEK a lancé le 1.6T OSFP224 et la série de modules photoniques en silicium 800G, utilisant un procédé à voie unique de 224 Gbit/s. Grâce à l'utilisation de puces photoniques en silicium hautement intégrées, ces produits à double débit réduisent considérablement à la fois le nombre de composants discrets et la consommation d'énergie opérationnelle. Soutenue par des tests rigoureux d'intégrité du signal, toute la gamme de produits photoniques en silicium haut débit de QSFPTEK’ garantit une interopérabilité stable de bas niveau avec les équipements réseau courants, facilitant une transition fluide des centres de données vers les architectures réseau de nouvelle génération.
Conclusion
Pour les nœuds réseau fonctionnant à 1.6T et au-delà, l'approche traditionnelle consistant à échanger une compensation accrue du signal électrique contre une bande passante supérieure a atteint ses limites physiques. Alors que les modules enfichables à haut débit—tels que l'OSFP224 1.6T—répondent aux besoins immédiats liés à l'augmentation de la puissance de calcul, la photonique sur silicium et les optiques co-packagées constituent les principales voies pour résoudre les défis à long terme liés à la consommation électrique des interconnexions. À mesure que les technologies d'intégration et de conditionnement photoniques fondées sur le silicium continuent de mûrir, les réseaux des centres de données progressent régulièrement vers une nouvelle ère de reconfiguration de l'infrastructure informatique, caractérisée par une architecture simplifiée et une efficacité énergétique élevée.


Partager
