


シリコンフォトニクスとCPOが1.6Tネットワークの限界を打ち破る
著者 Leslie
日付 09/01/2026

シリコンフォトニクスとコパッケージドオプティクスは、1.6T時代に向けてAIデータセンターの相互接続インフラを再構築しています。大規模モデルのトレーニング規模が拡大するにつれて、GPUクラスター内の超高帯域幅に対する需要はますます切迫しています。従来のプラガブル光モジュールは、より高い周波数帯域へ進化する中で、熱および電気性能に関する物理的限界に達しつつあり、計算能力の完全な実現を制約する重大なボトルネックとなっています。シリコンフォトニクスとCPO技術の商用導入の加速は、次世代インテリジェントコンピューティングネットワークの消費電力の壁を根本的に突破する可能性があります。
プラガブル光モジュールの消費電力制限
従来のプラガブル光モジュールは、その導入の柔軟性により、これまでコンピューティングネットワークを支配してきました。しかし、単一レーンのデータレートが224 Gbps PAM4へ急上昇するにつれて、従来の物理アーキテクチャに内在する電気的制約が著しく顕在化しています。
従来の光モジュールを利用するネットワークでは、高速電気信号はスイッチングチップからメインボード上の PCB 配線を通って—10 センチメートル超にわたり—フロントパネルに到達する必要があります。これらの速度では、信号のナイキスト周波数は 56 GHz に達します。このような距離では、高周波信号は深刻な表皮効果と誘電損失の影響を受け、チャネル挿入損失はしばしば 30 dB を超えます。
その結果生じる極端な信号減衰と歪みを補償するため、従来の光モジュールはデジタル信号処理用の高性能DSPチップを統合しなければなりません。これにより、モジュールの物理サイズと消費電力が大幅に増加します。1.6Tノードでは、単一モジュールの消費電力は30 Wに近づきます。102.4Tコアスイッチにフル実装した場合 1.6T光モジュール、光インターコネクトだけで発生する熱は数キロワットに達します。このような極端な熱流束密度により、従来の空冷ソリューションは持続不可能になり、一方で液冷システムのコールドプレート配置と配管設計には非常に大きなエンジニアリング上の課題があります。
シリコンフォトニクスと CPO のアーキテクチャ進化
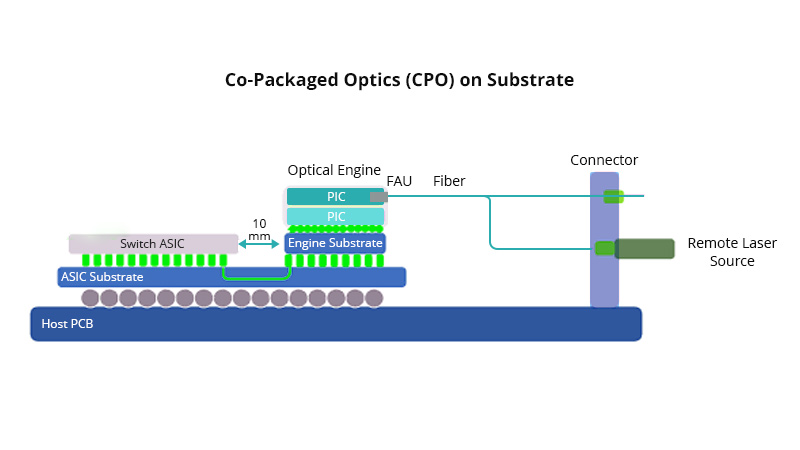
マザーボード配線によって課される物理的制限を克服するために、シリコンフォトニクスとCo-Packaged Opticsアーキテクチャは、デバイス統合を高め、電気インターコネクトを短縮することで、画期的なソリューションを提供します。
従来の光モジュールは個別光コンポーネントのアセンブリに依存しているため、パッケージが大型化し、光信号損失が大きくなります。これに対し、シリコンフォトニクスは成熟したCMOS半導体プロセスを活用して、変調器、検出器、受動導波路を単一のシリコンベースチップ上に高度に小型化・集積します。この材料とプロセスの根本的な再構築により、発生源で複雑な光コンポーネントの積層が不要になり、光電子デバイスの極限的な小型化が可能になり、量産における高い一貫性が確保されます。
シリコンフォトニクスによって実現された高い集積度を基盤として、CPOは機器の物理トポロジーをさらに再構成します。CPOは先進的なパッケージング技術を活用し、シリコンフォトニックエンジンとネットワークスイッチングASICを単一のマルチチップ基板上に同一パッケージで実装します。この設計により、高速電気信号の物理的な伝送経路が大幅に短縮され—マザーボード上の10センチメートル超から基板内のわずか数ミリメートルまで距離が短くなります。これらの超短距離の相互接続によってチャネル減衰が大幅に低減され、システムは低消費電力のリニアダイレクトドライブアーキテクチャを採用でき、電力消費の大きいDSPチップへの依存を根本的に排除できます。
システムのエネルギー効率と帯域幅密度
ディスクリート部品から高度に統合されたシリコンベースのソリューション—へ、そして長いPCB配線から基板レベルの直接インターコネクト—への移行は、基盤となるアーキテクチャを根本的に再構築し、多面的で具体的なシステム上の利点をもたらしました。
最も直接的なブレークスルーは、送信ビットあたりのエネルギー消費を大幅に削減できることです。消費電力の大きい DSP チップを排除することで、CPO アーキテクチャは通信リンク全体の消費電力を 30% 以上削減します。同時に、DSP を取り除くことで、デジタル信号処理に固有の計算レイテンシも解消されます。大規模分散トレーニングにおける集合通信の文脈では、このマイクロ秒レベルのハードウェアパススルー機能により、ノード間の同期待ち時間が大幅に短縮され、GPU クラスターの実際の計算利用率が効果的に向上します。
トポロジーレベルでは、CPOはスイッチのフロントパネル上のスペースを完全に解放します。デバイス前面は、かさばるプラガブルケージを収容する必要がなくなり、高密度光ファイバーインターフェースと外部レーザーソース(ELS)のみを保持します。これにより、1RUフォームファクター内で102.4 Tbpsを超える超高スイッチングスループットを実現することが可能になります。これは、リーフ・スパインネットワーク階層を簡素化するだけでなく、数万個のGPUで構成されるクラスターの光ファイバー配線の複雑さも大幅に低減します。
QSFPTEK 1.6T シリコンフォトニクスソリューション
CPOアーキテクチャへの移行期において、シリコンフォトニクス技術に基づく高性能プラガブルモジュールは、計算能力を拡張するための実用的な基盤であり続けています。大規模AIコンピューティングクラスターの需要に応えるため、QSFPTEKは次を発売しました 1.6T OSFP224 および800Gシリーズのシリコンフォトニクスモジュールで、シングルレーン224Gbpsプロセスを利用しています。高度に統合されたシリコンフォトニックチップを採用することで、これらのデュアルレート製品はディスクリート部品の数と運用時の消費電力の両方を大幅に削減します。厳格なシグナルインテグリティテストに裏付けられ、QSFPTEK’sの高速シリコンフォトニクス製品ラインアップ全体は、主流のネットワーク機器との安定した低レベルの相互運用性を確保し、データセンターの次世代ネットワークアーキテクチャへの円滑な移行を促進します。
結論
1.6T以上で動作するネットワークノードでは、帯域幅を高めるために電気信号補償を増やすという従来のアプローチは、物理的限界に達しています。1.6T OSFP224—などの高速プラガブルモジュール—は、計算能力の拡張に対する当面の需要に対応しますが、シリコンフォトニクスとコパッケージドオプティクスは、長期的な相互接続の消費電力課題を解決するための重要な道筋を示しています。シリコンベースのフォトニック集積およびパッケージング技術が成熟し続けるにつれて、データセンターネットワークは、アーキテクチャの簡素性と高いエネルギー効率を特徴とするコンピューティングインフラ再構成の新時代へと着実に進んでいます。


共有
